Agora mesmo, o Google lançou o Genie 4, e esses 120 segundos de demonstração visual me mostraram o futuro da IA
Este mundo só pode durar 120 segundos, após os quais tudo começa a desmoronar. No entanto, durante esses dois minutos, você pode mudar o clima, invocar dragões ou até mesmo fazer uma cidade surgir do nada.
O Google DeepMind acaba de lançar oficialmente seu modelo de mundo de próxima geração, o Genie 4, marcando mais um passo significativo para que os mundos virtuais gerados por IA se tornem realidade.
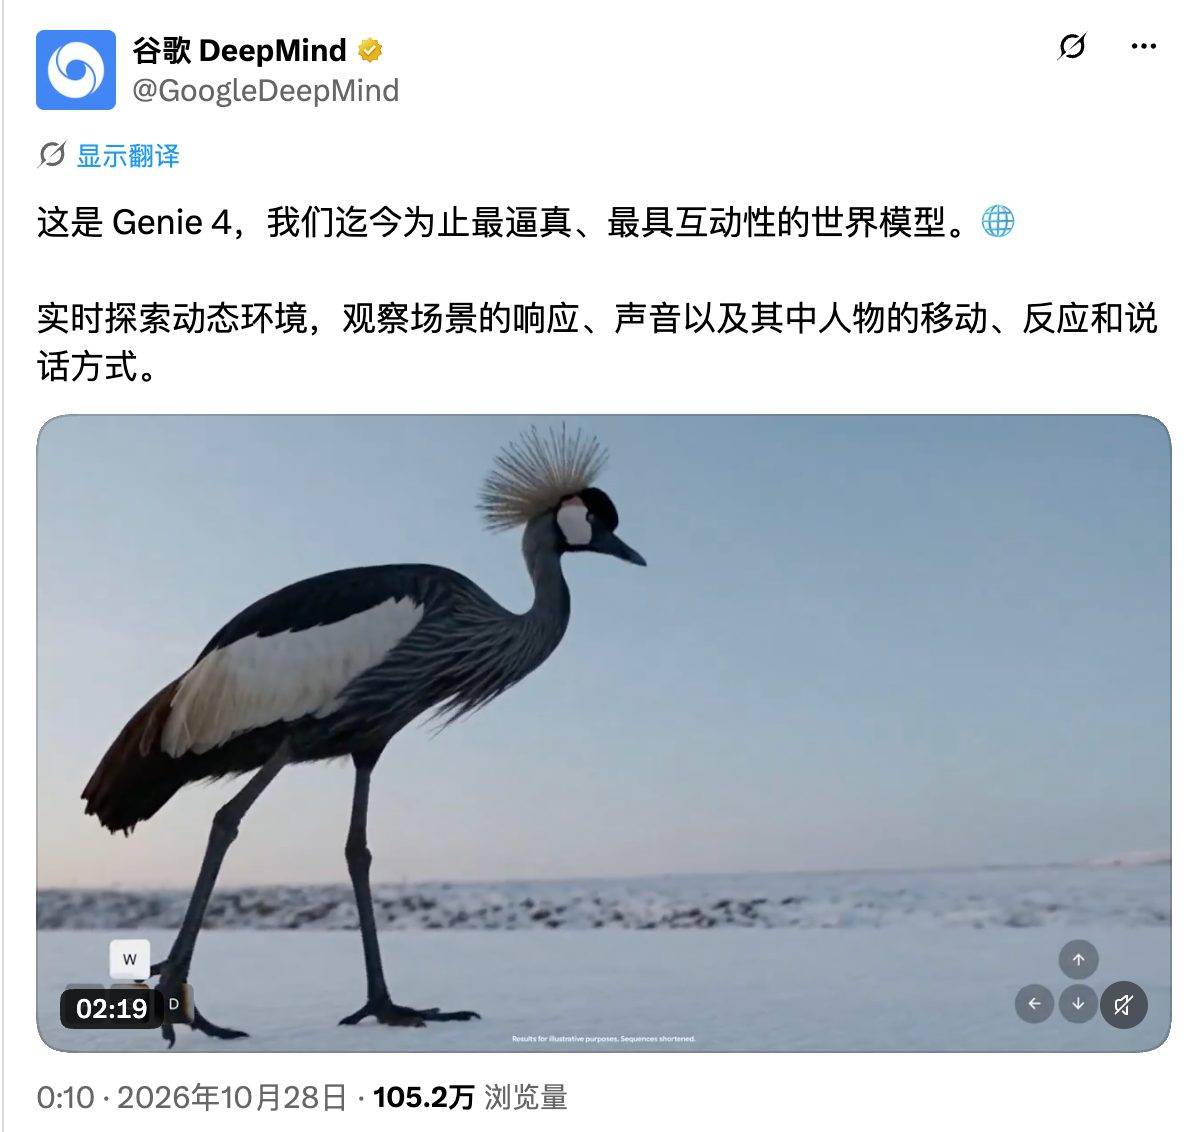
Em comparação com seu antecessor, o Genie 4 não apenas torna os visuais mais realistas, mas também gera som em tempo real, simula leis da física e permite até que os usuários entrem diretamente no mundo criado pela IA, alterem o clima, adicionem personagens e conversem com personagens virtuais a qualquer momento.
Mais importante ainda, o Google também está introduzindo o Gemini na simulação do mundo real, permitindo que um grande modelo de linguagem planeje ações e que o Genie 4 gere o ambiente em tempo real. Vídeos de IA que antes só podiam ser visualizados agora estão se transformando em um mundo virtual que pode ser explorado livremente e com o qual se pode interagir continuamente.
O próximo passo para o vídeo com IA é um mundo no qual podemos realmente entrar.
Em 2024, o Google DeepMind lançou o Genie 1, com o objetivo de aprender a relação entre ações e mudanças ambientais a partir de vídeos. Posteriormente, o Genie 2 expandiu suas capacidades para ambientes 3D exploráveis, e o Genie 3, lançado em 2025, possibilitou a geração e a interação em tempo real.
Agora, o Genie 4 foi atualizado novamente em termos de realismo, simulação física e interatividade, e a duração de uma única simulação foi estendida de cerca de um minuto para dois minutos.
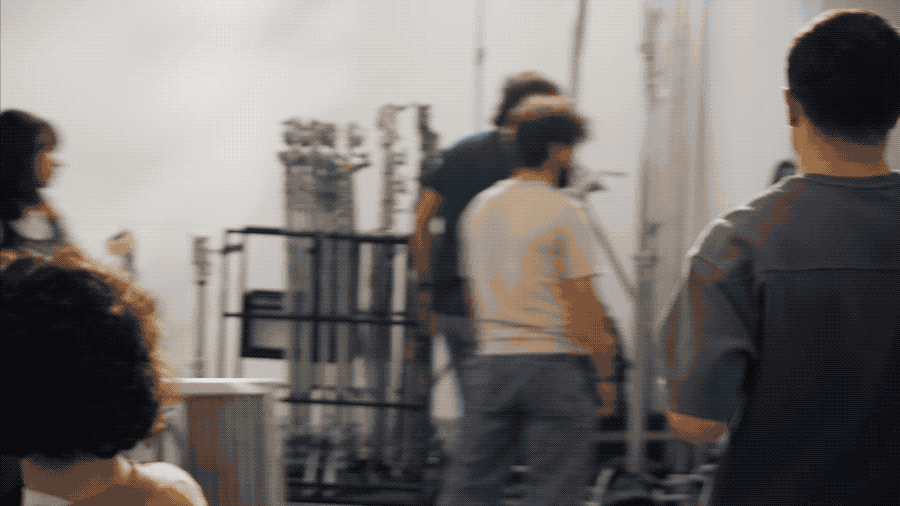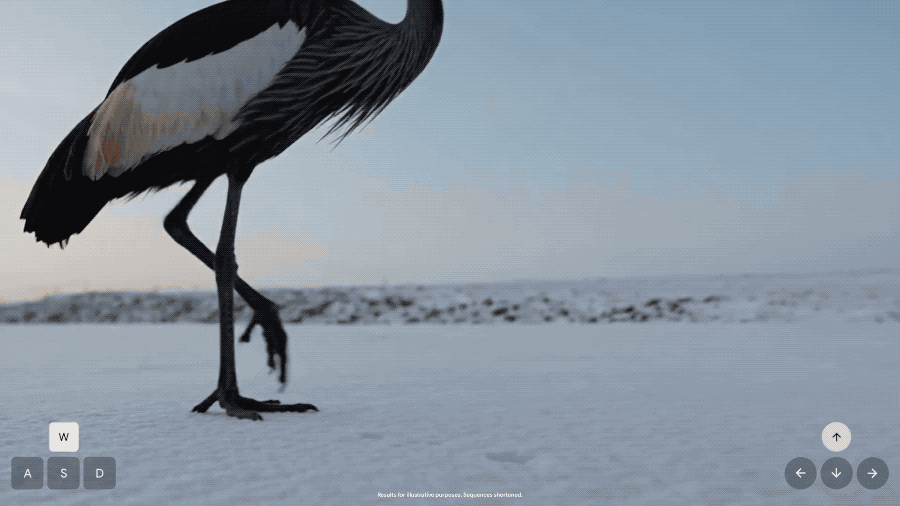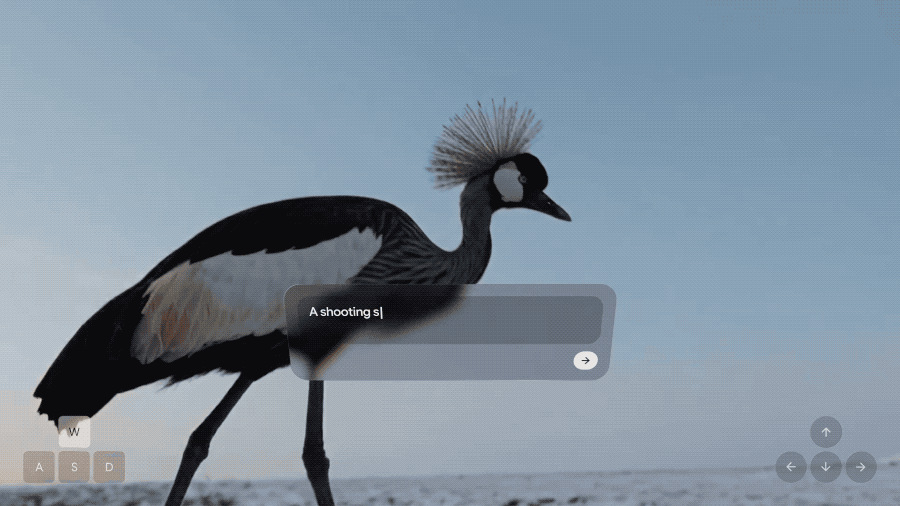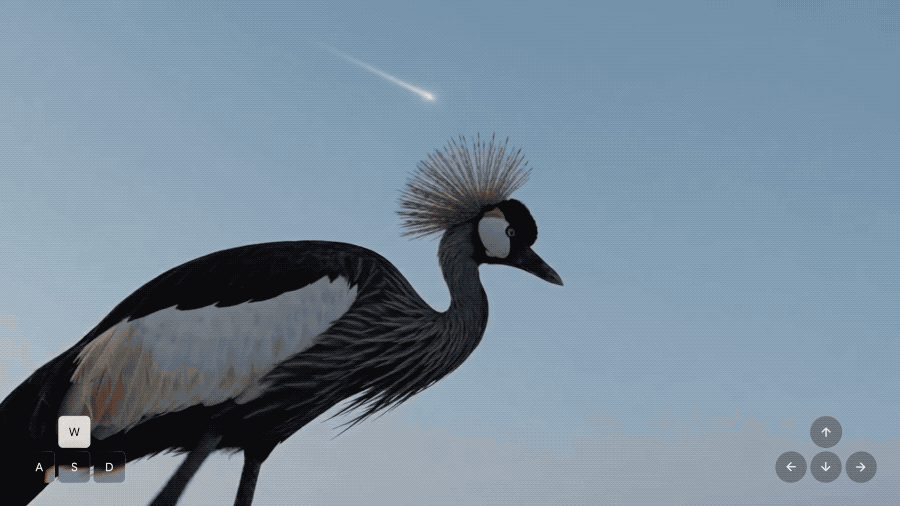
Segundo uma demonstração divulgada pelo Google, os usuários podem gerar um mundo virtual explorável simplesmente digitando um texto, controlar o movimento dos personagens e os ajustes da câmera pelo teclado, e até mesmo continuar inserindo comandos durante o processo para alterar toda a cena.
Por exemplo, em uma pequena plataforma flutuante no lago, um homem de terno marrom toca saxofone. Ao seu redor, águas lacustres envoltas em névoa, florestas e plantas balançam ao vento.
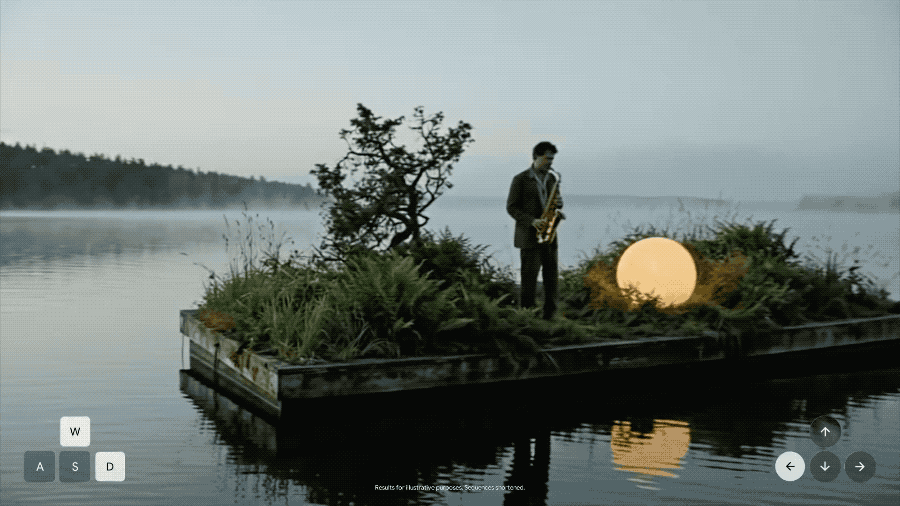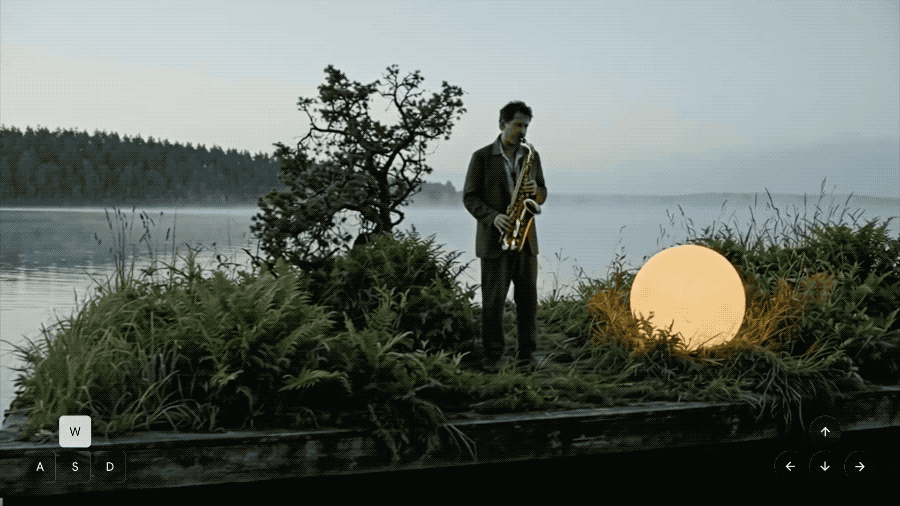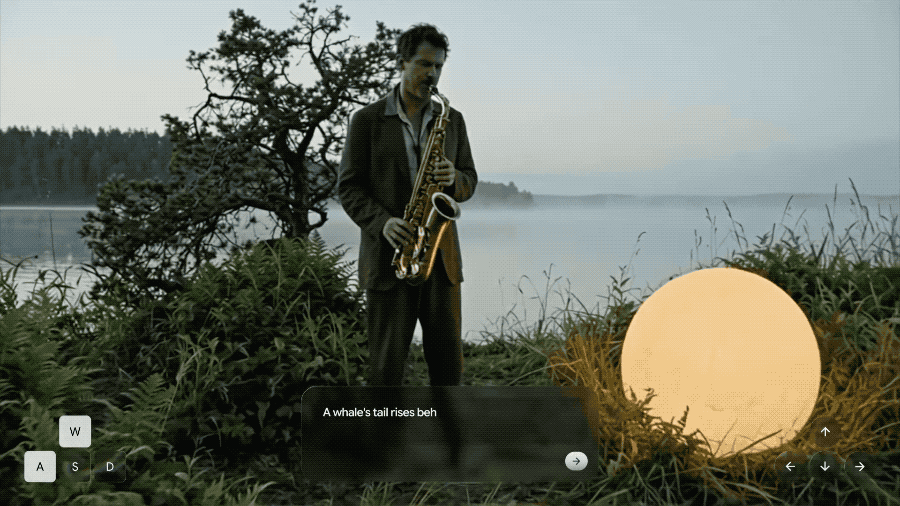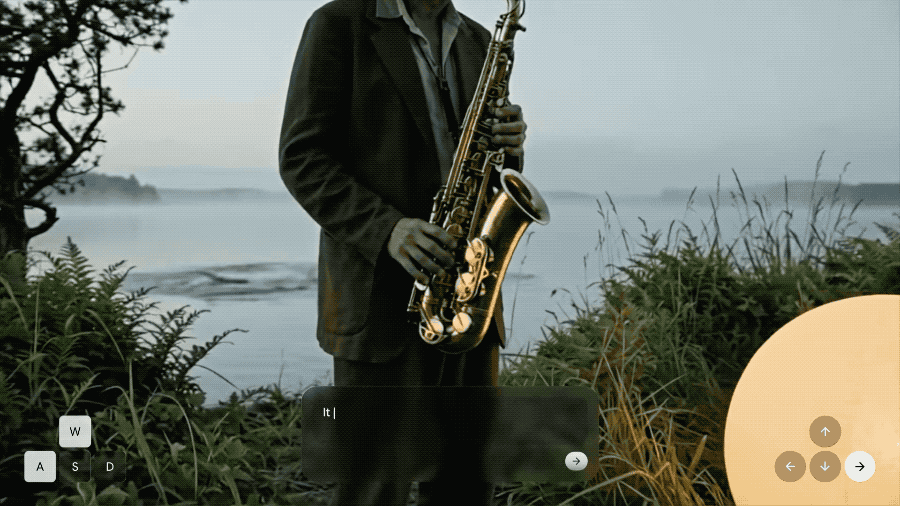
Os usuários podem mover livremente a câmera para observar os movimentos do artista e as mudanças na superfície do lago, podendo até mesmo alterar temporariamente o clima, adicionar personagens ou objetos. O Gemini entenderá as instruções com base no ambiente atual, ajudando o Genie 4 a manter a continuidade da cena.
Ethan Morlick, um professor da Wharton que teve acesso antecipado ao Genie 4, criou uma cidade virtual em um minuto usando apenas a frase "uma cidade neogótica brutalista habitada por robôs e cavalos", e então adicionou um dragão e uma lontra amigável como NPC em tempo real.
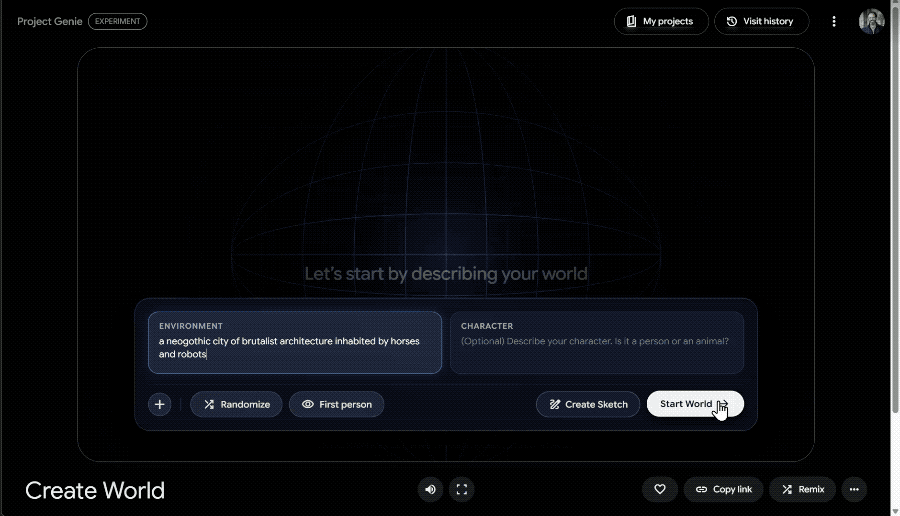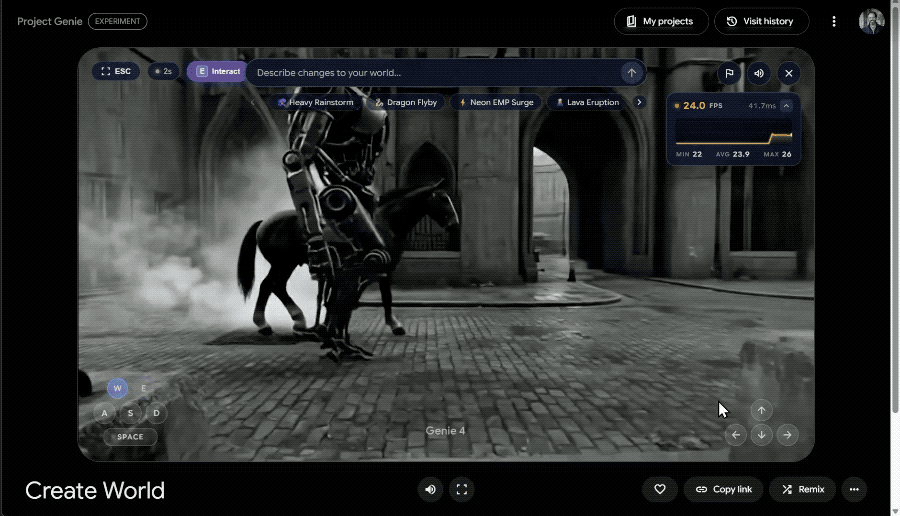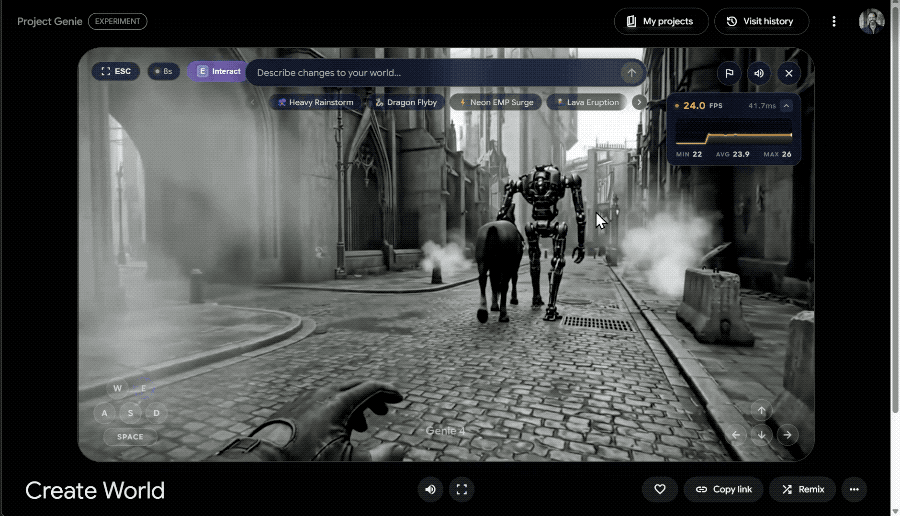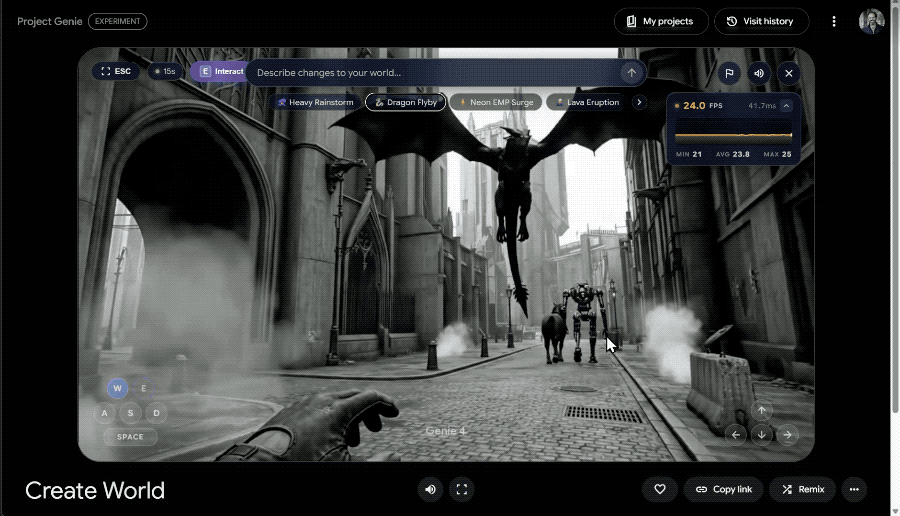
Por outro lado, Justin Moore, investidor da a16z, também apresentou uma demonstração que ele chamou, em tom de brincadeira, de "GTA Waymo", permitindo que os usuários explorem livremente um ambiente urbano gerado inteiramente em tempo real por IA, com interação direta durante todo o processo.
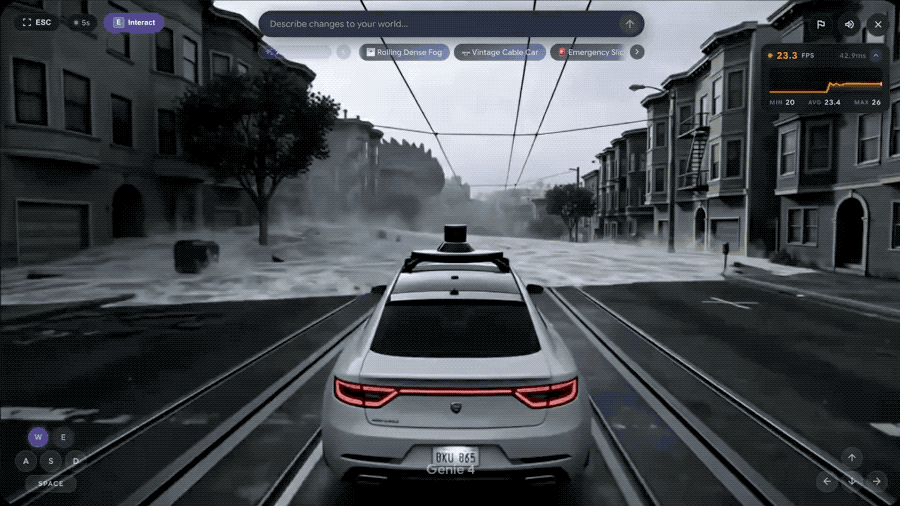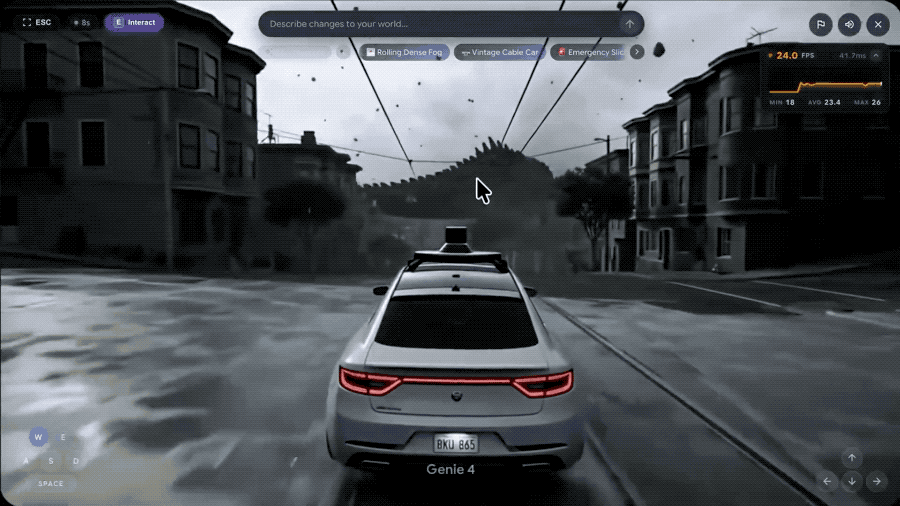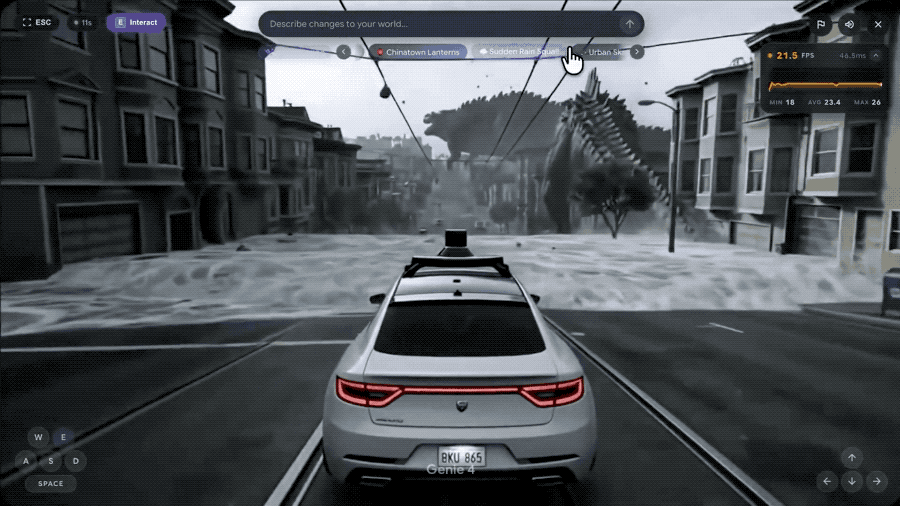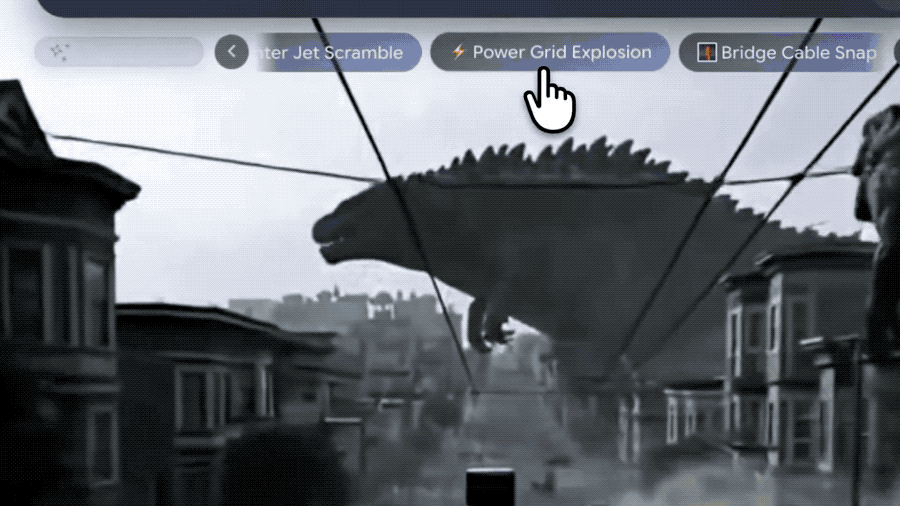
Moore também demonstrou um mundo virtual criado exclusivamente por meio de palavras-chave de ambiente e de personagens, onde os usuários podiam continuar a emitir comandos, mudar de cena e ouvir áudio nativo gerado em sincronia com o mundo à medida que o jogo progredia.
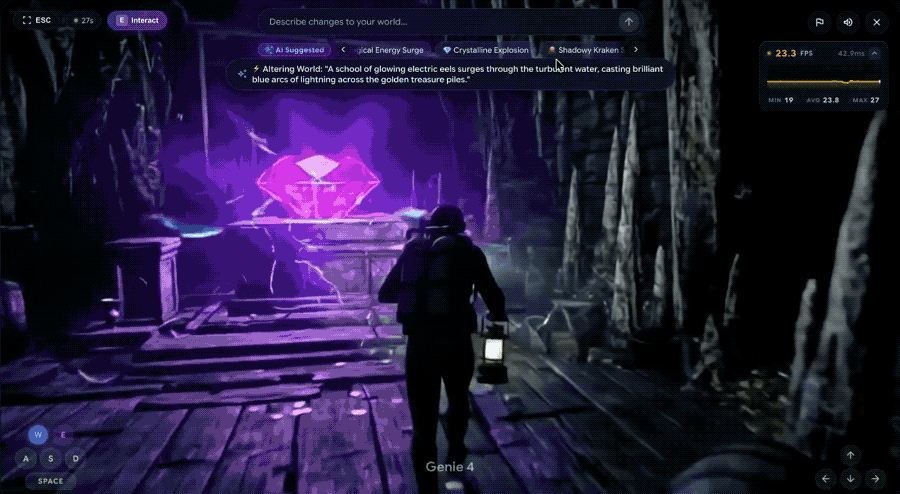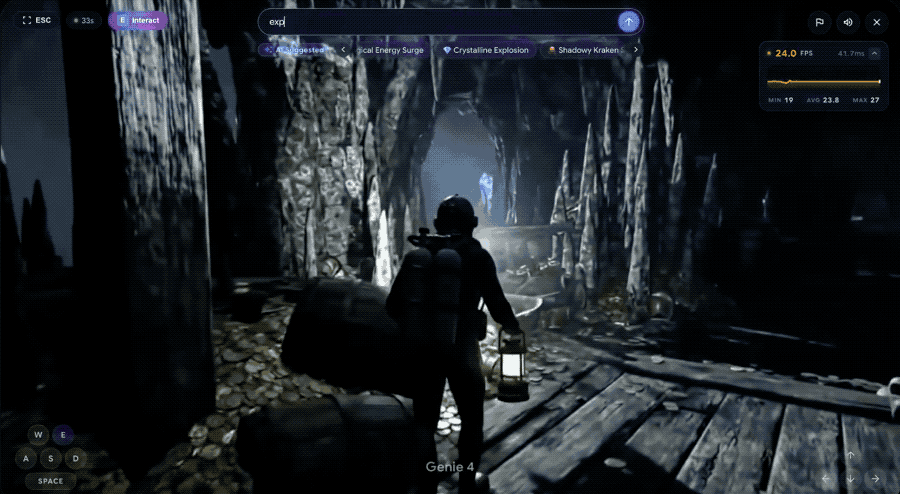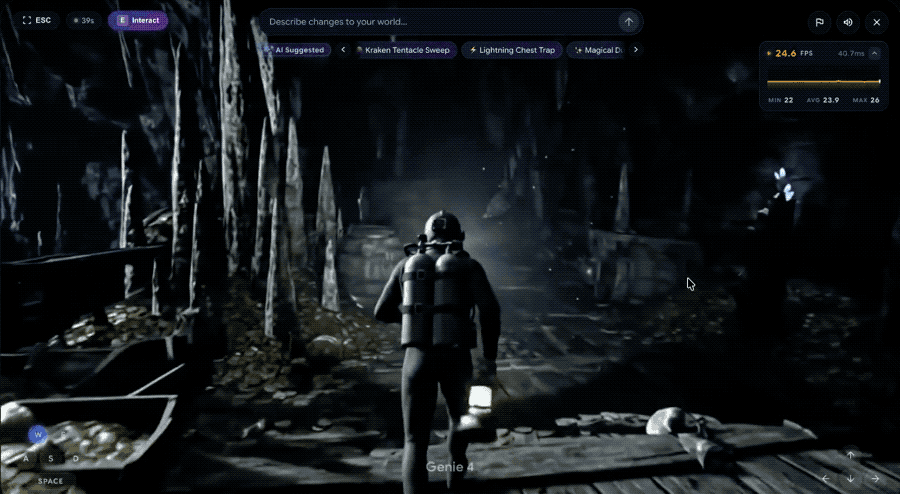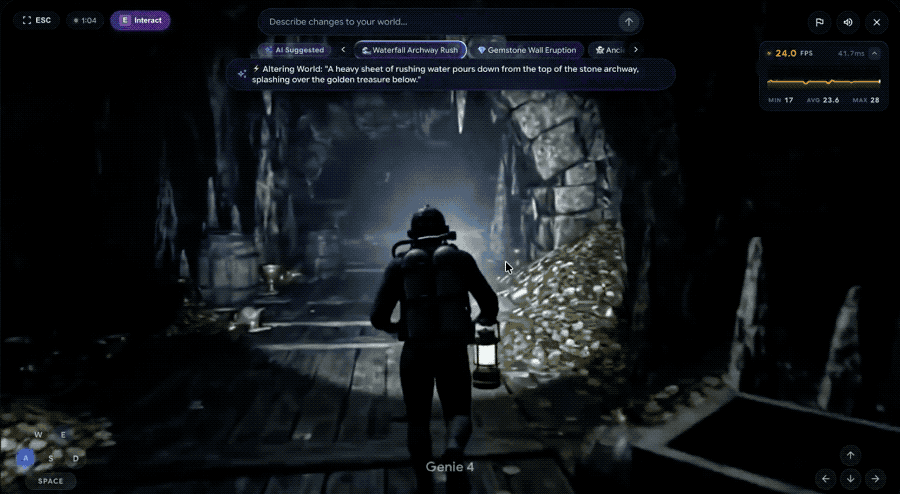
Essas experiências no mundo real também mostram que o que torna o Genie 4 especial é que todo o processo não requer um mapa 3D pré-fabricado ou performances de cena fixas; a IA irá gerar continuamente o que acontece a seguir com base nas ações do usuário.
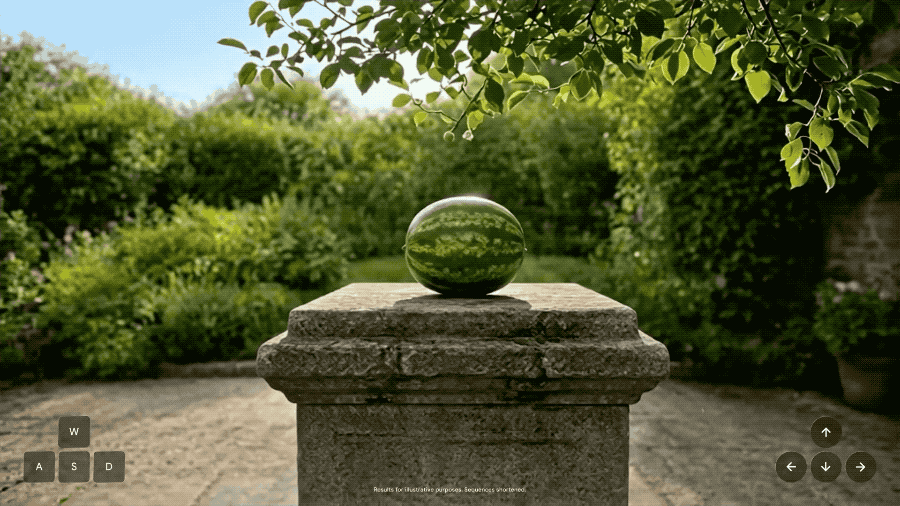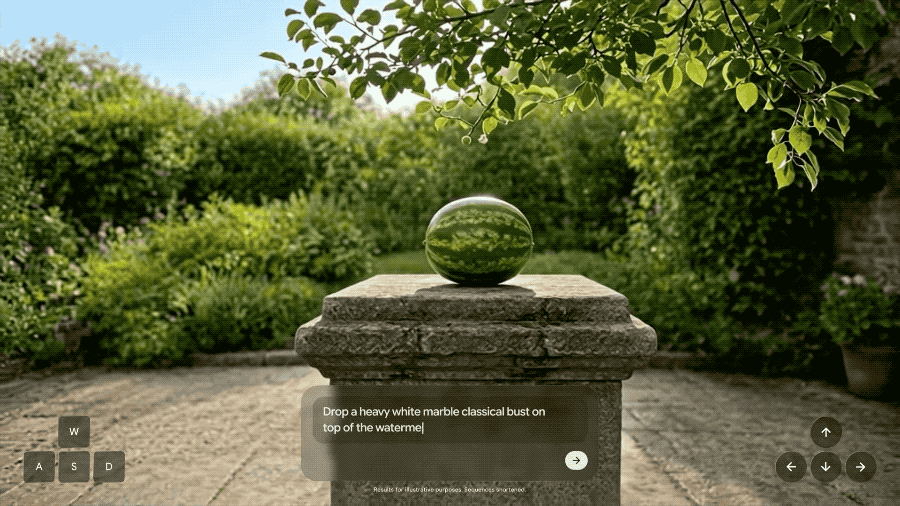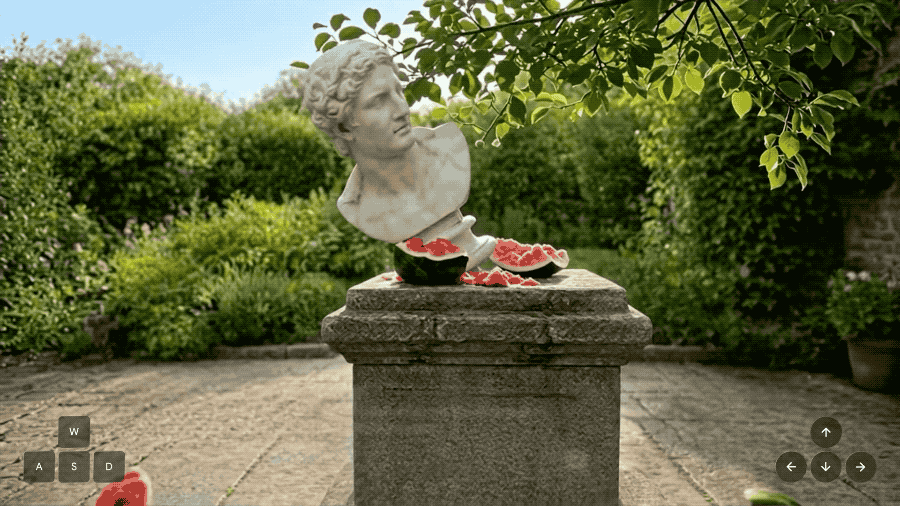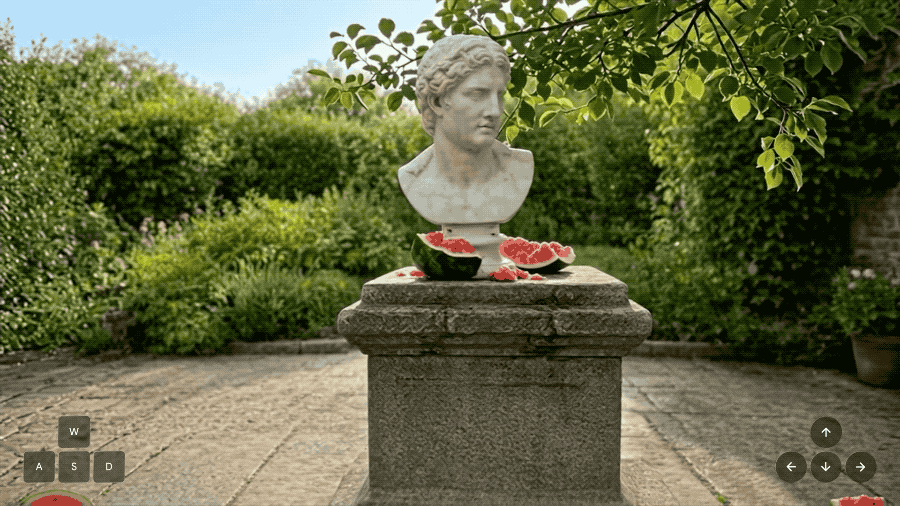
Em termos de simulações físicas, o Google também apresentou exemplos como melancias sendo impactadas, sementes de bordo caindo do ar e estações de trem rurais lotadas, demonstrando colisões, aerodinâmica, gravidade e o comportamento complexo de multidões.
Em particular, o Genie 4 permite que os personagens virtuais se movam de forma mais natural e reajam às mudanças no ambiente, e os usuários também podem guiar o comportamento do personagem em tempo real.
No passado, os vídeos gerados por IA eram normalmente entregues como um evento único, com os usuários podendo visualizar apenas o resultado final. Agora, o Genie 4 busca fazer com que cada movimento e cada ação se tornem uma nova variável que influencia o desenvolvimento do mundo virtual.
O mundo gerado por IA finalmente tem som.
Outra melhoria significativa no Genie 4 é o suporte inédito para geração de áudio nativo.
Anteriormente, a série Genie focava principalmente em recursos visuais e interação por movimento. Agora, o Genie 4 consegue gerar sons ambientais, música e diálogos de personagens em tempo real, enquanto cria o mundo ao seu redor.
Por exemplo, você pode ouvir o som das ondas na praia, o som do vento na floresta e, ao cavalgar um dragão gigante por um vale, também pode ouvir o bater de asas, o uivo do vento e a atividade vulcânica distante.
Mais notavelmente, o Genie 4 começou a dar aos personagens virtuais a capacidade de conversar em tempo real.
Nos jogos tradicionais, os NPCs geralmente dependem de diálogos e lógica comportamental predefinidos, enquanto o Genie 4 pode gerar dinamicamente a linguagem e as reações dos personagens com base na entrada do usuário e nos eventos da cena.
Isso significa que, no futuro, os jogadores terão a oportunidade de entrar em um mundo criado por IA, interagir livremente com os personagens e até mesmo mudar o rumo da história por meio de suas próprias ações.
No entanto, o Genie 4 ainda apresenta problemas com a precisão do áudio e a consistência a longo prazo, e ainda está bastante longe de ser capaz de suportar verdadeiramente grandes jogos de mundo aberto.
Gemini também está ditando as regras, e a IA está começando a entender como o mundo funciona.
Se os elementos visuais e sonoros tornaram Genie 4 mais realista, a adição de Gemini conferiu ao modelo do mundo capacidades complexas de raciocínio e planejamento.
Segundo o Google DeepMind, o Genie 4 integra diversas funcionalidades da família Gemini.
Dentre eles, o Gemini Omni fornece a base de aparência e comportamento do mundo real para a simulação, enquanto o Gemini 3.8 Flash atua como um agente guia em tempo real, observando continuamente as imagens geradas, dividindo a tarefa em várias etapas e avaliando se cada etapa foi bem-sucedida.
O Genie 4 é responsável por gerar o mundo virtual, enquanto o Gemini é responsável por planejar o que deve acontecer em seguida.
Por exemplo, se um usuário pedir ao robô para concluir uma tarefa complexa, o Gemini pode dividir a tarefa em várias ações, observar o desempenho do robô em um ambiente simulado e ajustar a próxima etapa com base nos resultados.
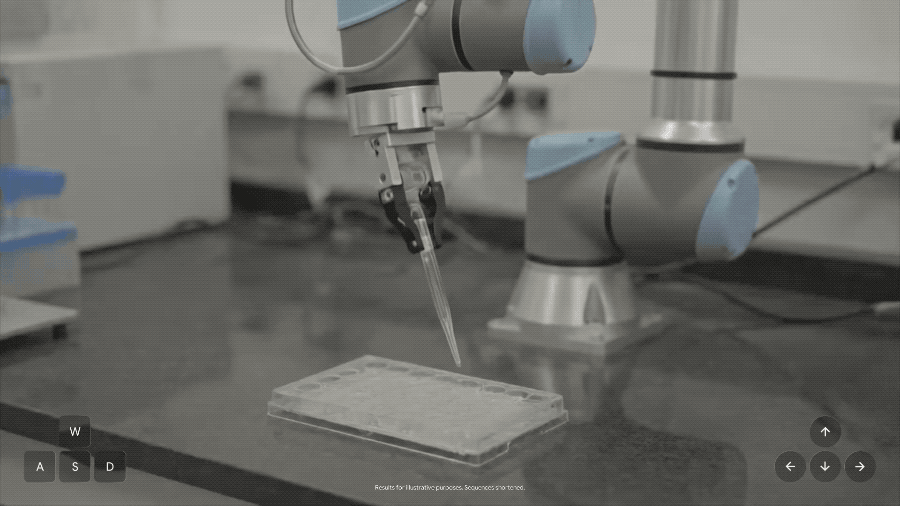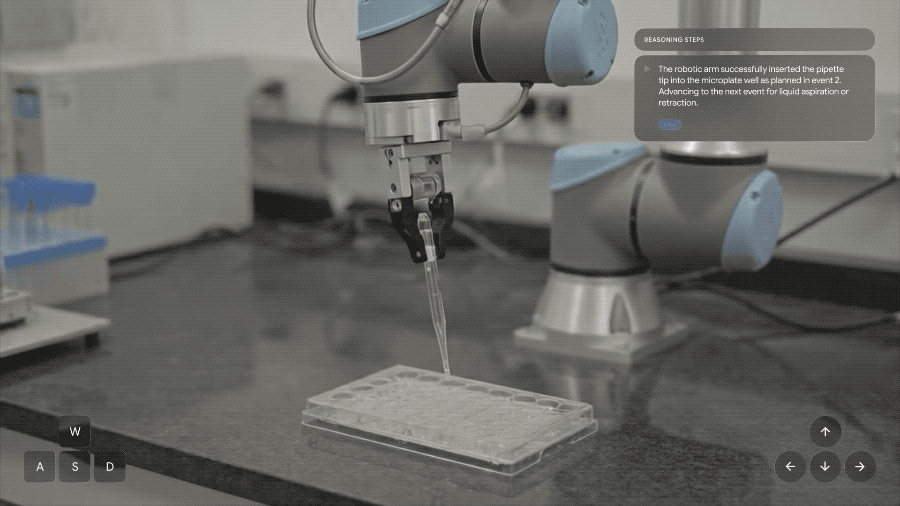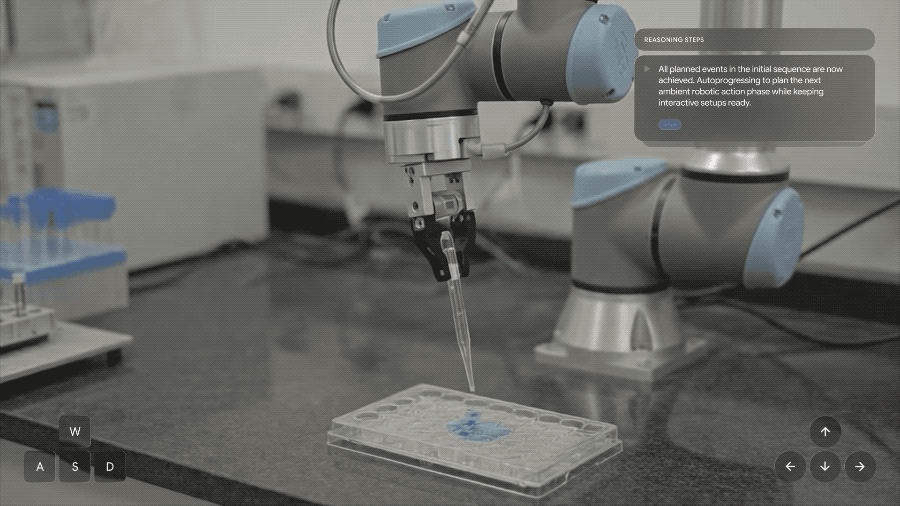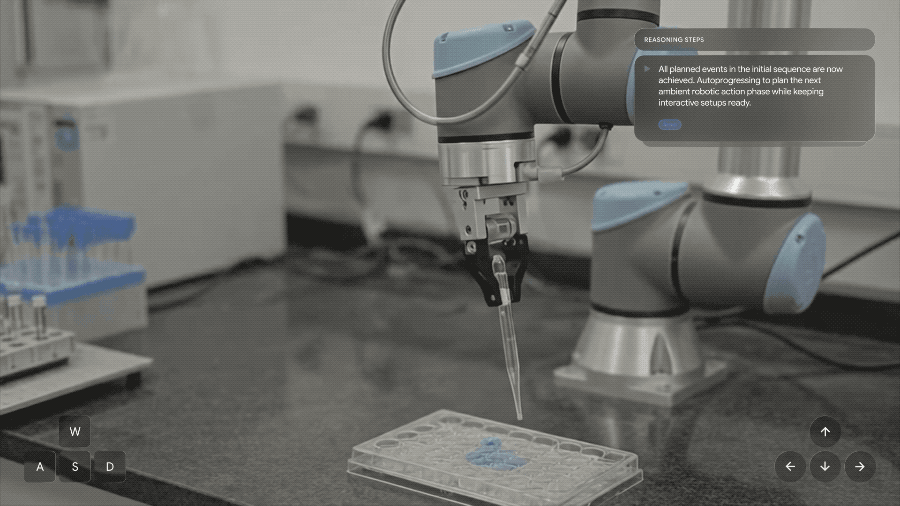
Mesmo que o usuário altere suas necessidades ou o ambiente ao redor mude, o Gemini consegue modificar o plano de ação em tempo real.
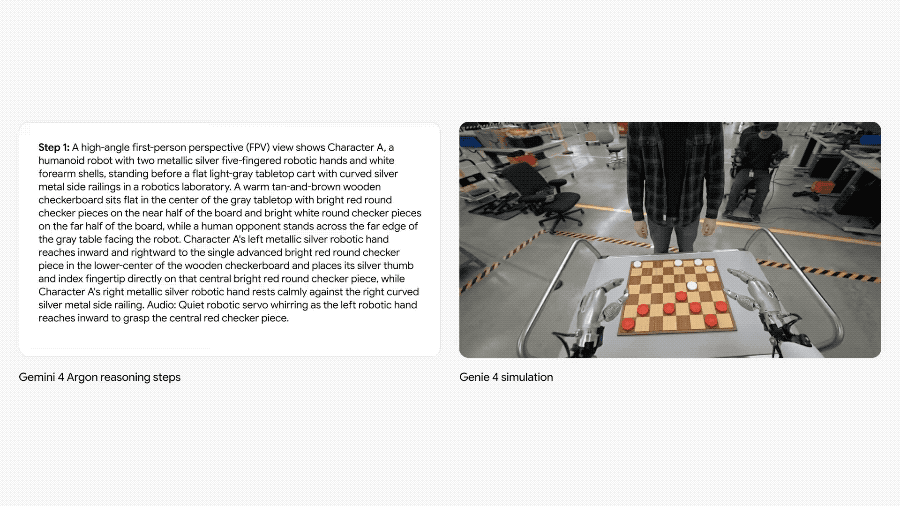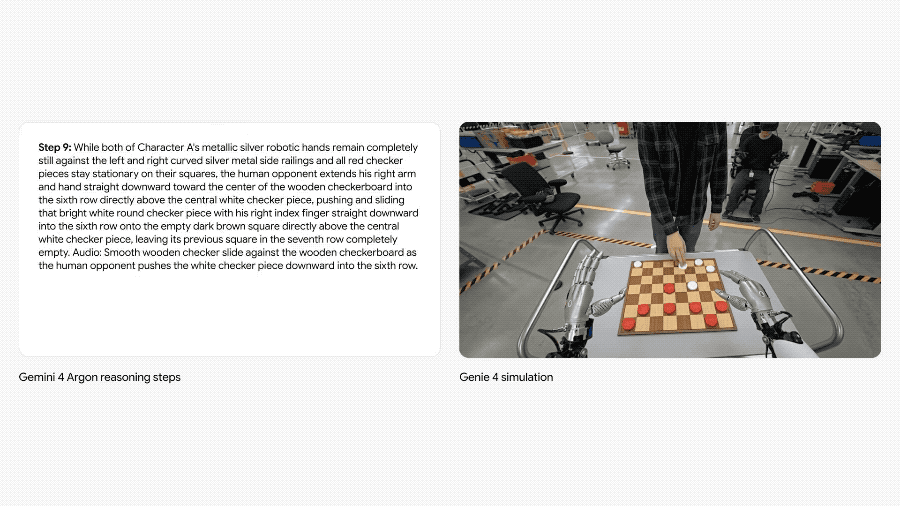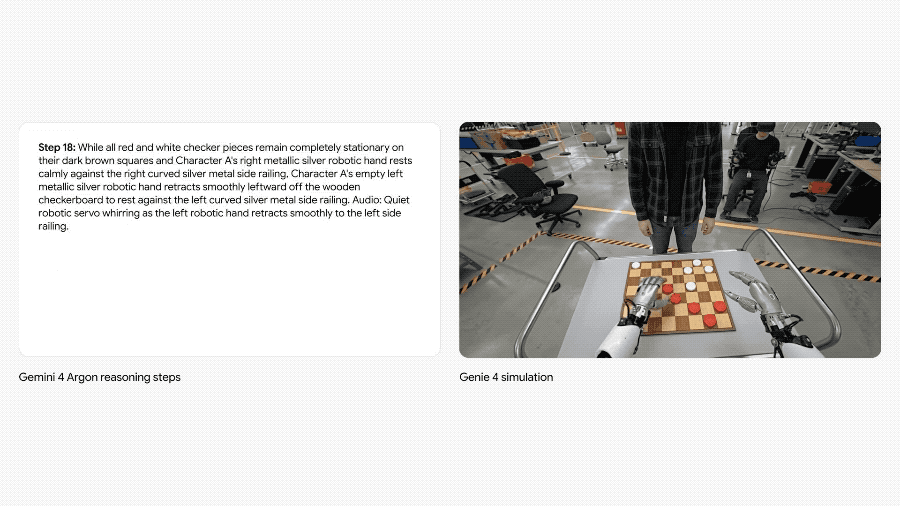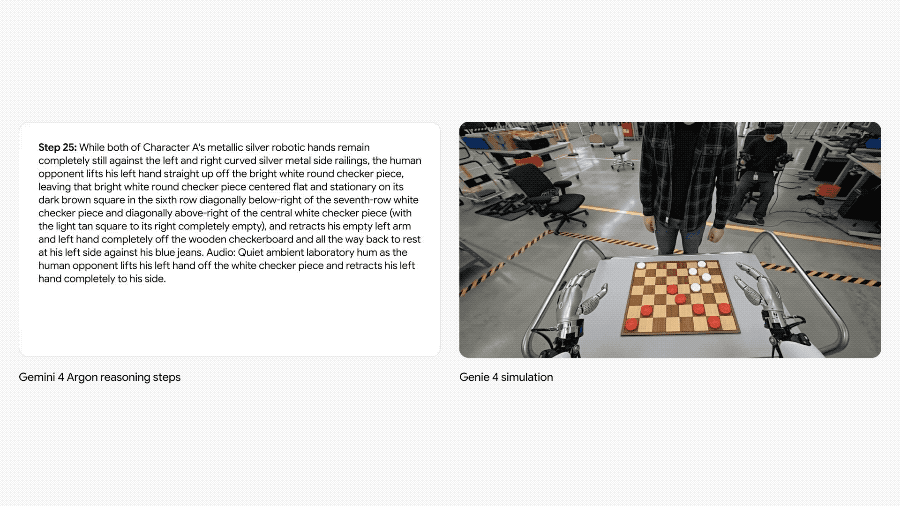
O Google também apresentou um experimento de pesquisa combinando os foguetes Gemini 4 Argon e Genie 4.
Na demonstração, o Gemini 4 Argon dividiu a tarefa em etapas consecutivas, enquanto o Genie 4 simulava em tempo real o processo do robô humanoide Apollo da Apptronik jogando damas.
Em comparação com a simples geração de um vídeo de um robô jogando xadrez, essa combinação dá maior ênfase à simulação contínua e ao ajuste do processo de execução da tarefa.
Essa capacidade é inestimável para o treinamento de robôs.
O treinamento de robôs no mundo real exige equipamentos, instalações e experimentos extensivos, e alguns cenários perigosos ou dispendiosos são difíceis de testar repetidamente. Se um modelo do mundo real puder simular com precisão o ambiente físico, os robôs podem praticar antecipadamente em um mundo virtual e, em seguida, transferir as habilidades aprendidas para a realidade.
Tejas Kulkarni, diretor de pesquisa do Google DeepMind, também afirmou que uma importante direção futura são os modelos híbridos do mundo, que combinam as capacidades de raciocínio estruturado dos modelos de linguagem com as capacidades de simulação sensorial dos modelos do mundo.
Gemini pode ser responsável pelo planejamento e organização de eventos complexos, enquanto Genie traduz esses planos em visuais, sons e ambientes físicos que mudam em tempo real.
A inteligência artificial está começando a tentar prever e verificar as possíveis consequências de ações no mundo que cria.
As ambições do modelo mundial vão muito além dos jogos.
Atualmente, o Google DeepMind convidou testadores de setores como cinema, jogos, notícias, educação e engenharia para explorar as aplicações práticas do Genie 4.
Uma direção particularmente criativa é a produção cinematográfica.
Antigamente, quando os diretores queriam verificar tomadas complexas, geralmente precisavam criar storyboards, construir cenas em 3D ou providenciar ensaios prévios com os atores.
Com o Genie 4, os criadores podem gerar uma cena virtual explorável usando texto, entrar diretamente nela para ajustar ângulos de câmera, iluminação, movimentos dos personagens e diálogos, e experimentar rapidamente diferentes métodos de filmagem.
Para desenvolvedores de jogos, o Genie 4 também pode servir como uma ferramenta de prototipagem rápida. Os desenvolvedores podem criar ambientes de jogo usando prompts, testar diretamente o estilo artístico, a renderização de materiais e a jogabilidade interativa básica e, em seguida, decidir se devem investir recursos no desenvolvimento formal.
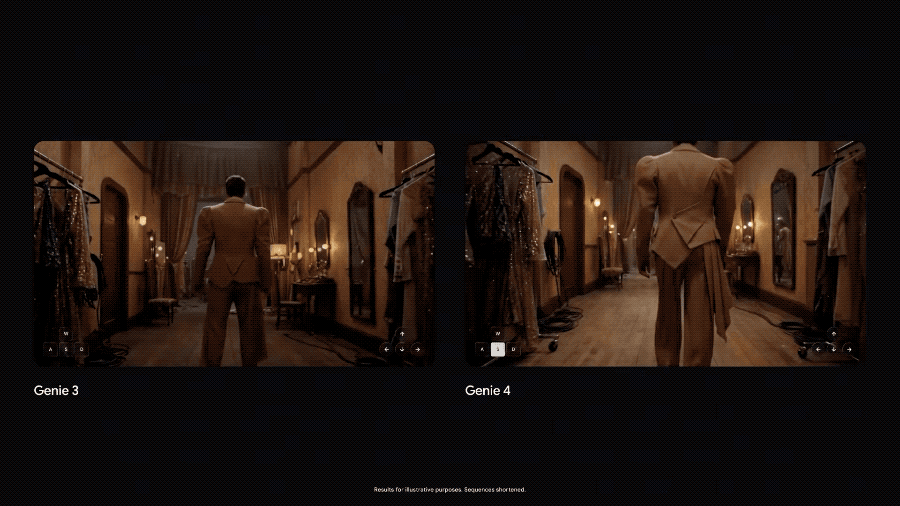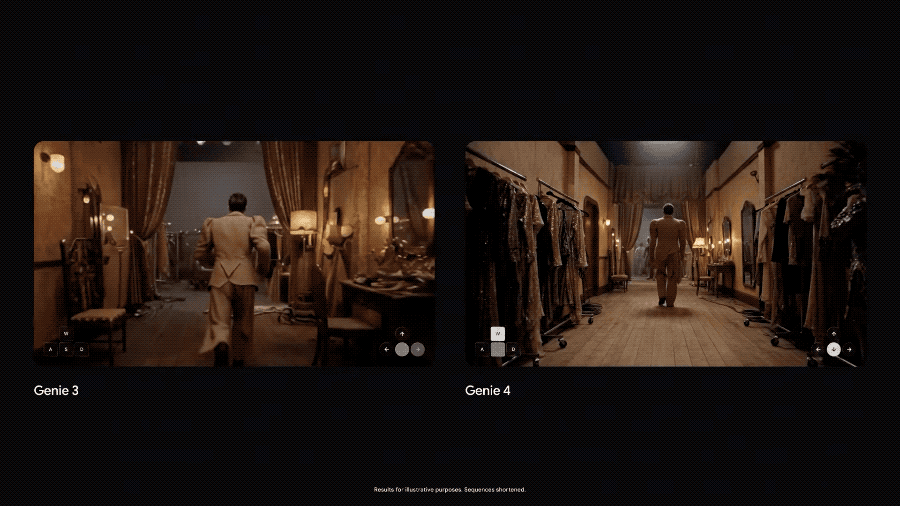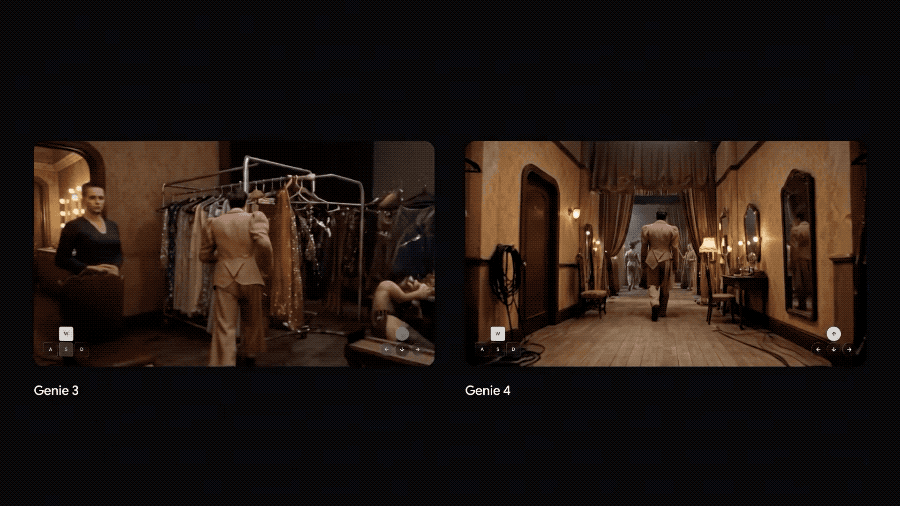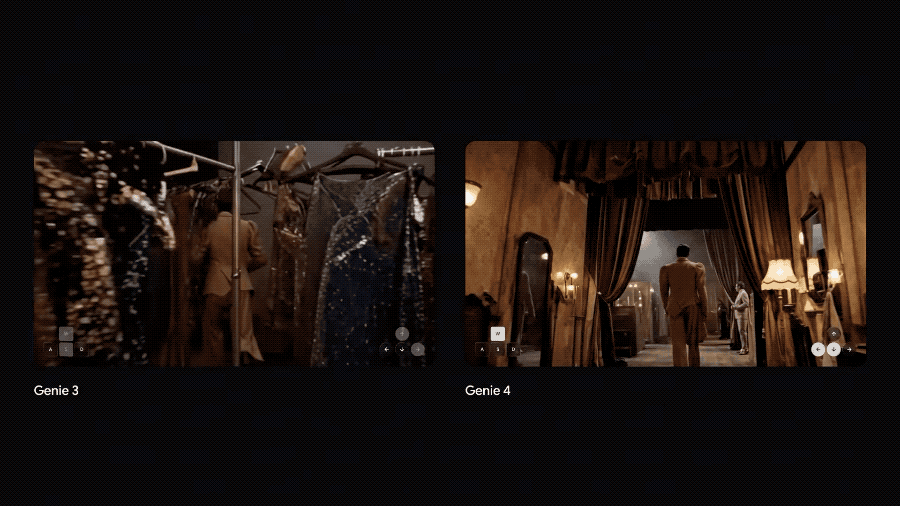
Existem também aplicações nas áreas do jornalismo e da educação.
O Google observou que alguns fotojornalistas estão tentando transformar fotografias históricas bidimensionais em cenas dinâmicas e exploráveis, ou simular o desenrolar de eventos como enchentes e incêndios florestais. No entanto, as imagens inferidas por IA a partir de fotografias históricas não podem ser consideradas reconstruções precisas de fatos históricos.
No âmbito empresarial, os modelos do mundo real também podem ser usados para simulação industrial, pesquisa e desenvolvimento de robôs e testes em ambientes complexos, reduzindo o tempo e o custo necessários para alguns experimentos no mundo real.
À medida que as perspectivas de aplicação se tornam mais claras, os modelos mundiais se transformaram em uma nova área de competição para os gigantes da IA.
Além do Google, a Runway lançou o GWM Worlds 2, que oferece suporte a áudio e interação em tempo real, enquanto a World Labs, fundada por Fei-Fei Li, optou por um caminho diferente na inteligência espacial, enfatizando a reconstrução, edição e consistência a longo prazo de ambientes tridimensionais.
Em setembro deste ano, a AMD anunciou a aquisição da World Labs por aproximadamente US$ 8,2 bilhões, o que demonstra que o valor da World Model se estendeu da geração de conteúdo à robótica e à infraestrutura de computação de IA.
Um mundo de apenas 120 segundos, mas que conduz ao futuro da IA.
Apesar das impressionantes capacidades demonstradas pelo Genie 4, ele ainda tem um longo caminho a percorrer antes de alcançar um mundo digital verdadeiramente completo.
Atualmente, o modelo consegue manter uma duração de simulação interativa de aproximadamente dois minutos. À medida que o tempo de simulação aumenta, os detalhes dos objetos podem mudar e inconsistências podem surgir na cena.
Se os usuários modificarem continuamente as instruções ou explorarem um ambiente maior, o modelo poderá gradualmente perder a precisão das informações iniciais da cena. Além disso, interações físicas complexas, precisão espacial, geração de áudio e legibilidade do texto nos elementos visuais precisam ser aprimoradas.
Atualmente, o Genie 4 está disponível para pré-visualização para um grupo seleto de testadores convidados. No futuro, ele será disponibilizado para assinantes do Google AI Ultra por meio do Project Genie e, gradualmente, para os primeiros parceiros da API Gemini e do Google AI Studio.
Ao analisarmos a IA generativa nos últimos anos, desde textos e imagens até vídeos e, agora, ambientes virtuais que podem ser explorados em tempo real e que possuem som e comportamento humano, percebemos que os limites do conteúdo gerado por IA estão em constante expansão.
O que é realmente notável no Genie 4 é a profunda integração do modelo do mundo com as capacidades de raciocínio do modelo de linguagem abrangente.
No passado, a IA conseguia prever o que uma pessoa poderia ver ao abrir uma porta e também gerar um vídeo da porta se abrindo. No futuro, ela também precisará entender por que a porta se abre, como a pessoa do outro lado reagirá e quais serão as consequências da sequência de ações subsequentes.
Para agentes de IA e robôs que atuam no mundo real, a capacidade de prever as consequências de ações e repeti-las em ambientes virtuais pode ser mais importante do que gerar um vídeo visualmente atraente.
Enquanto os grandes modelos de linguagem permitem que a IA pense, os modelos do mundo real tentam ajudar a IA a compreender as consequências de suas ações.
Talvez uma das maneiras importantes para a IA entender o mundo real no futuro seja primeiro aprender como a realidade funciona, estudando repetidamente os inúmeros mundos que ela cria.