Um aumento de 37 vezes no valor de mercado em 24 dias — esta é a história mais empolgante do ano na indústria de IA
A Jev está dando o que falar. Seu modelo de IA não textual garantiu hoje um aporte de US$ 870 milhões, liderado pela a16Z, elevando o valor de mercado da empresa para US$ 7,5 bilhões.
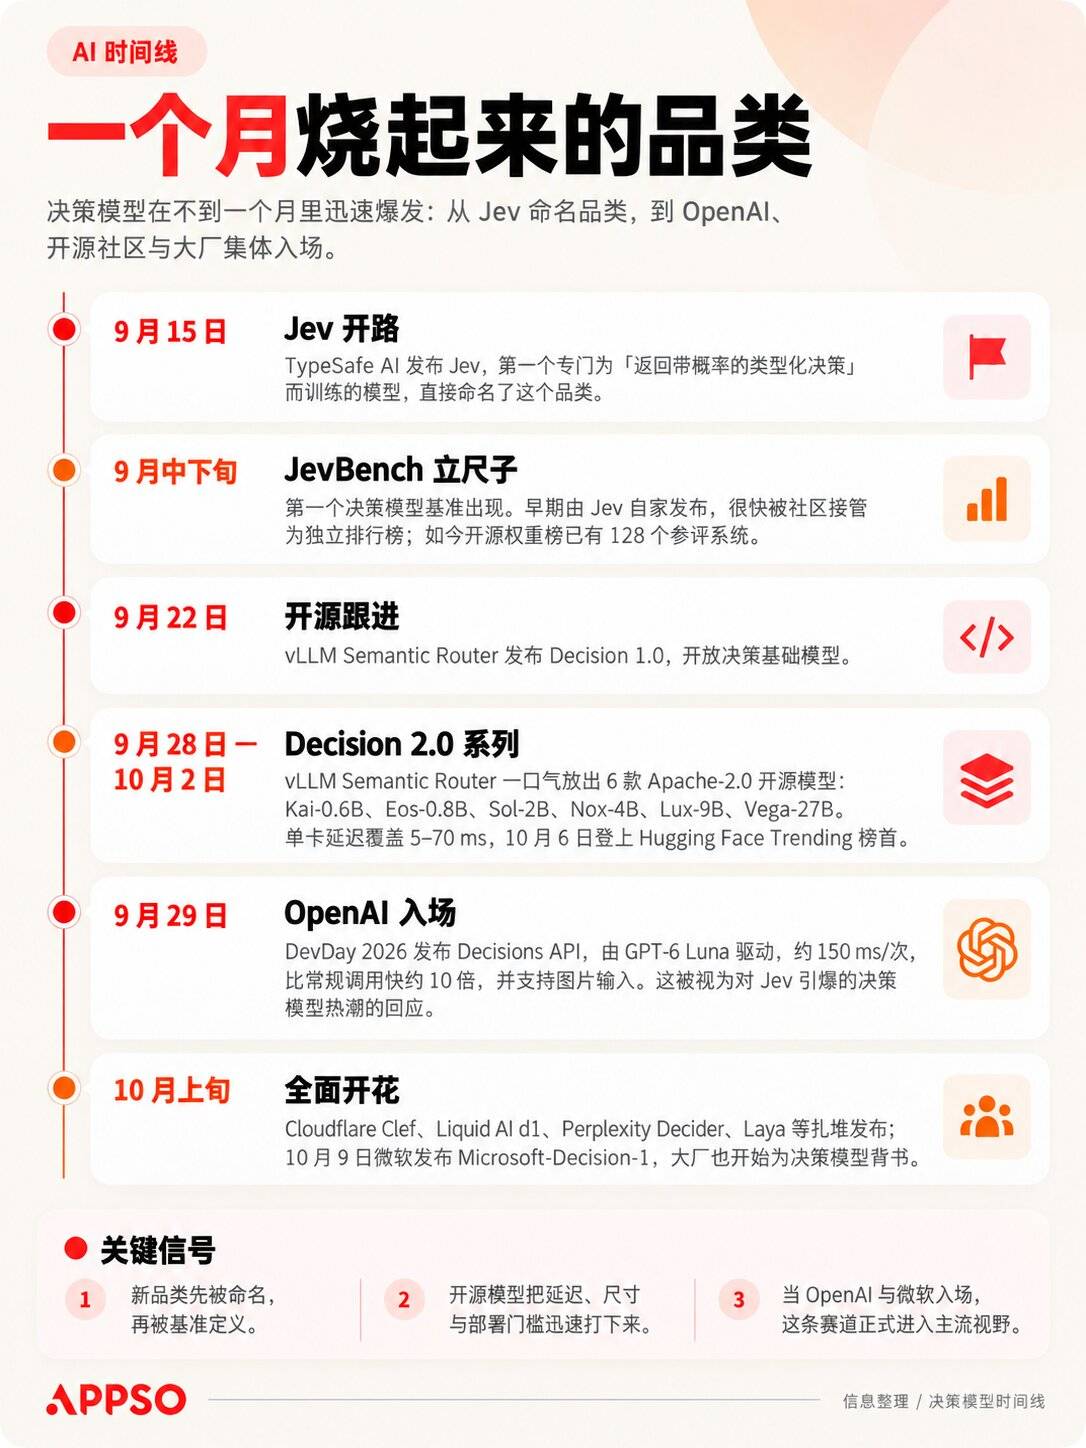
Quando foi lançado em 15 de setembro, o TypeSafe havia arrecadado apenas US$ 40 milhões em sua rodada de investimento inicial e era avaliado em cerca de US$ 200 milhões; em 24 dias, seu valor de mercado aumentou 37 vezes.
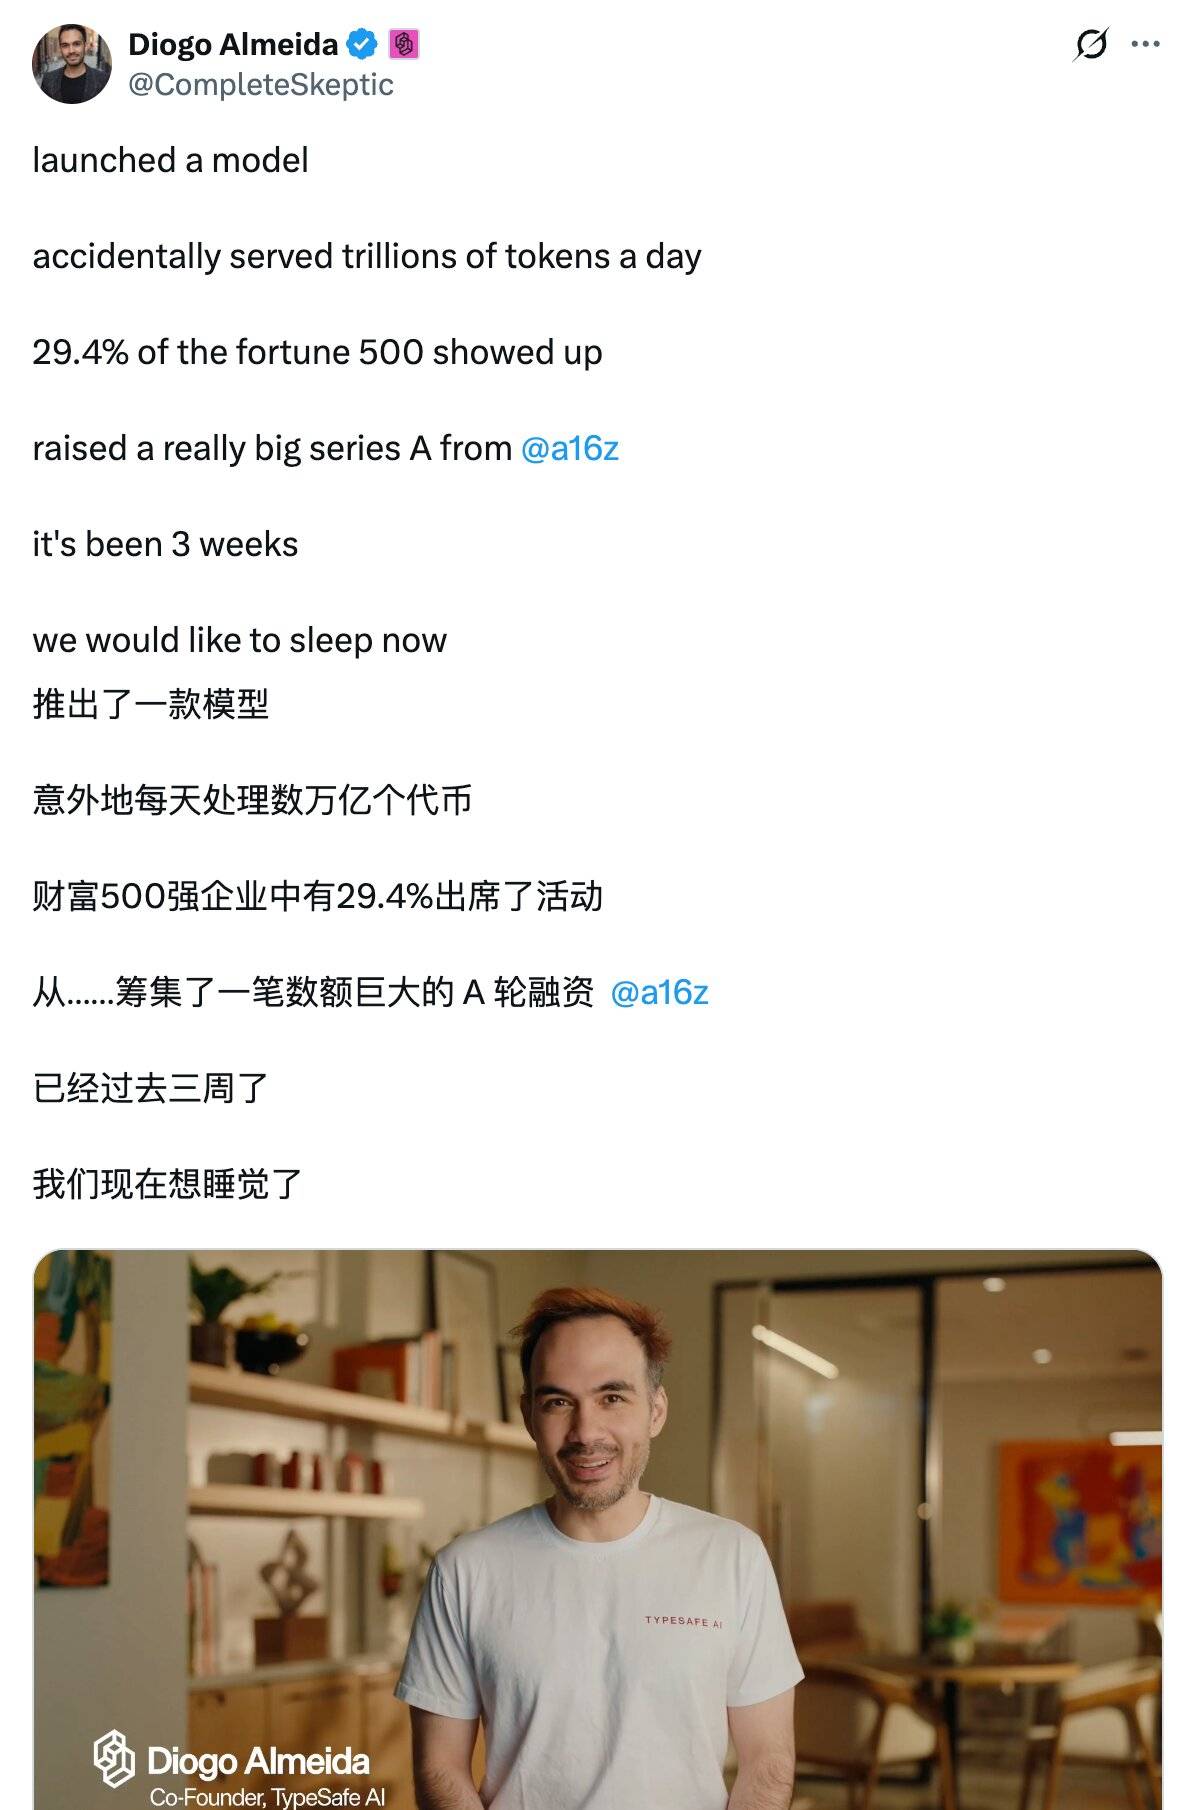
De acordo com os resultados compartilhados pelo fundador da Jev no X, a Jev ultrapassou 1 milhão de usuários em poucos dias e, em três semanas após o lançamento do seu modelo, processou trilhões de tokens diariamente. Aproximadamente um terço das empresas da Fortune 500 utiliza esse modelo de tomada de decisão.
Em pouco tempo, modelos de tomada de decisão surgiram por toda parte. Desde a API Decisions, lançada na Conferência de Desenvolvedores OpenAI , até a plataforma de código aberto vLLM, que lançou seis modelos de tomada de decisão de uma só vez, e agora a Microsoft também lançou seu próprio modelo de tomada de decisão — o Microsoft-Decision-1.
O que é um modelo de decisão? É um modelo que não consegue conversar, escrever código ou resumir documentos. Fornecemos a ele um contexto e um conjunto de respostas candidatas predefinidas, e ele consegue retornar a probabilidade calibrada de cada opção em pouco tempo. Só isso.
O motivo de ter se tornado tão popular agora é que o agente está realmente trabalhando.
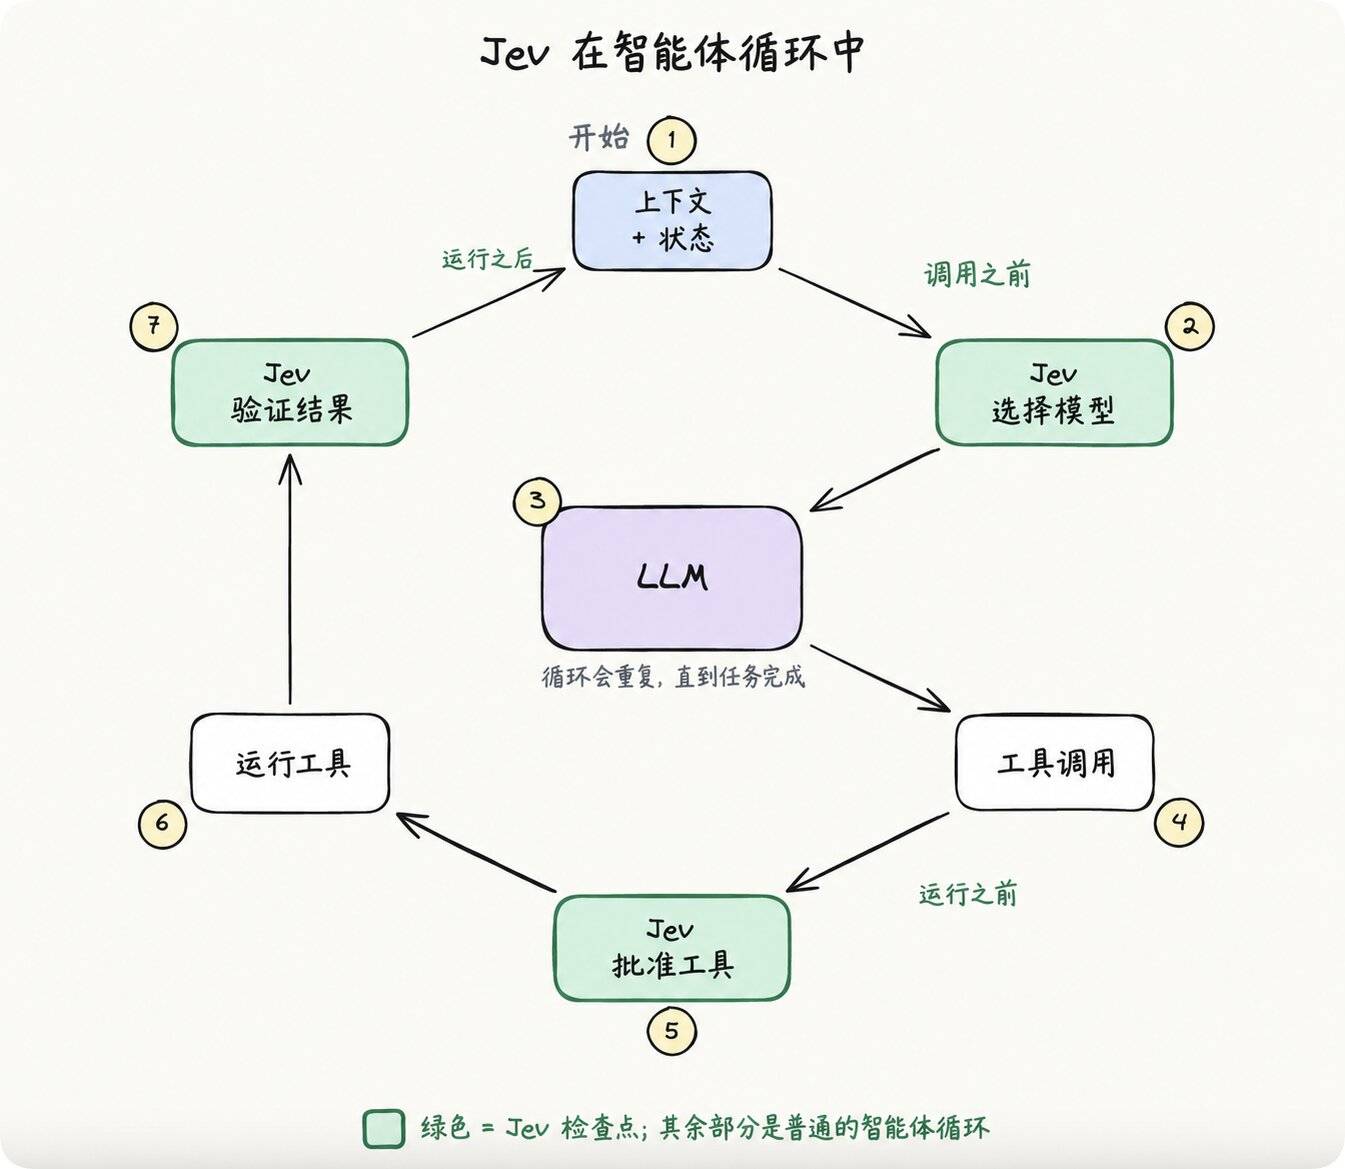
Uma tarefa de agente envolve dezenas de pequenas decisões de ramificação: para qual modelo rotear, se deve permitir uma chamada de ferramenta e se deve continuar ou parar. Essas decisões têm espaço de resposta limitado, um alto volume de chamadas e estão todas no caminho crítico. Usar um LLM de última geração para executar cada decisão fará com que a latência da tarefa se acumule em segundos e a cobrança aumente em tokens.
Conforme mencionado pela Microsoft em sua postagem técnica no blog sobre o modelo Decision-1, uma vez que a IA Agética se torne realidade, o custo se tornará o principal fator nas decisões das pessoas sobre como usar a IA.
Quando todos começarem a construir modelos de decisão
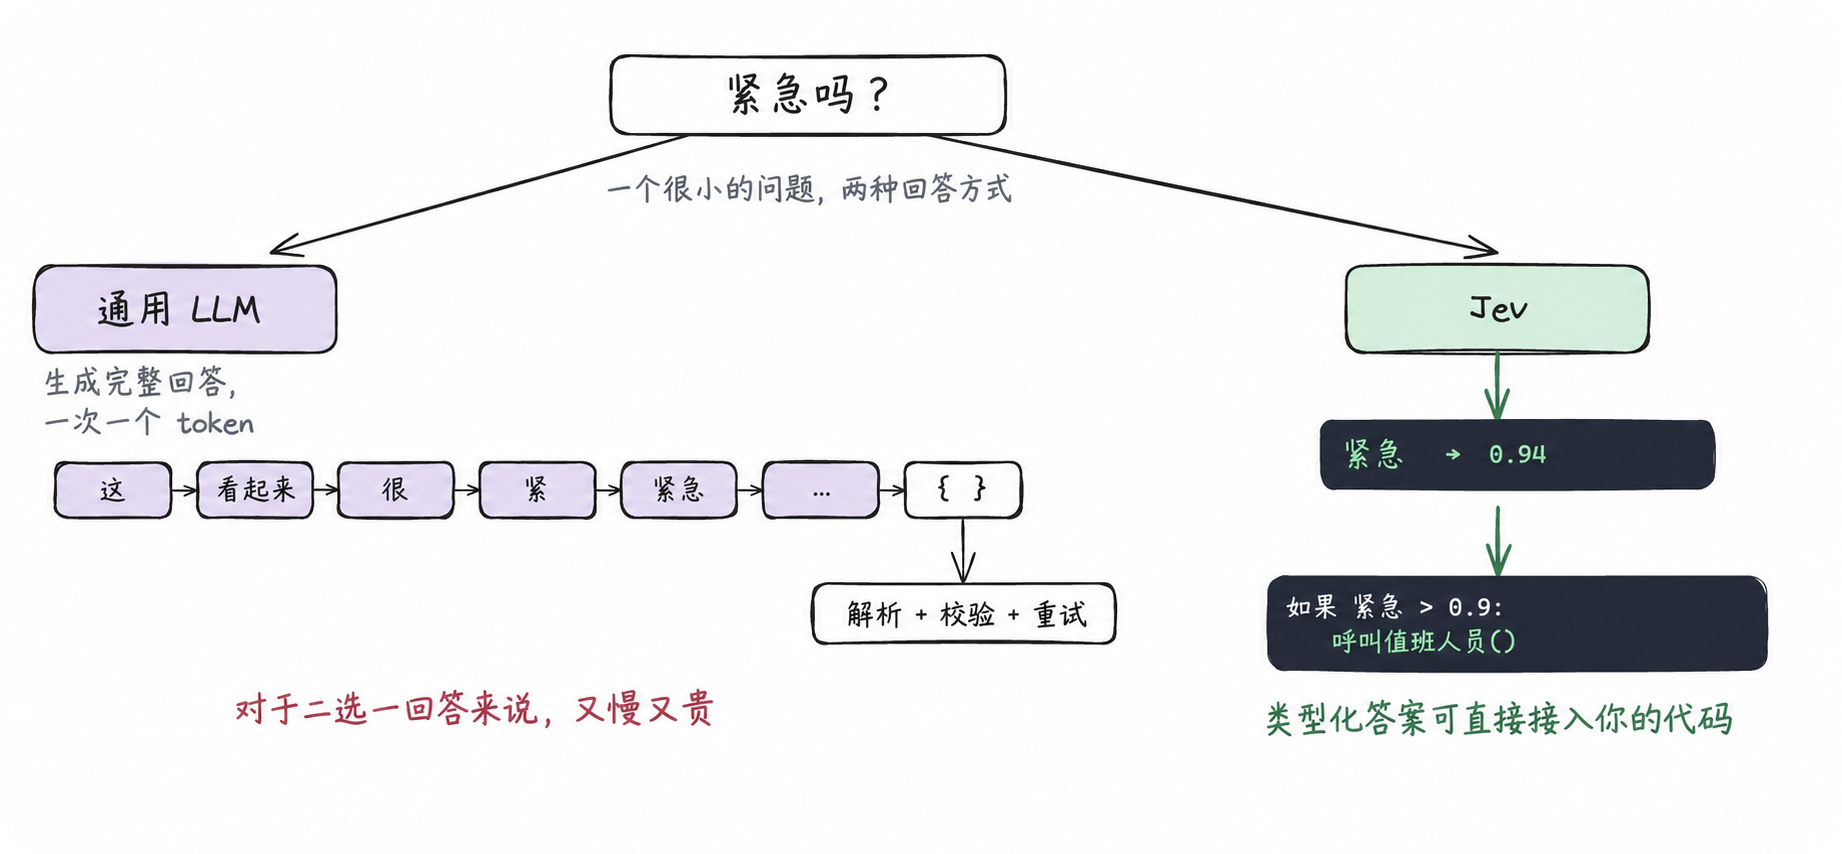
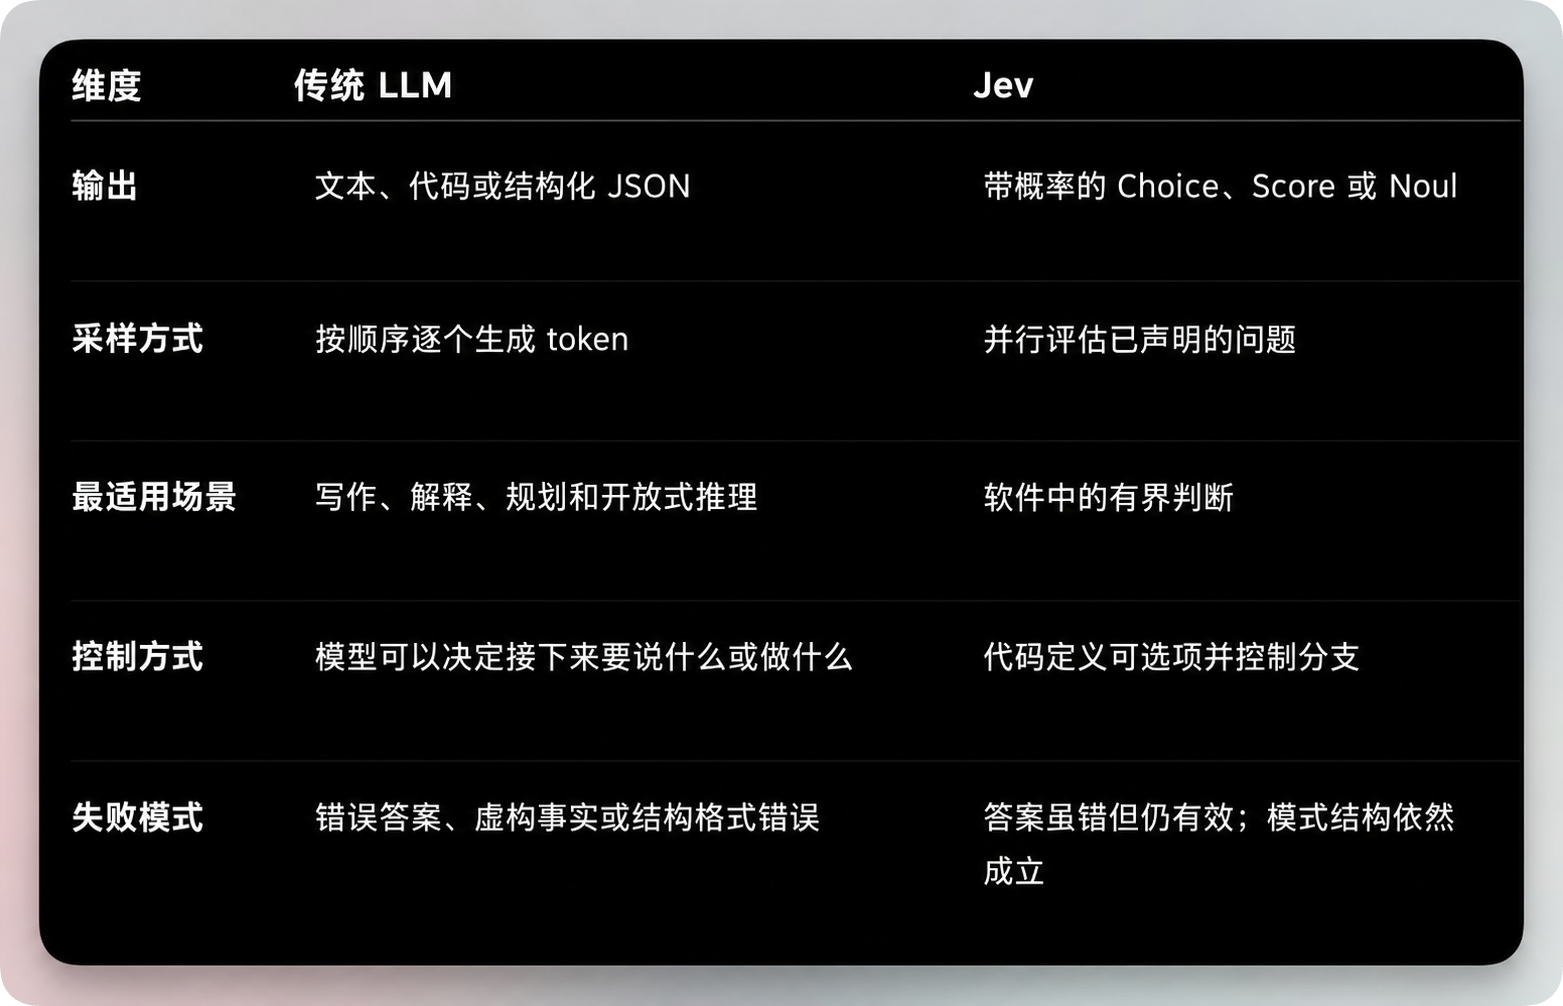
Quando um modelo típico de grande porte recebe uma tarefa, ele gera o texto passo a passo de acordo com o token. Mesmo que o usuário solicite a saída de um texto formatado em JSON semelhante a uma decisão, o modelo ainda precisa lidar com problemas comuns de modelagem de texto, como erros de formatação, inclusões de interpretação e campos ausentes.
O Microsoft-Decision-1 da Microsoft, lançado hoje, é semelhante a modelos de tomada de decisão anteriores. Sua entrada consiste em uma evidência, uma pergunta e um conjunto de opções fixas. O modelo gera a probabilidade de cada opção em uma única passagem direta, e esses resultados são para uso do programa, não para consumo humano.
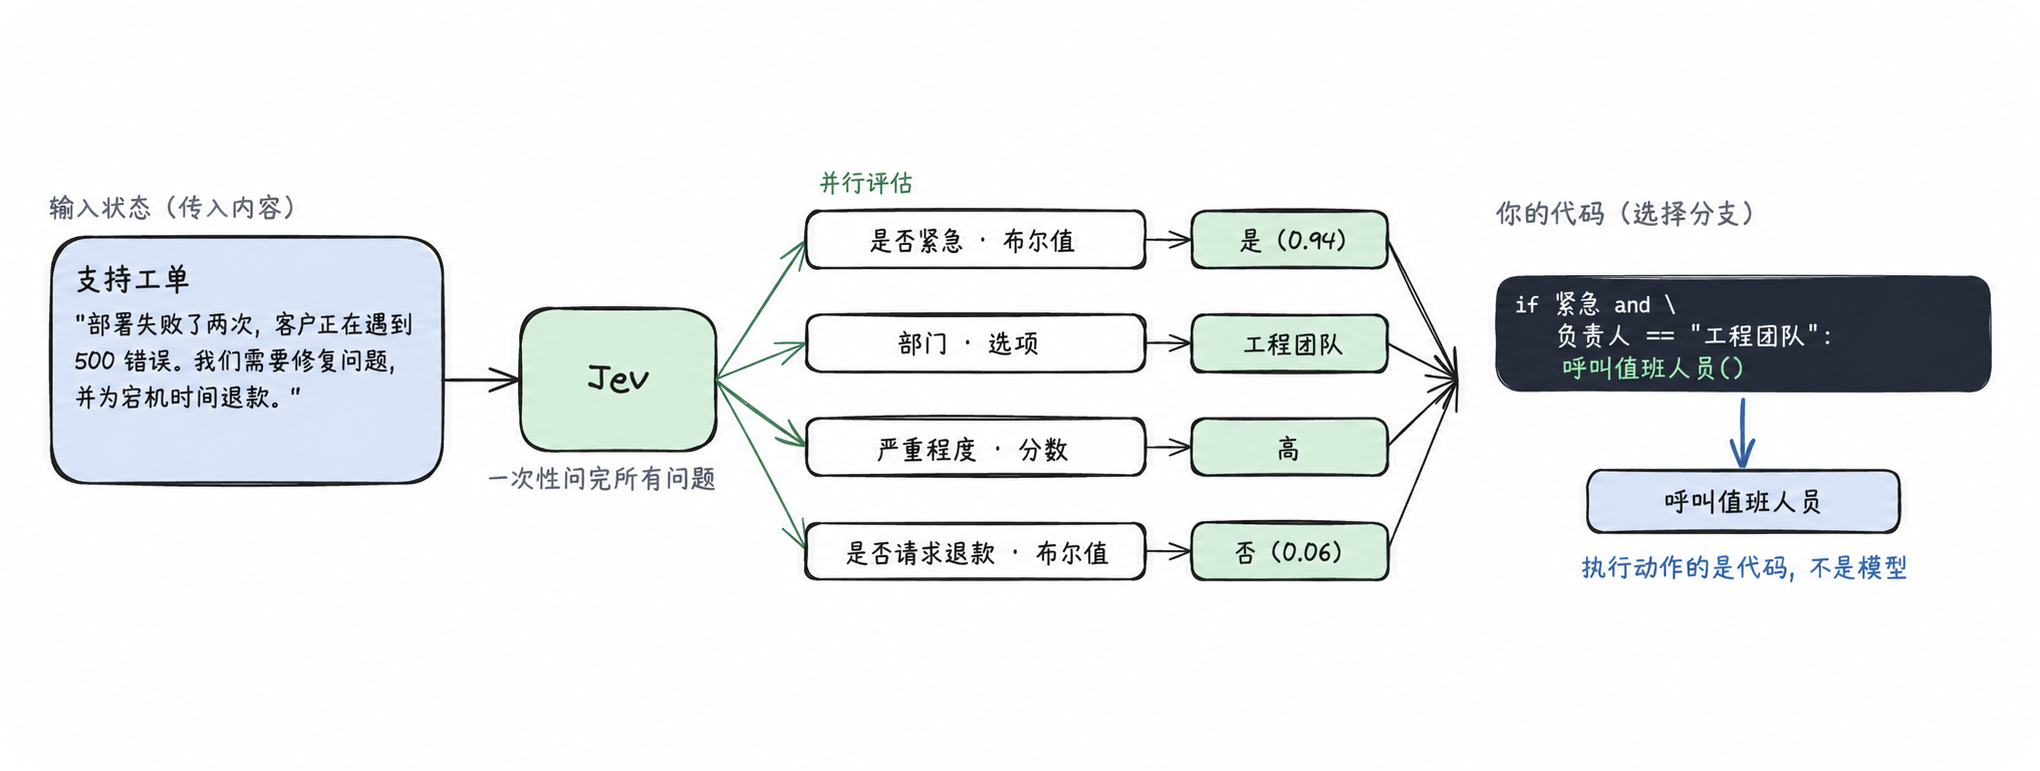
Por exemplo, o agente está pronto para chamar uma ferramenta externa. A Decisão-1 pode fornecer probabilidades para "continuar a execução", "tentar novamente", "trocar de ferramenta" e "transferir para intervenção humana". O aplicativo então decide o próximo passo com base em um limite predefinido.
- Se o nível de confiança for suficientemente alto, execute diretamente;
- Se várias opções forem semelhantes, submeta-as a um modelo maior;
- Se aparecer a mensagem "não é possível determinar", a solicitação será encaminhada para um revisor humano.
Atualmente, o Decision-1 suporta respostas sim/não, seleção múltipla, pontuação e classificação. Ele também pode pontuar respostas de IA ou ações de agentes de acordo com um conjunto de regras. Pode processar um máximo de 32 mil tokens por vez, com entrada e saída em texto e JSON, sem gerar explicações ou processos de raciocínio.
Este modelo é baseado no Qwen3.5-9B e foi treinado pela Microsoft. Os dados de treinamento provêm de conjuntos de dados públicos que passaram pelo processo de Dados Abertos da Microsoft, bem como de dados sintéticos gerados pela equipe.
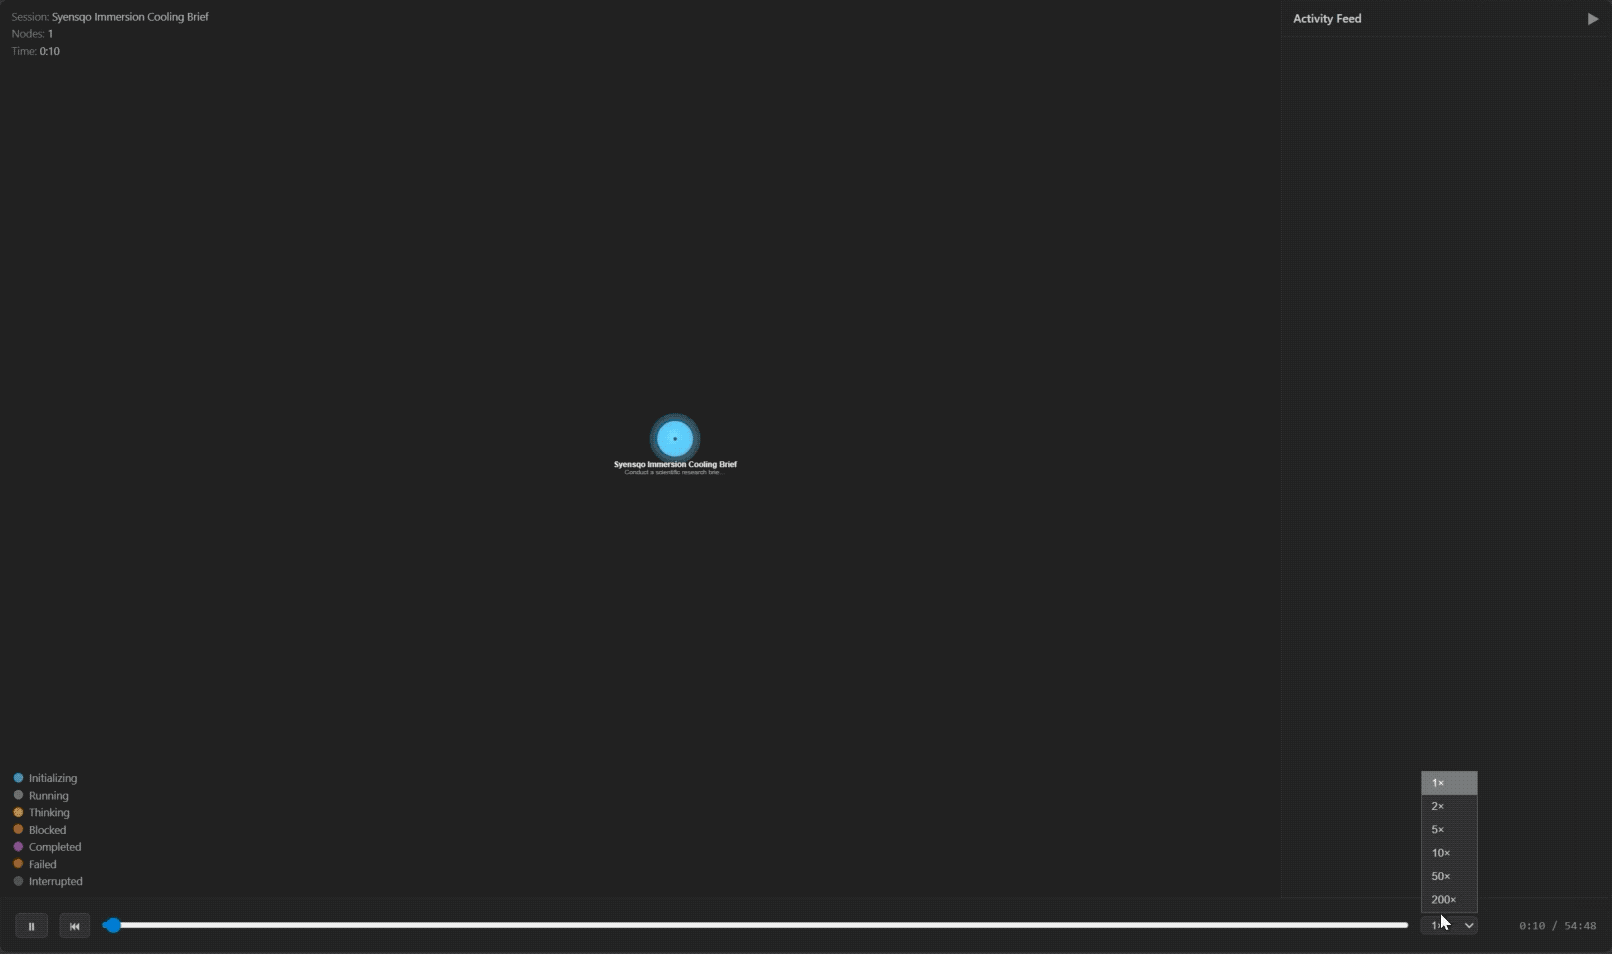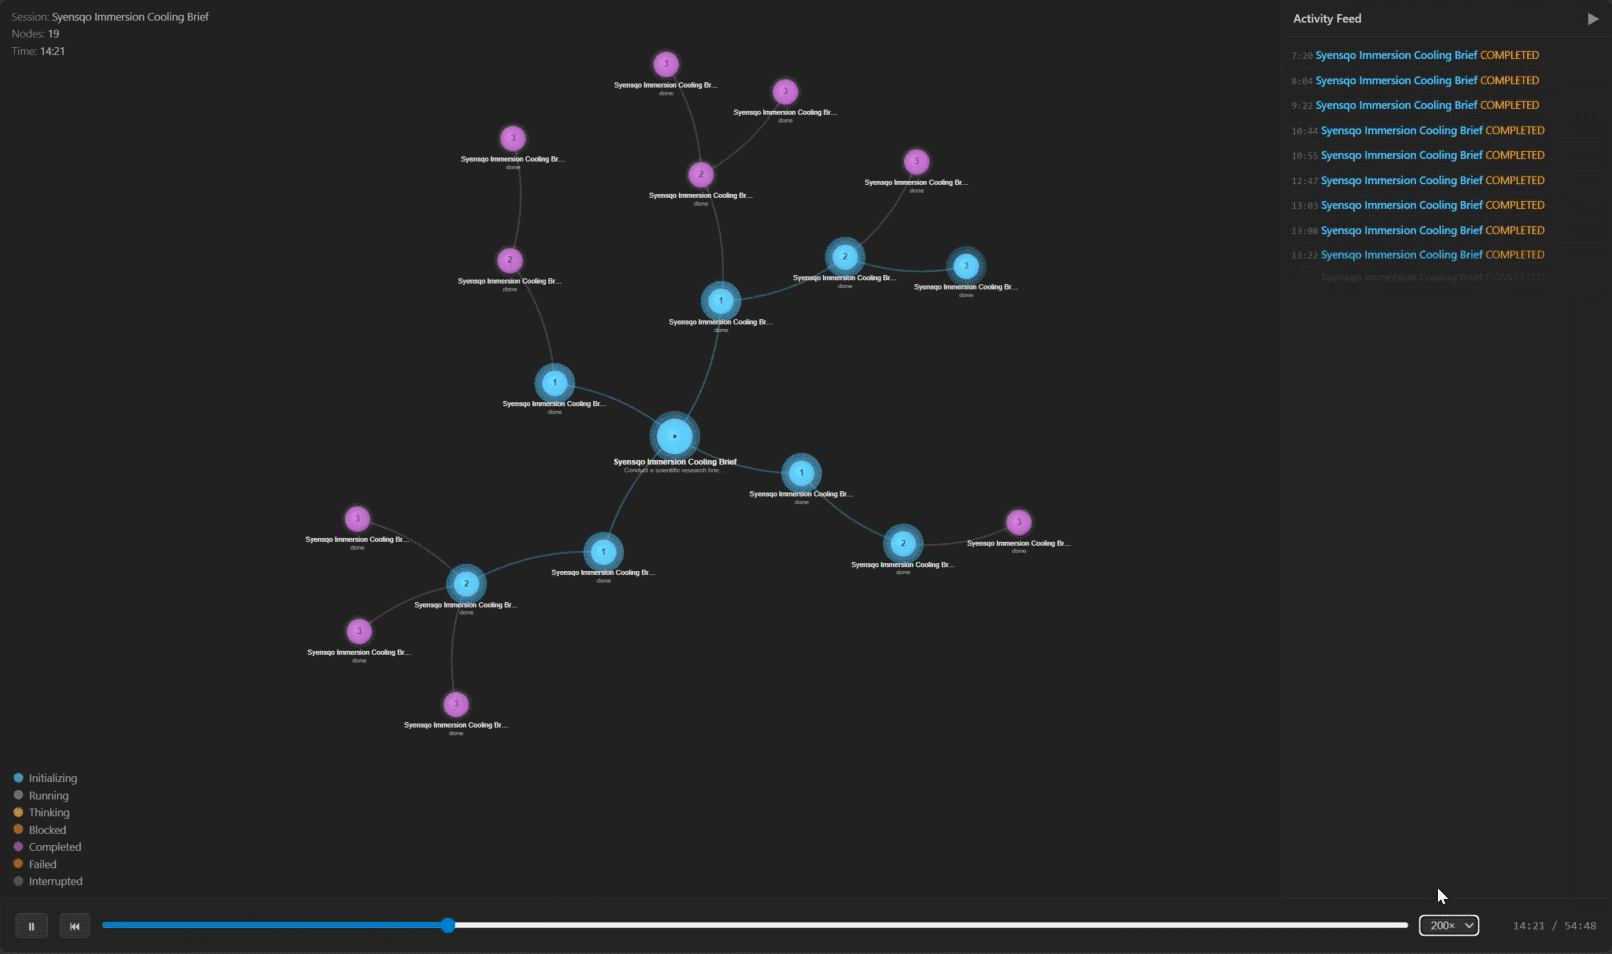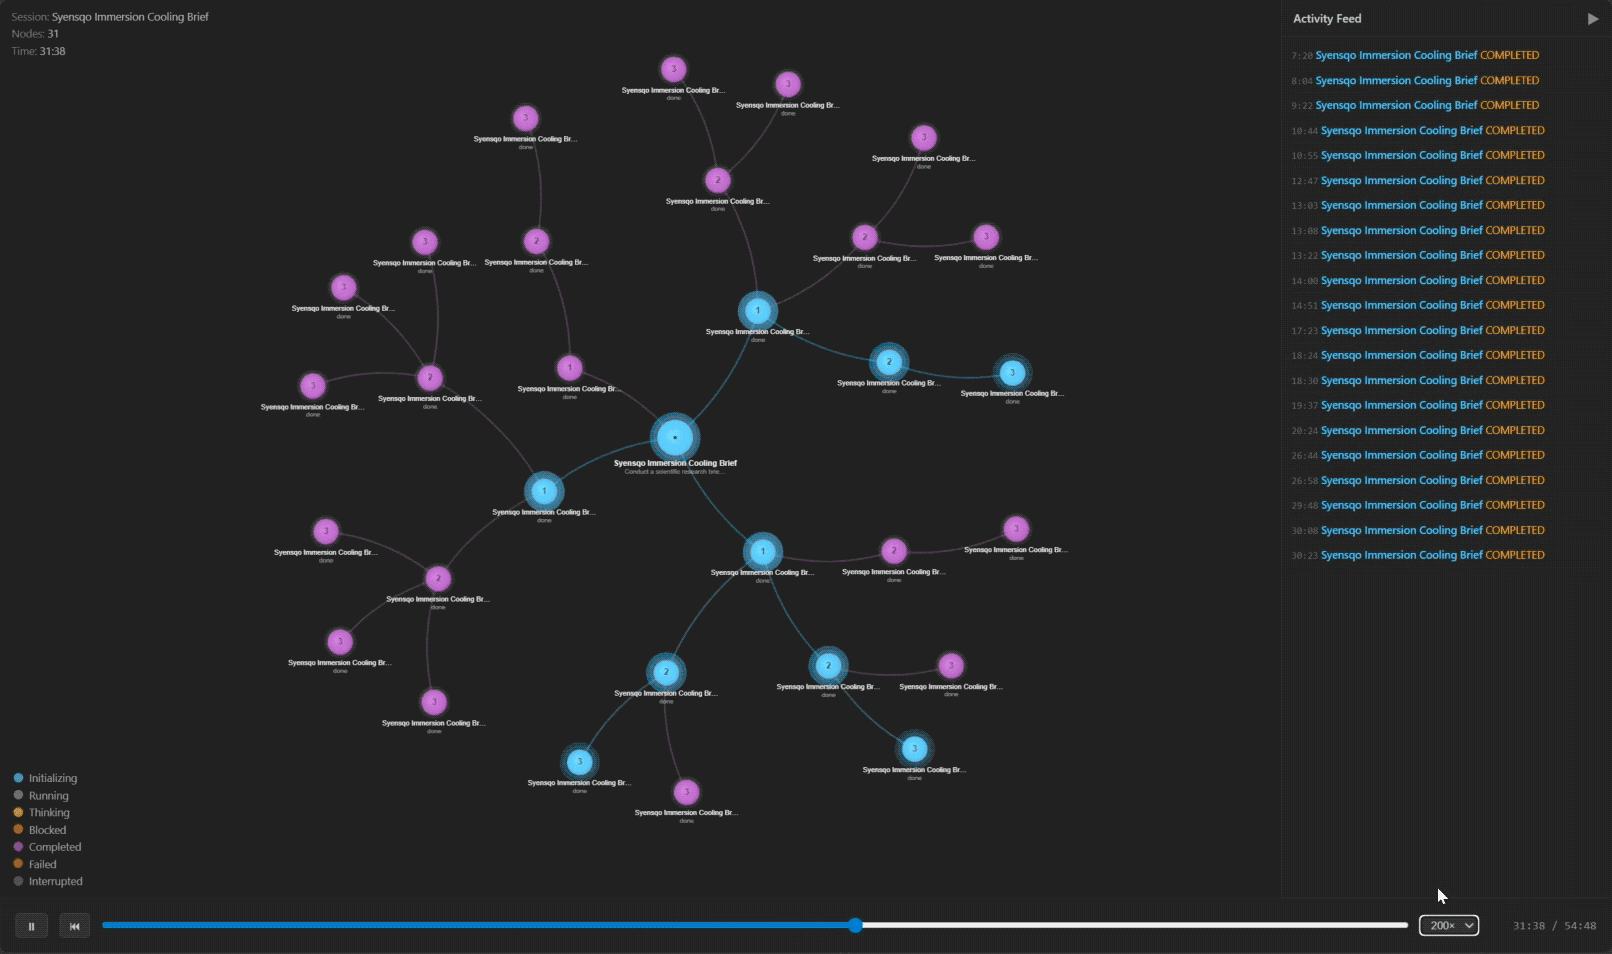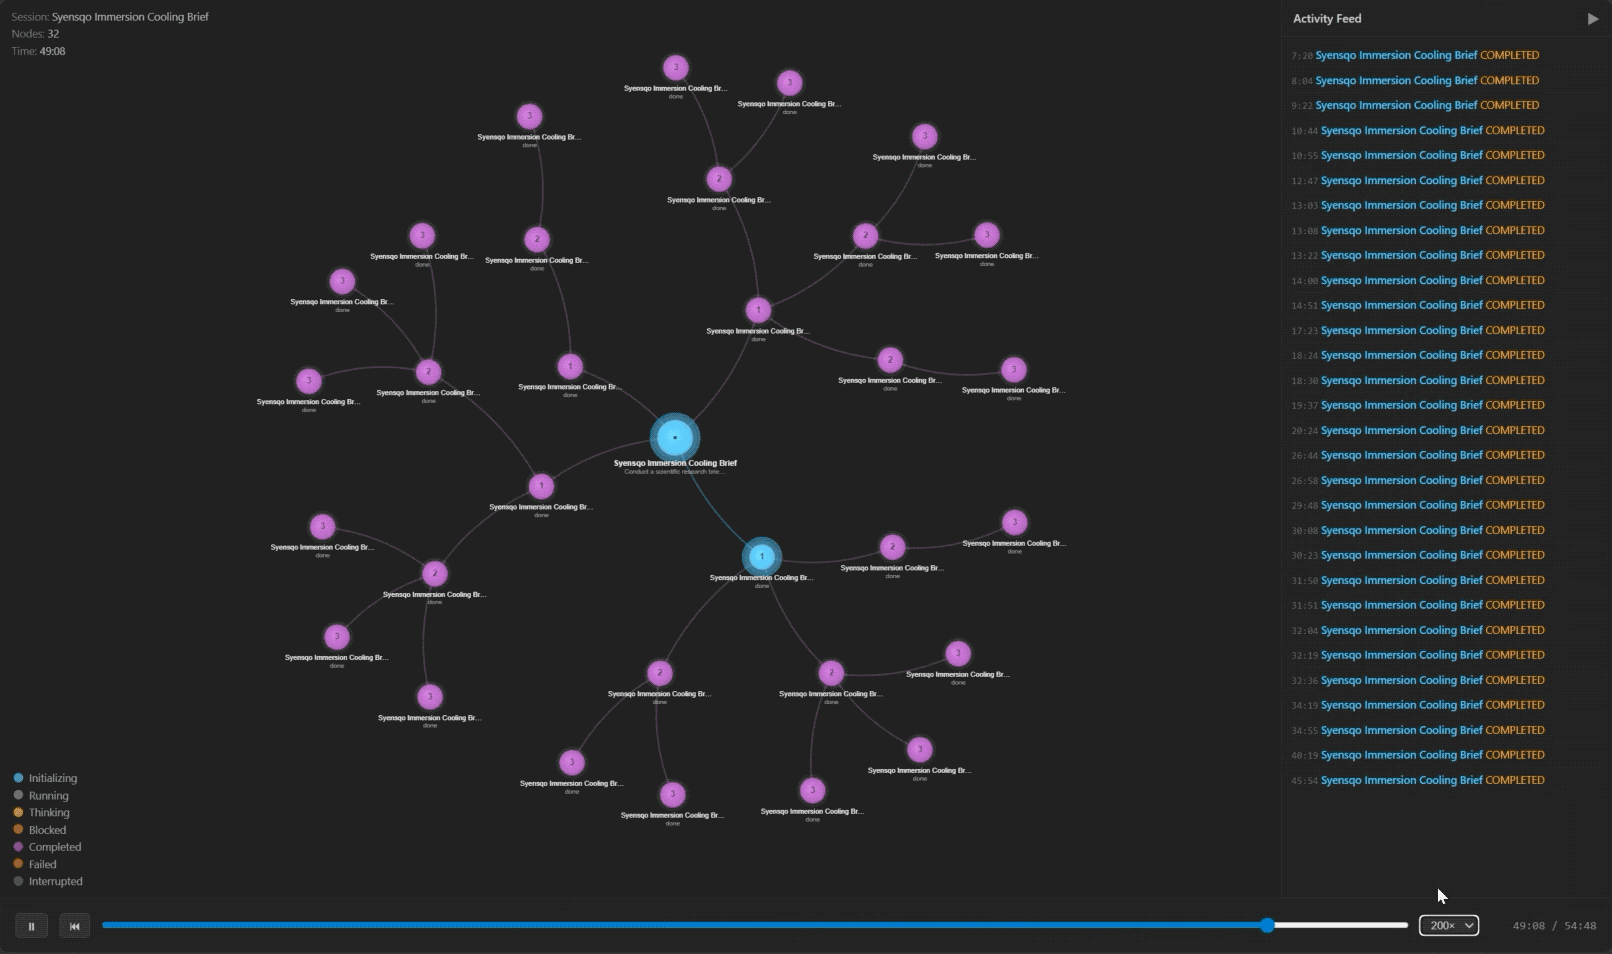
Em resumo, sua função se assemelha mais à de um avaliador: o modelo principal é responsável por propor soluções, e o Decision-1 é responsável por verificar se as soluções atendem às condições; o modelo principal é responsável por redigir as respostas, e o Decision-1 é responsável por determinar se as respostas podem ser entregues.
É muito provável que esses tipos de modelos de tomada de decisão permaneçam como uma camada da infraestrutura de agentes, mas não substituirão os grandes modelos tradicionais.
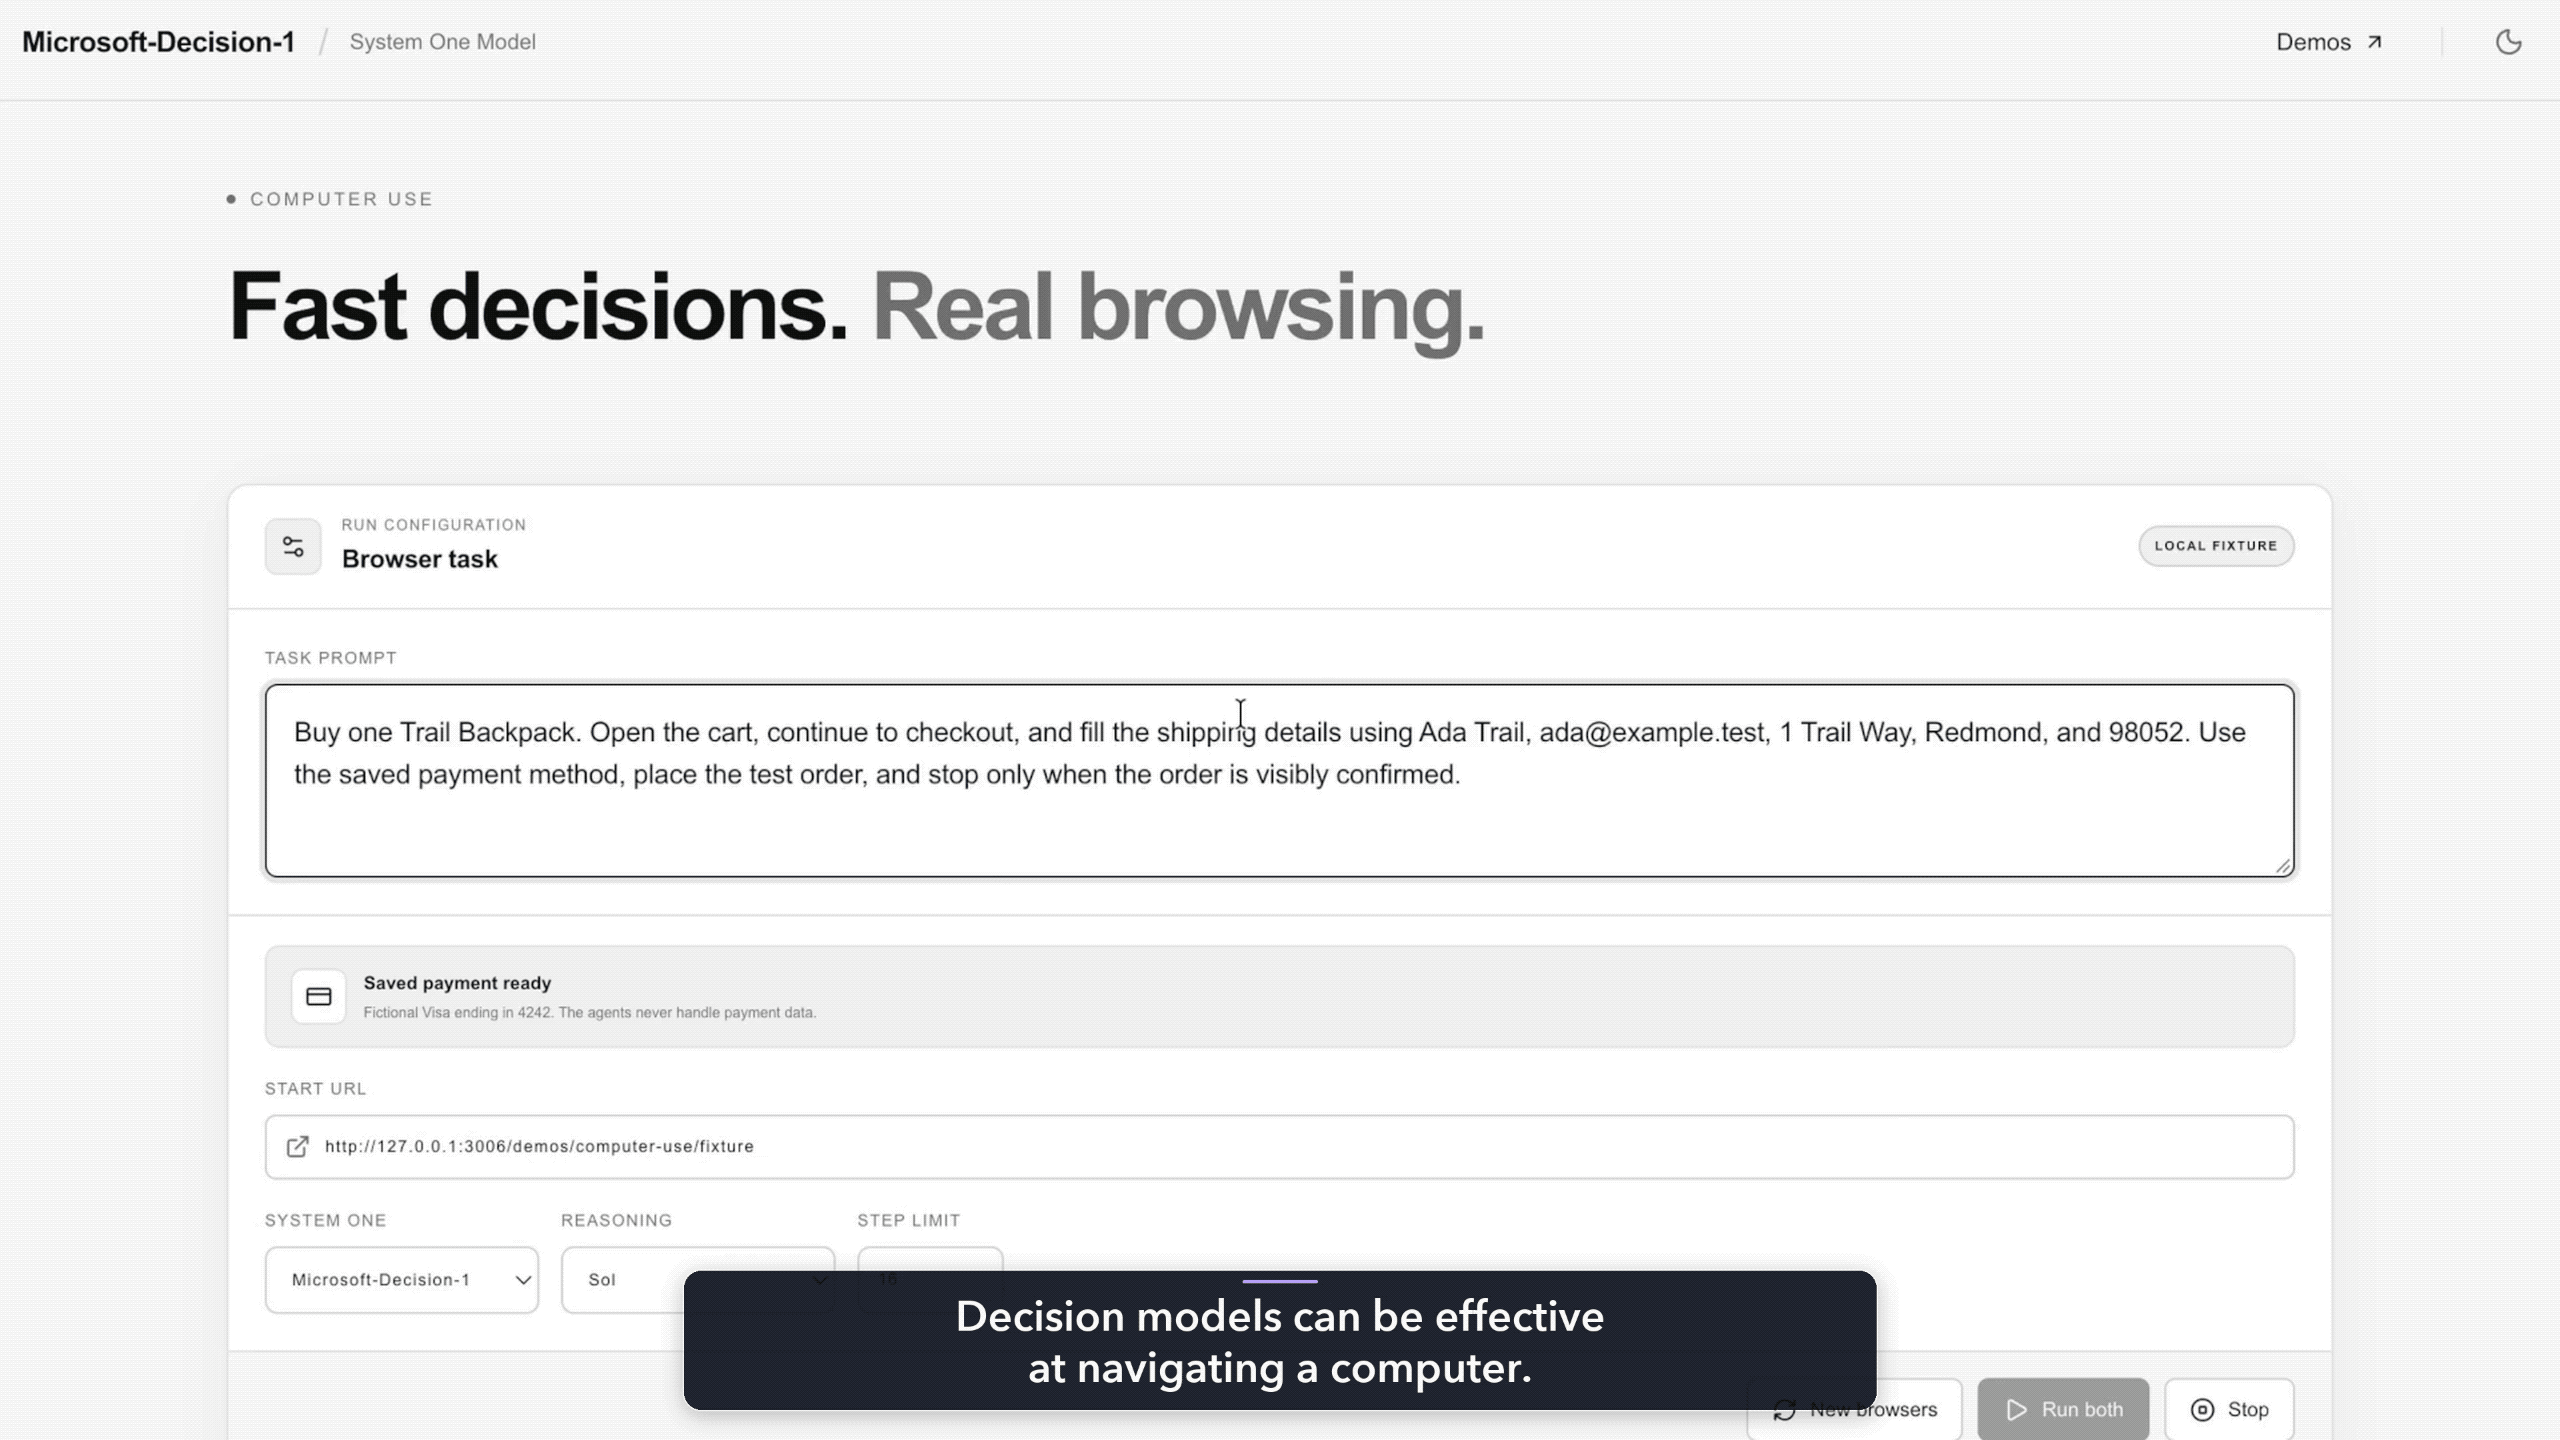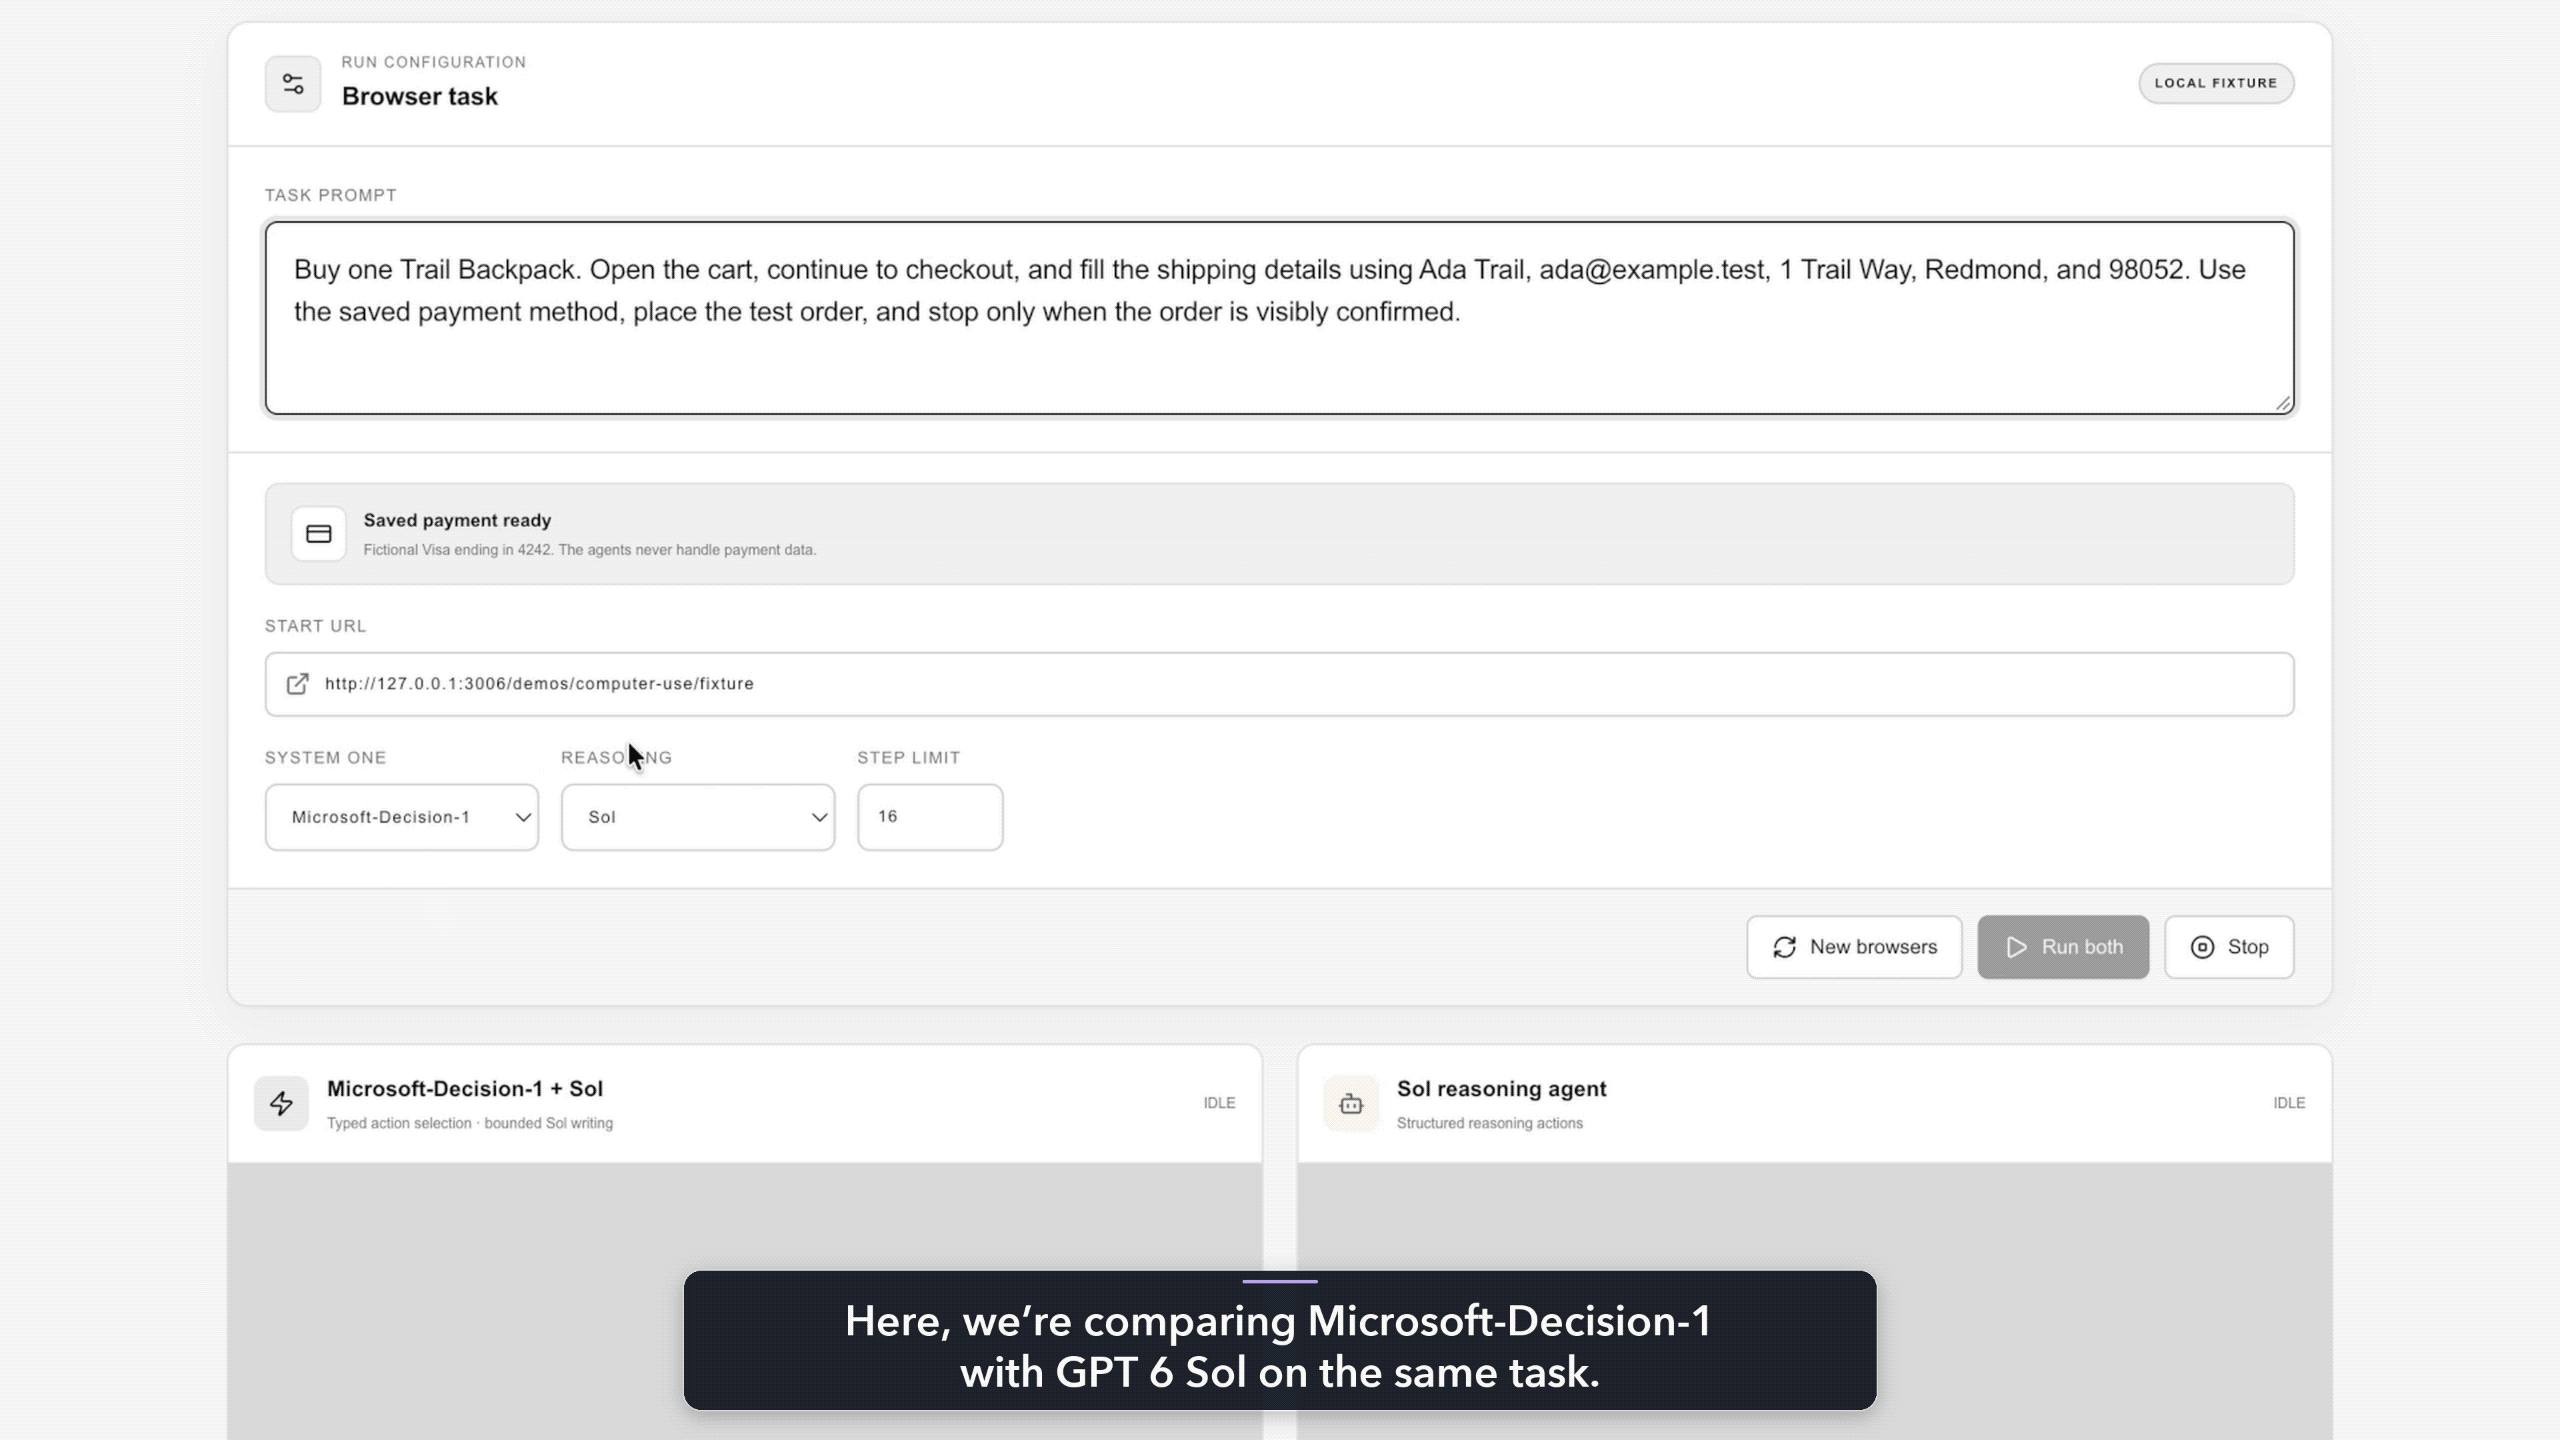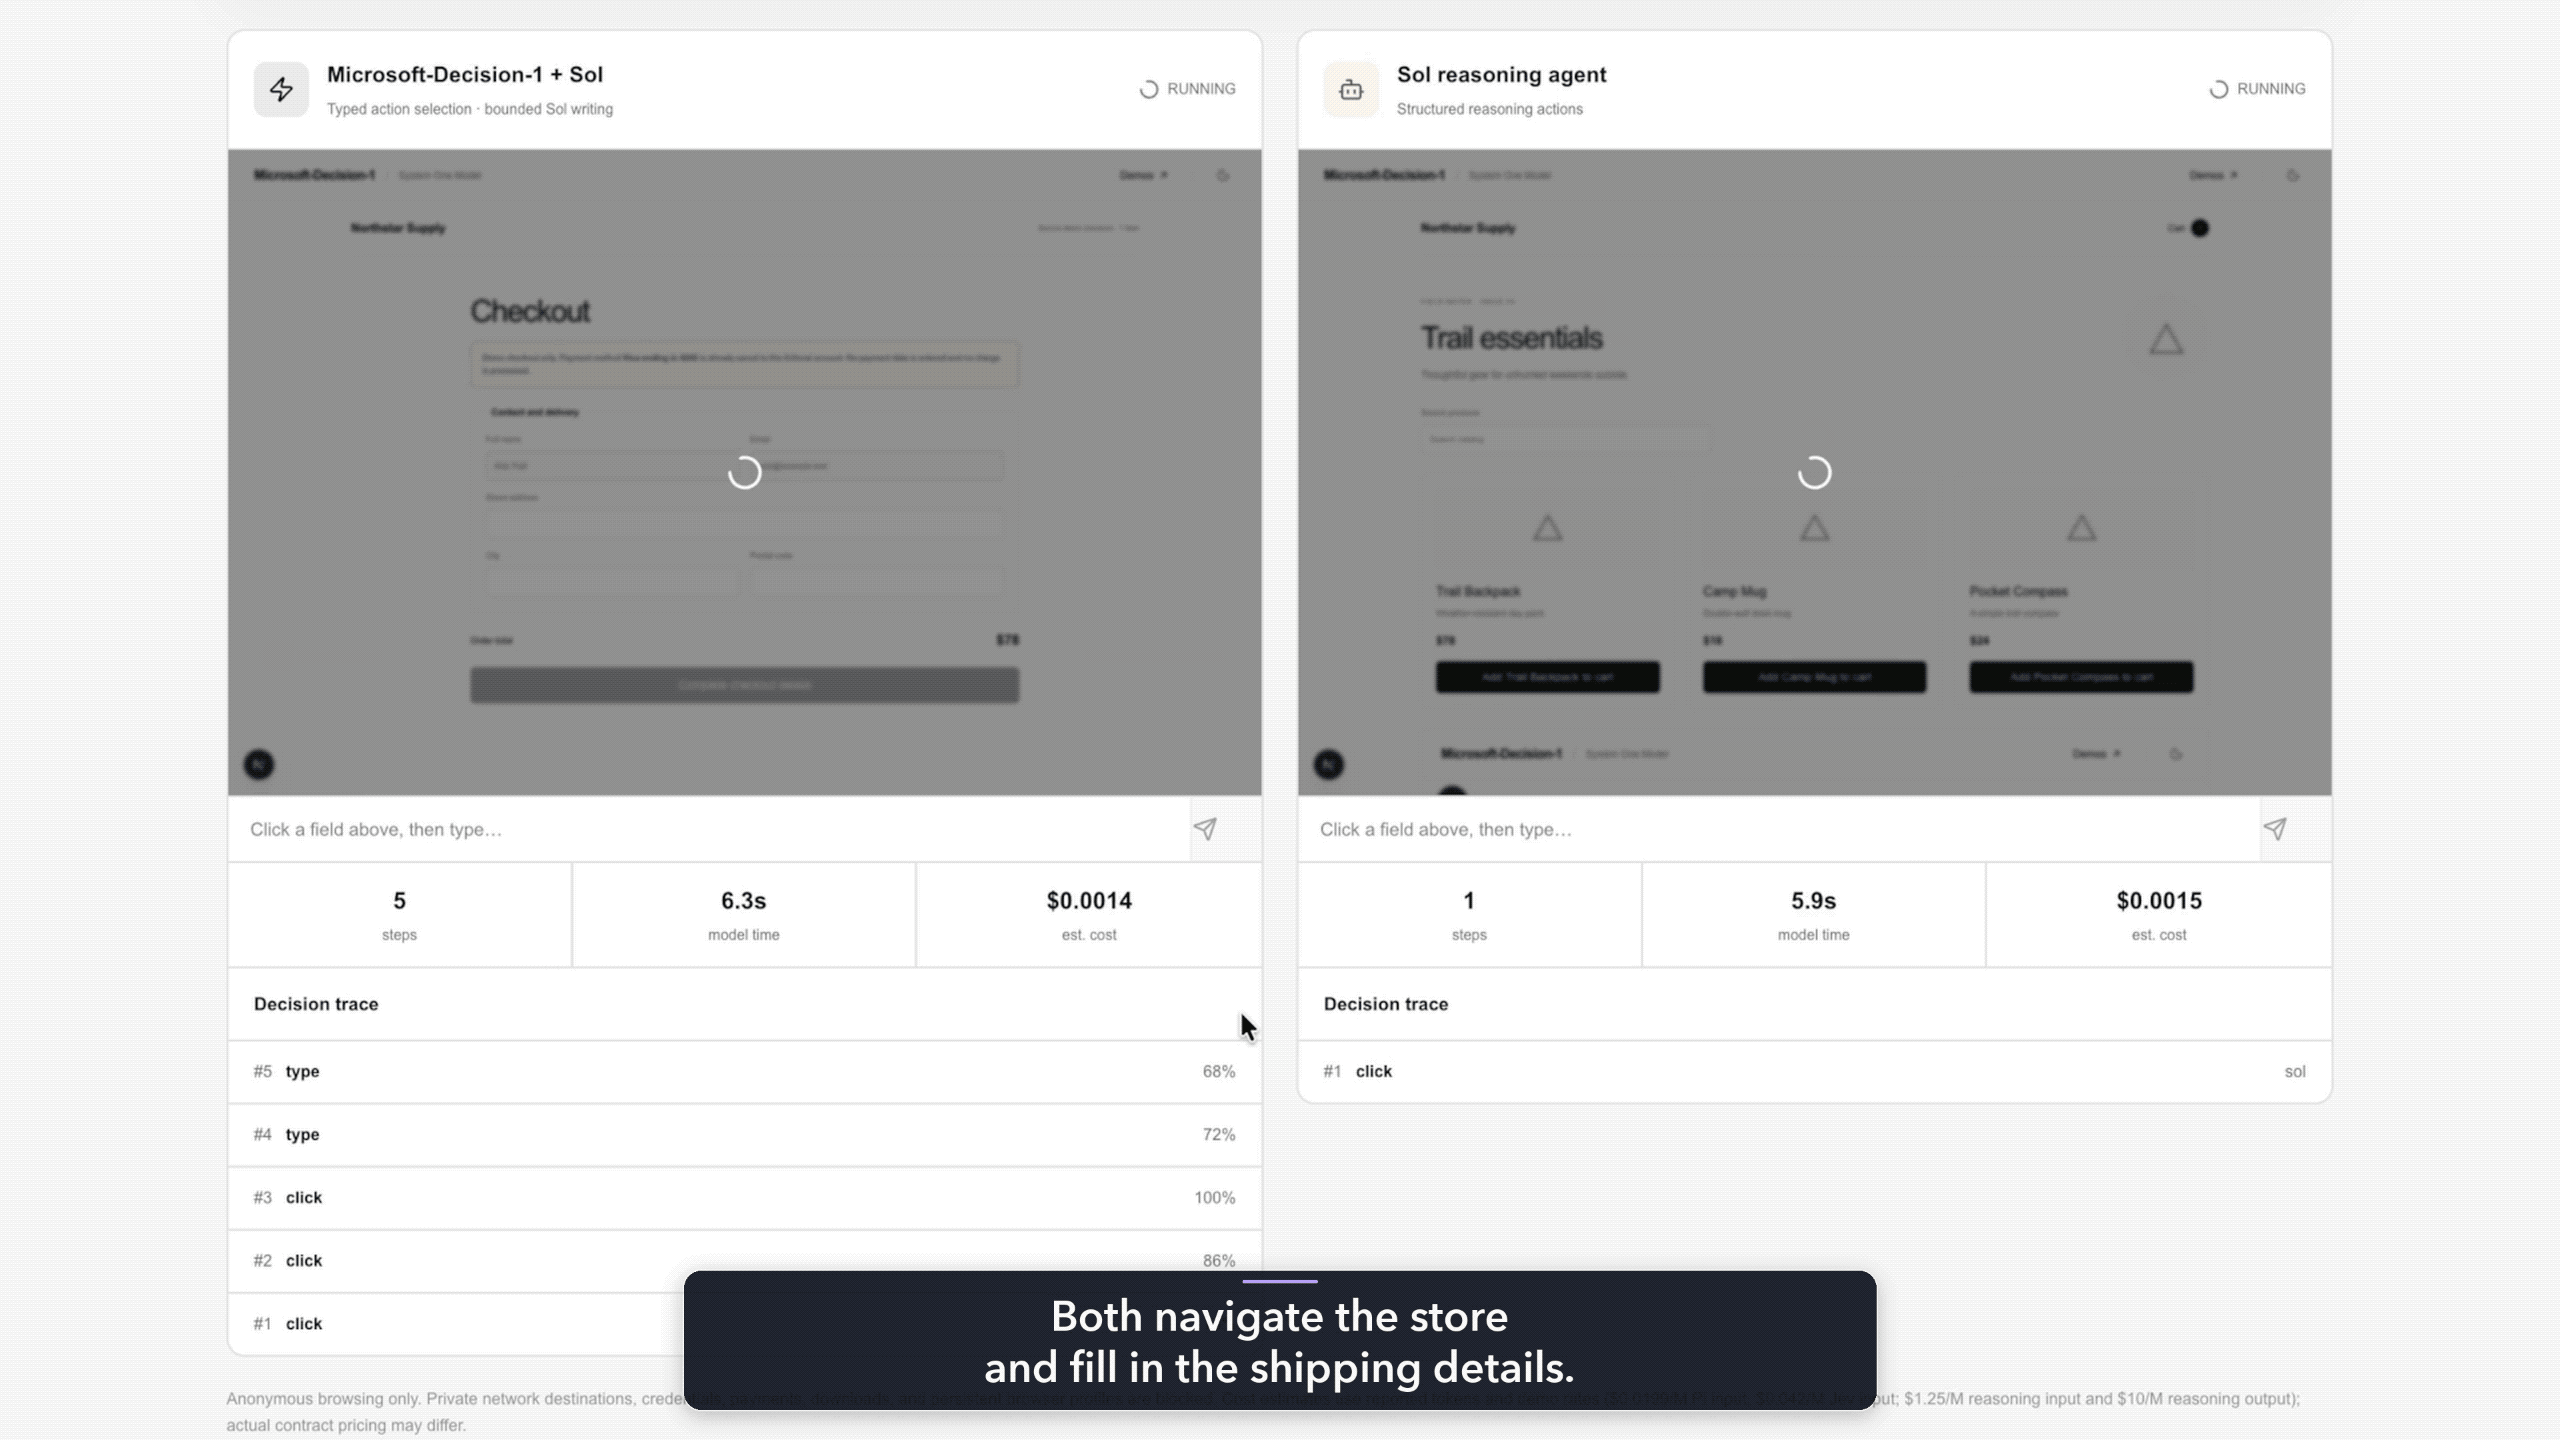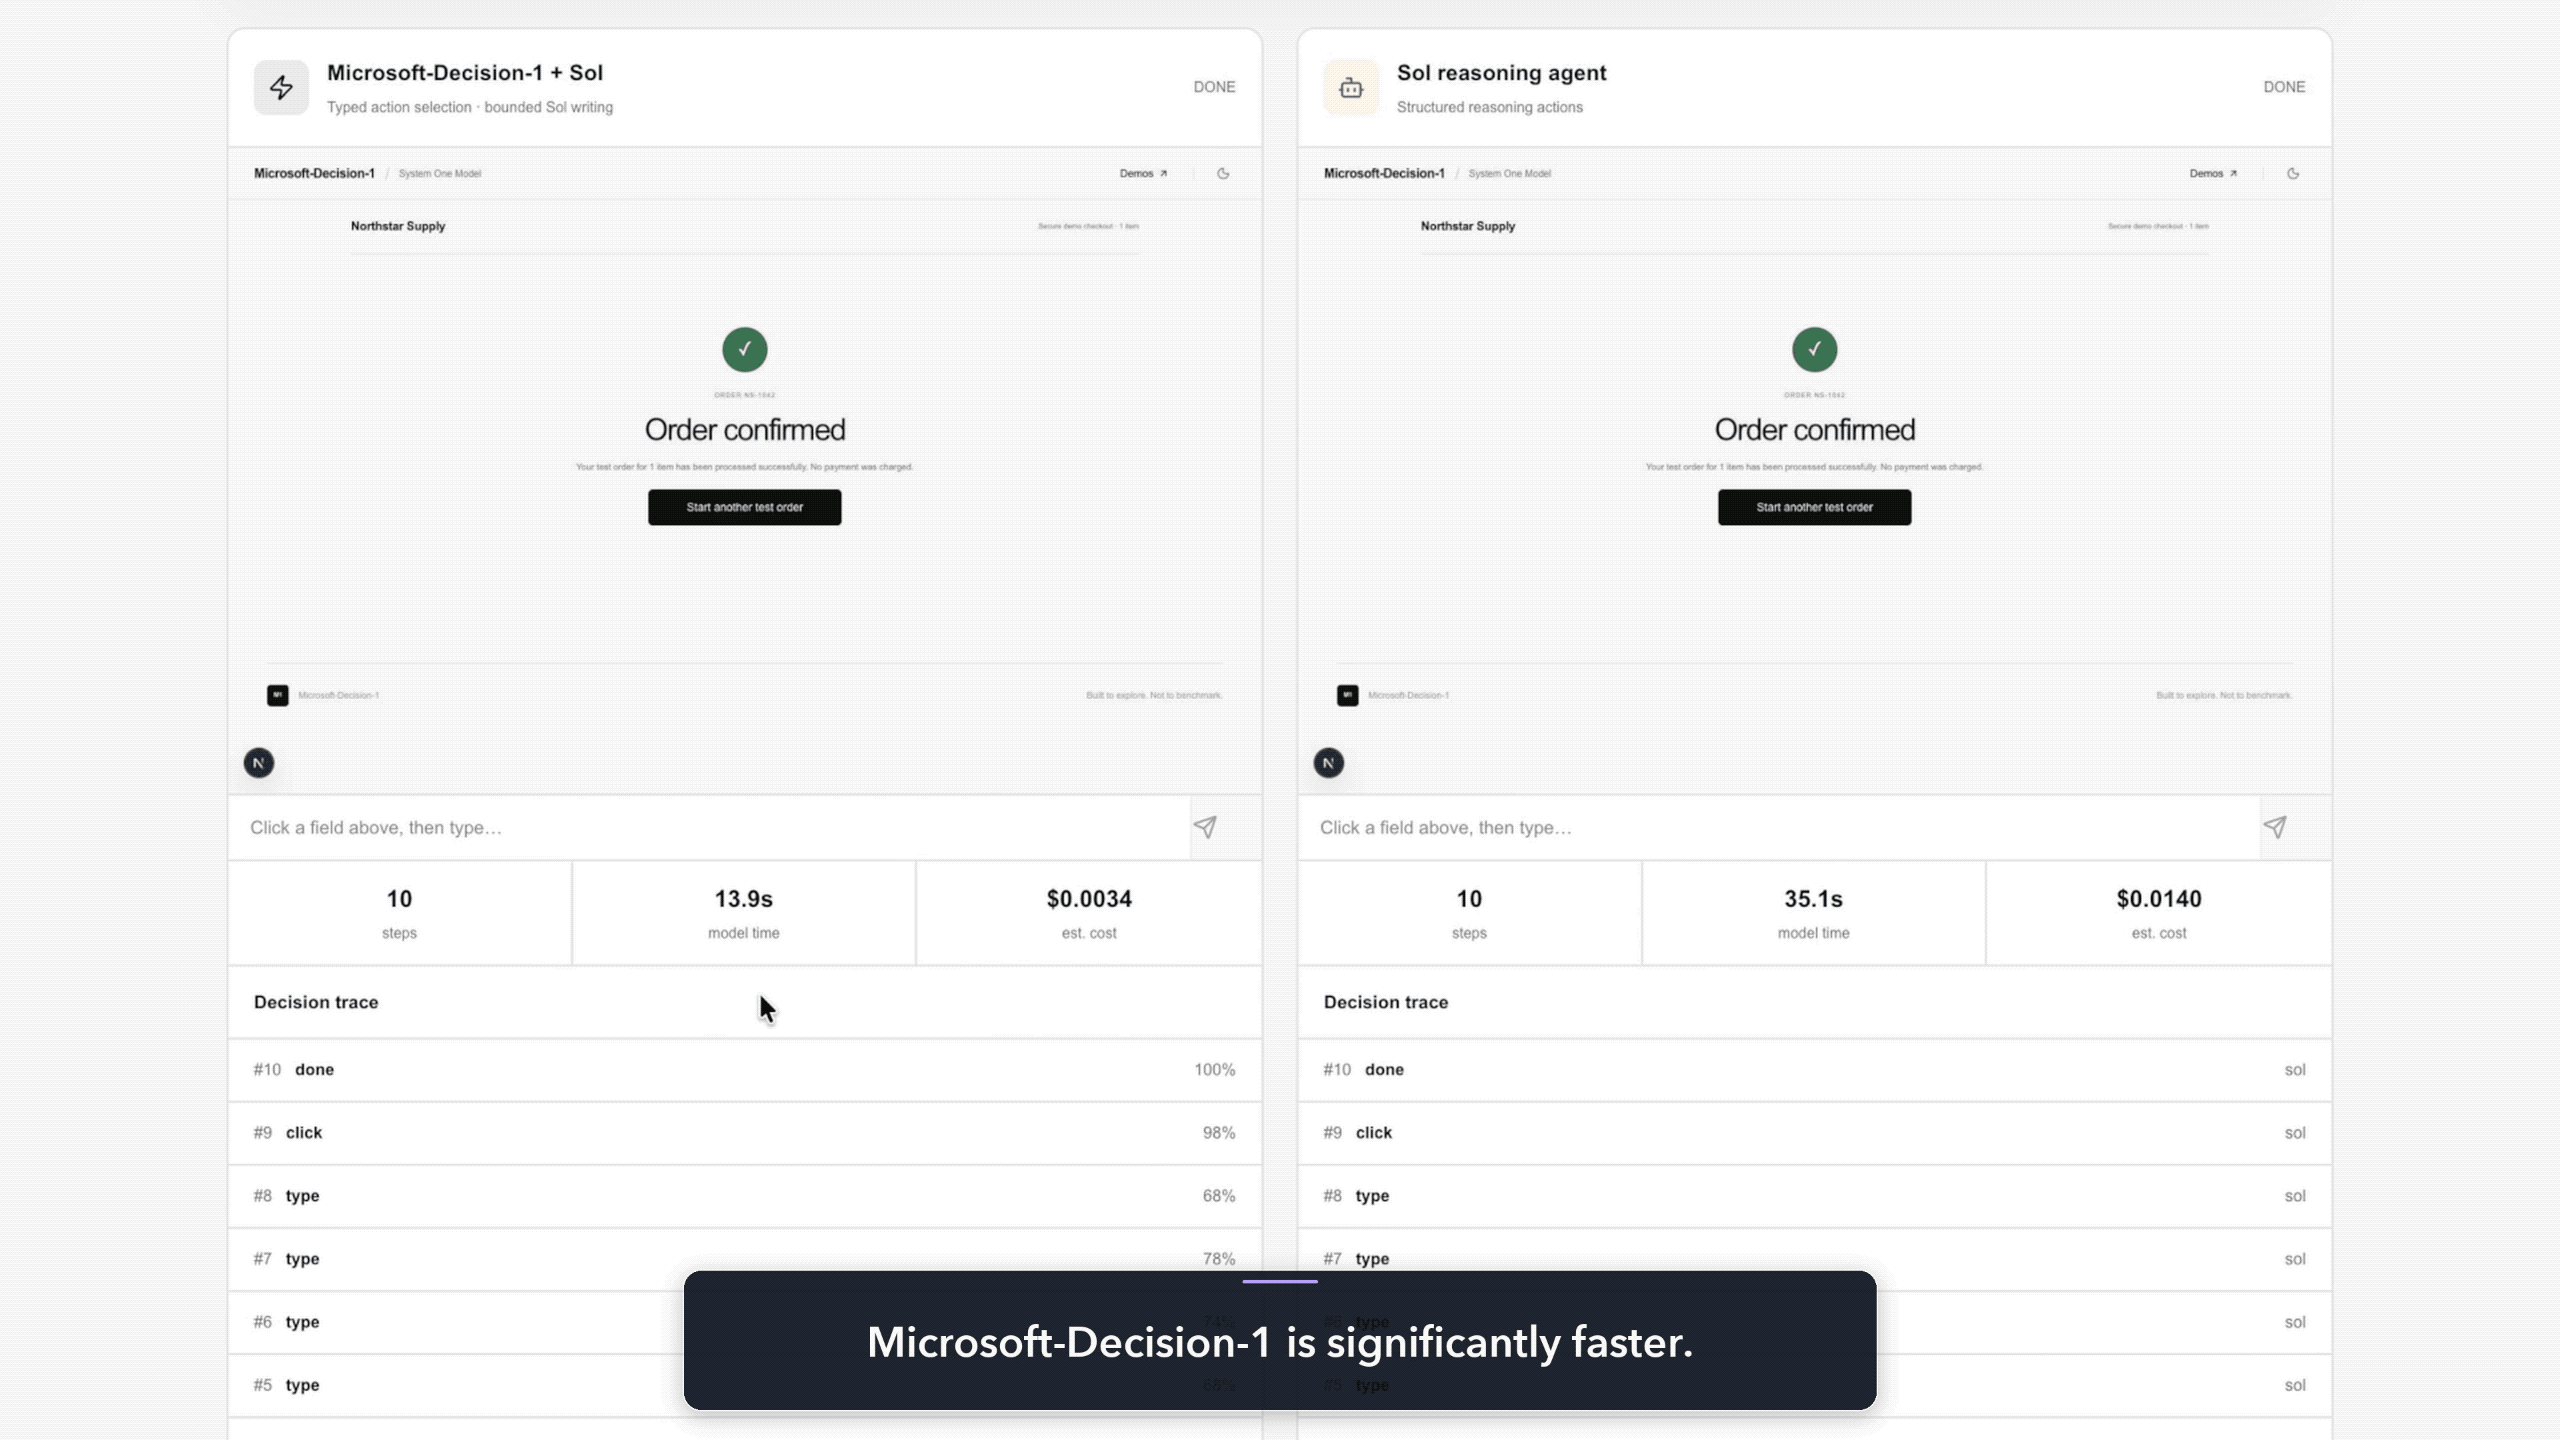
A Microsoft mencionou em seu blog técnico que o Decision-1 alcançou a maior precisão em 36 conjuntos de testes e quase 150.000 perguntas, sendo 4,5 vezes mais rápido que o Quyet-1.0-Large e 35 vezes mais rápido que o GPT-6 Sol.
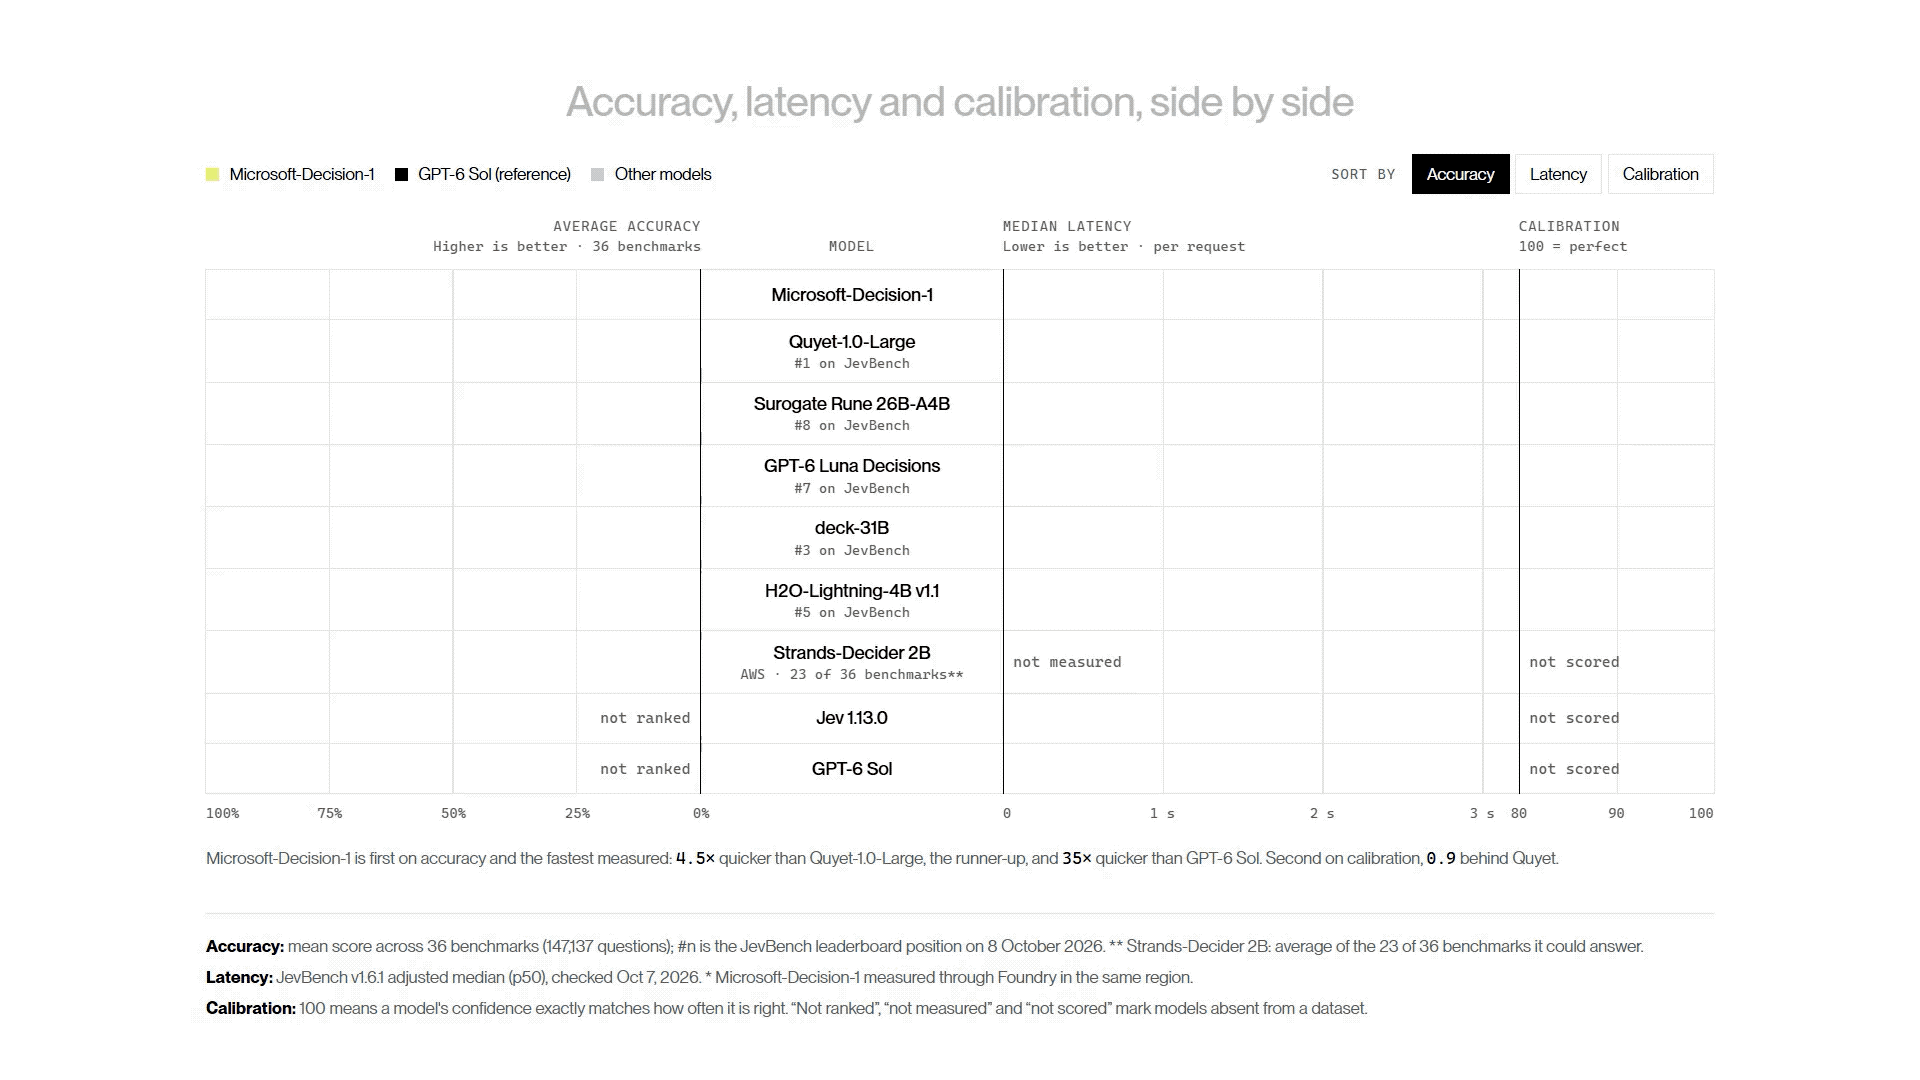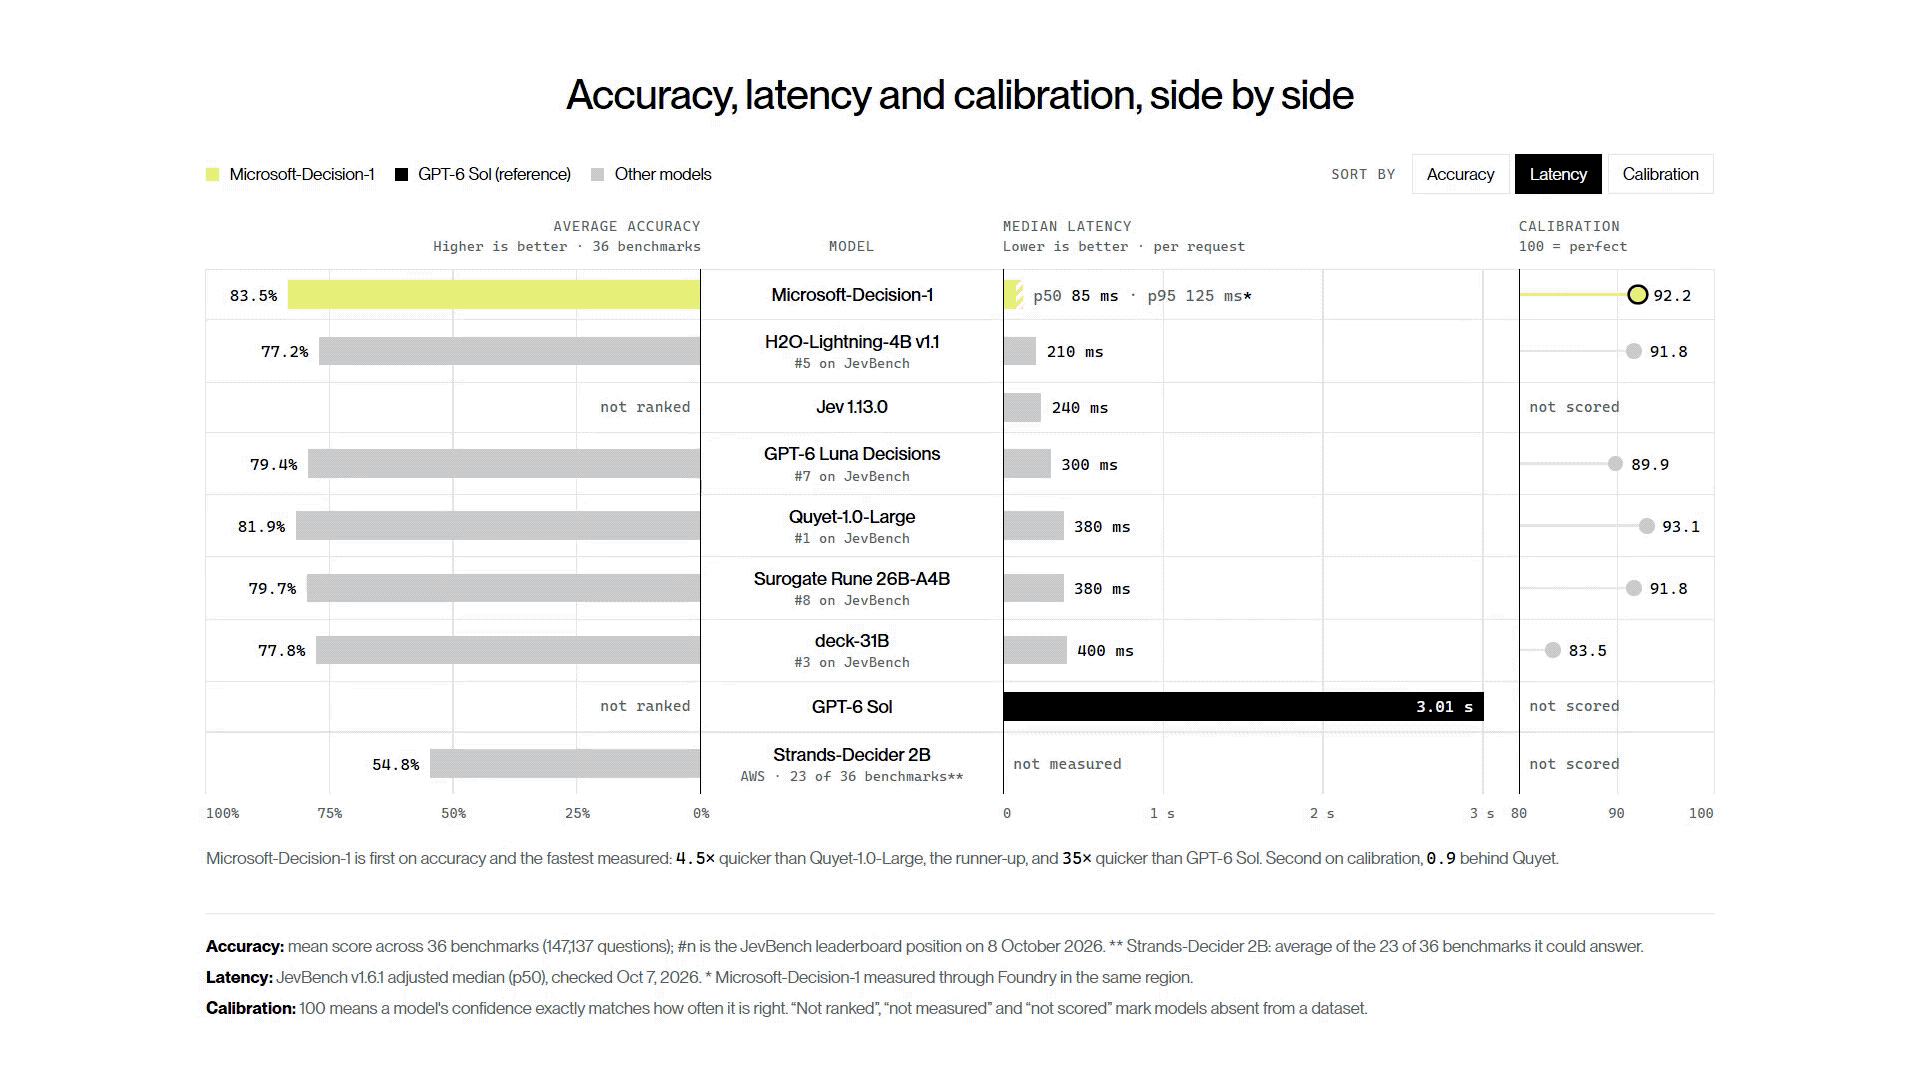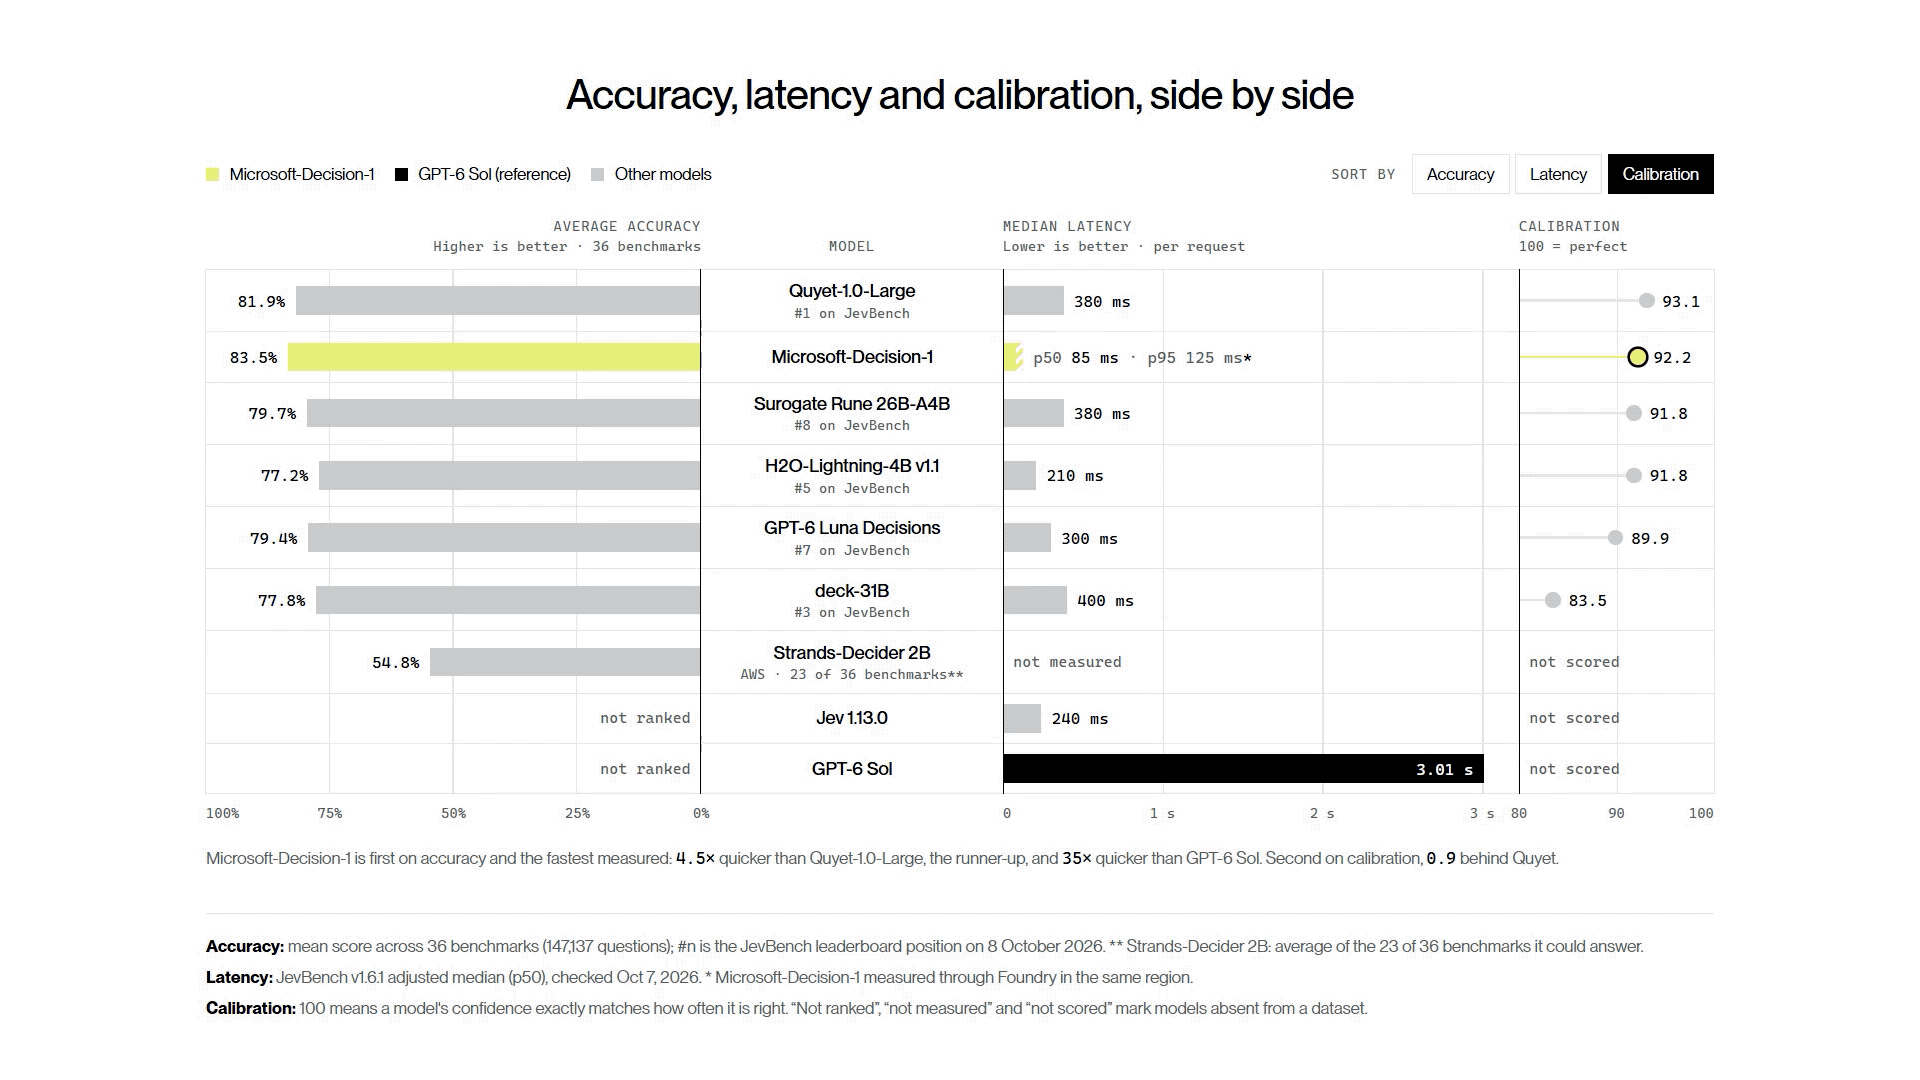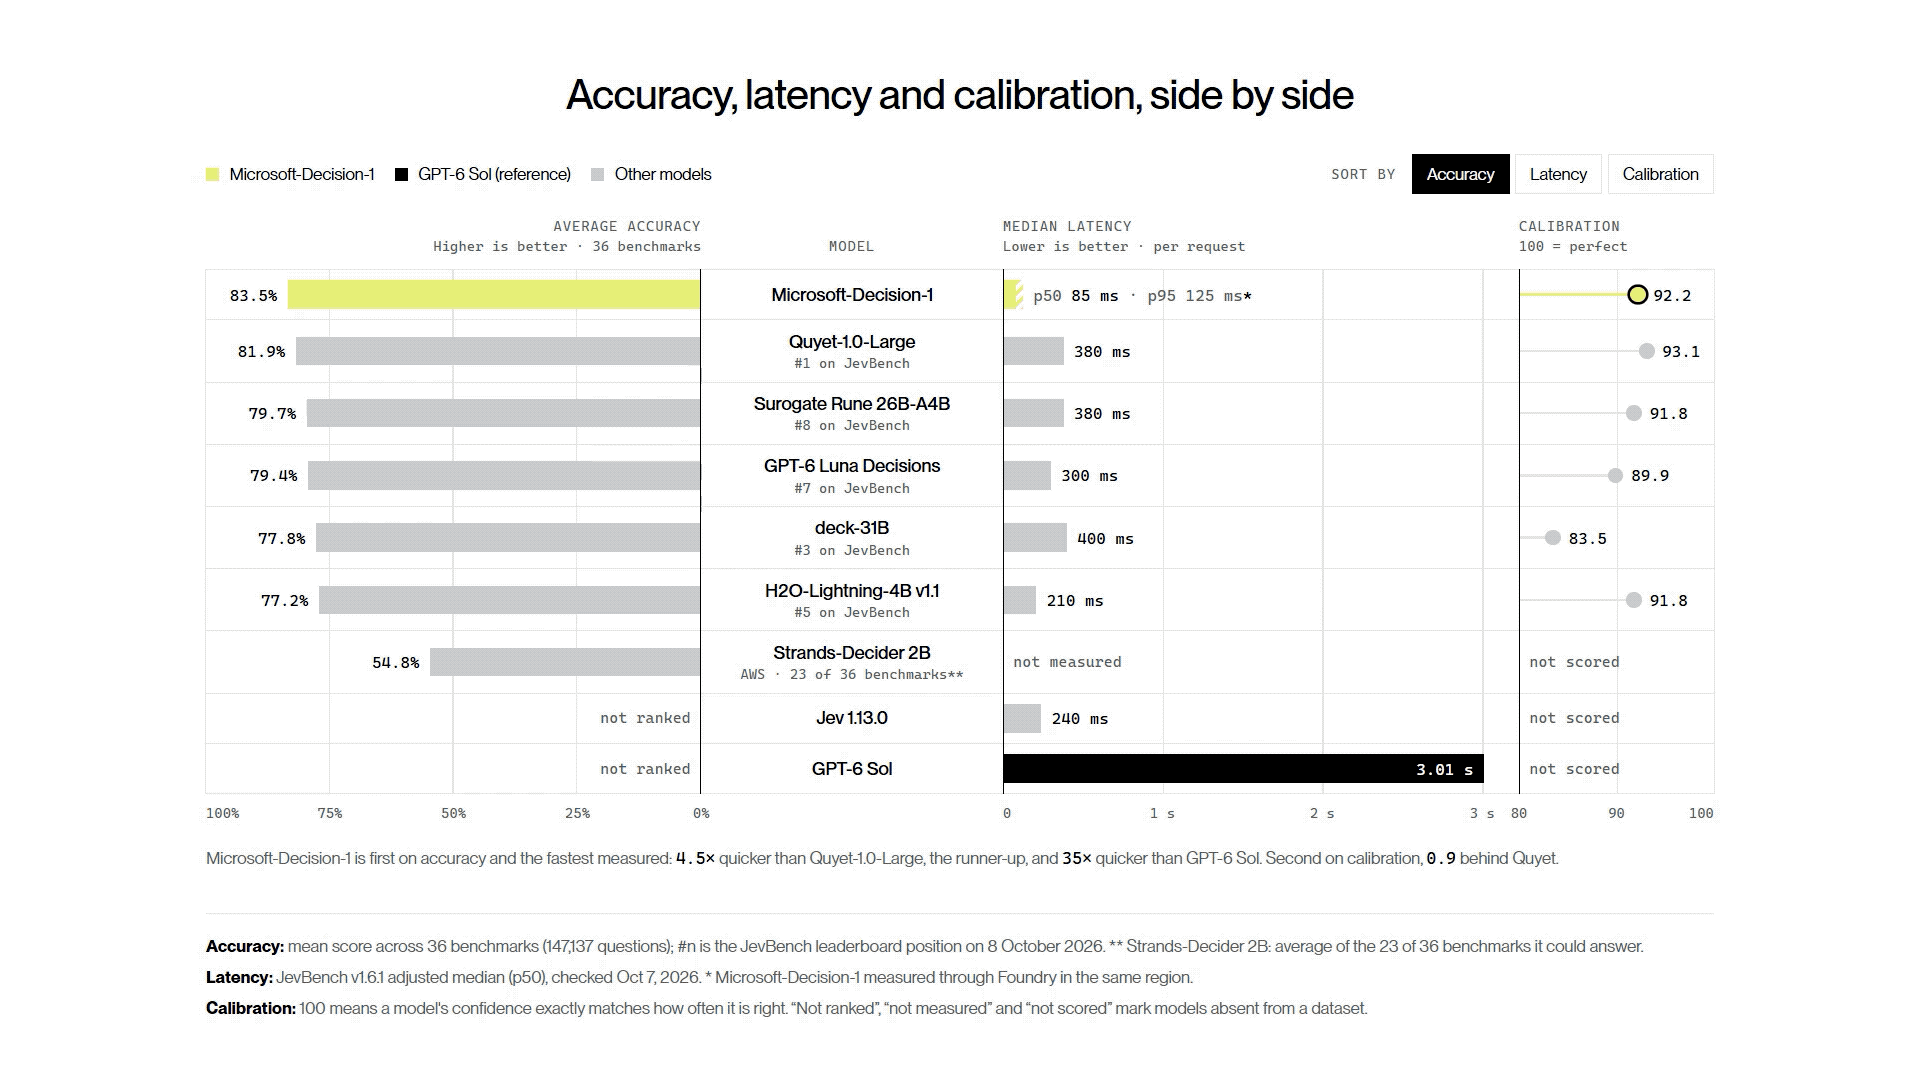
Além da precisão e da latência, o grande diferencial do Microsoft Decision-1 é sua probabilidade de calibração. Quando o modelo afirma ter 90% de certeza e de fato cumpre essa promessa, podemos definir um limite: acima de 90%, ele executa automaticamente; abaixo de 90%, ele passa a exigir intervenção manual ou a utilizar um modelo mais robusto.
OpenAI está avançando com um produto semelhante: a API de Decisões, que foi apresentada anteriormente na conferência de desenvolvedores e agora está oficialmente aberta para testes beta públicos, com tecnologia GPT-6 Luna.
A ferramenta permite determinar a probabilidade de determinadas condições serem atendidas com base em texto e imagens, selecionar opções predefinidas ou atribuir pontuações de acordo com critérios específicos. Pode ser utilizada em tarefas como triagem de reclamações, inspeção de imagens, encaminhamento de modelos e avaliação de riscos.
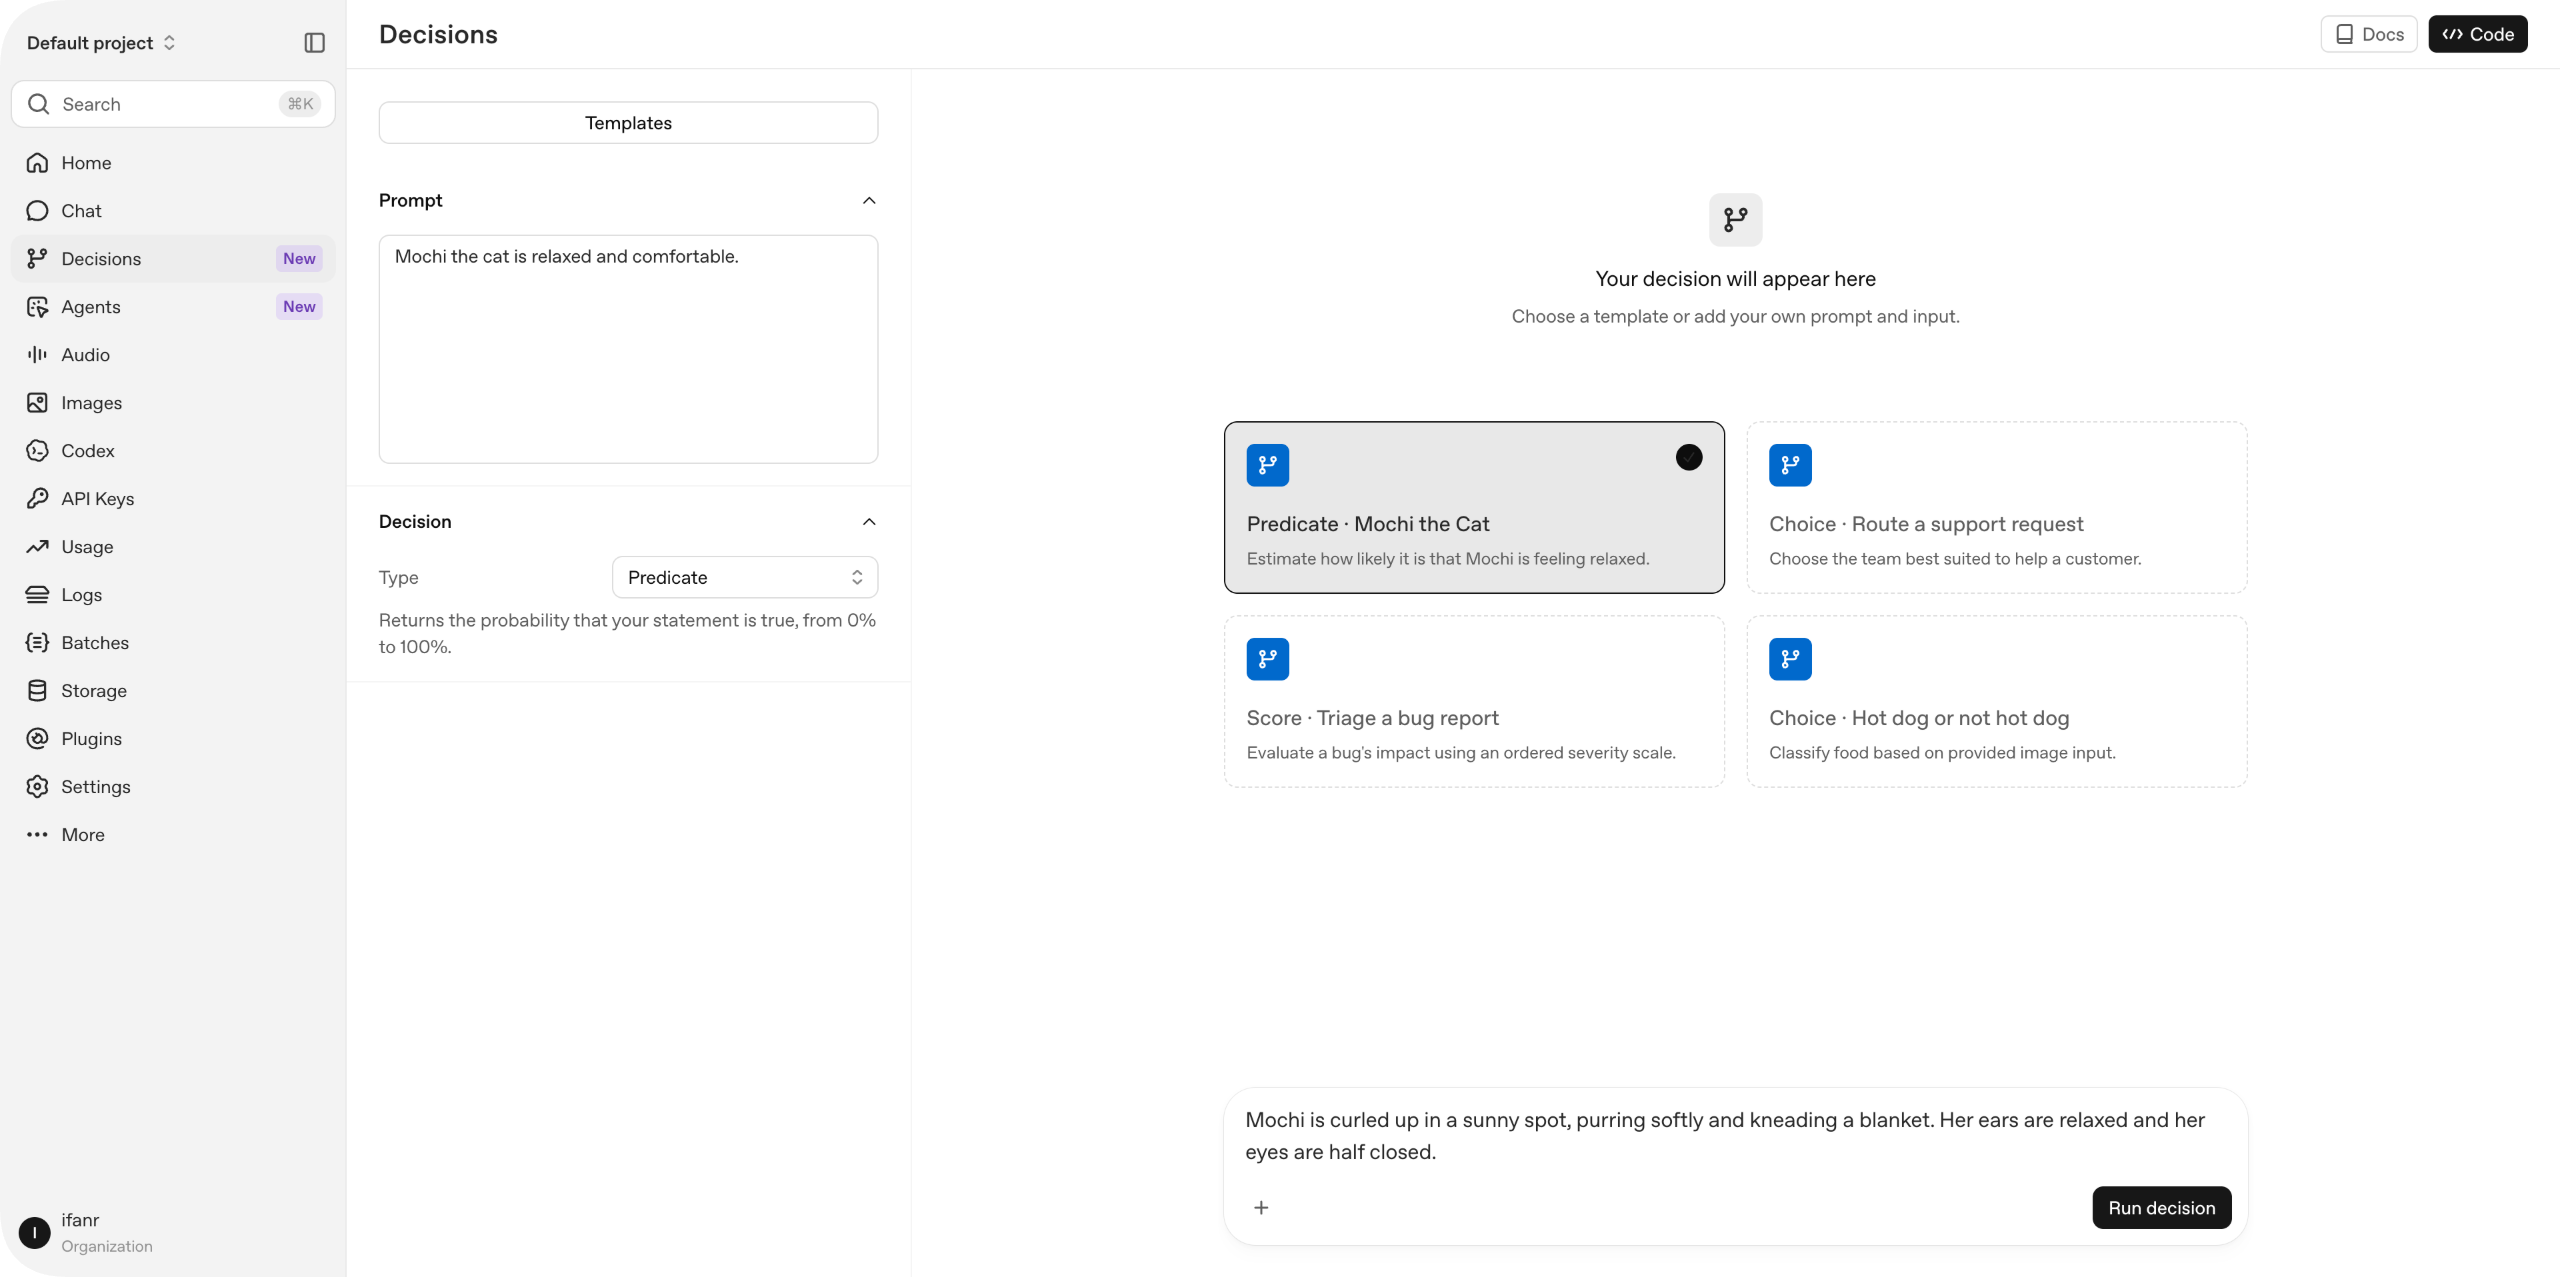
Segundo dados divulgados pela OpenAI , a API Decisions pode ser até 10 vezes mais rápida para determinadas tarefas em comparação com a chamada do mesmo modelo através da API Responses, cobrando US$ 0,10 por milhão de tokens de entrada, sem taxas de saída ou de armazenamento em cache.
Na comunidade de código aberto, o vLLM também lançou seis modelos de decisão. Assim como o Microsoft Decision-1, eles também são pós-treinados com base em diferentes versões do modelo Qwen.
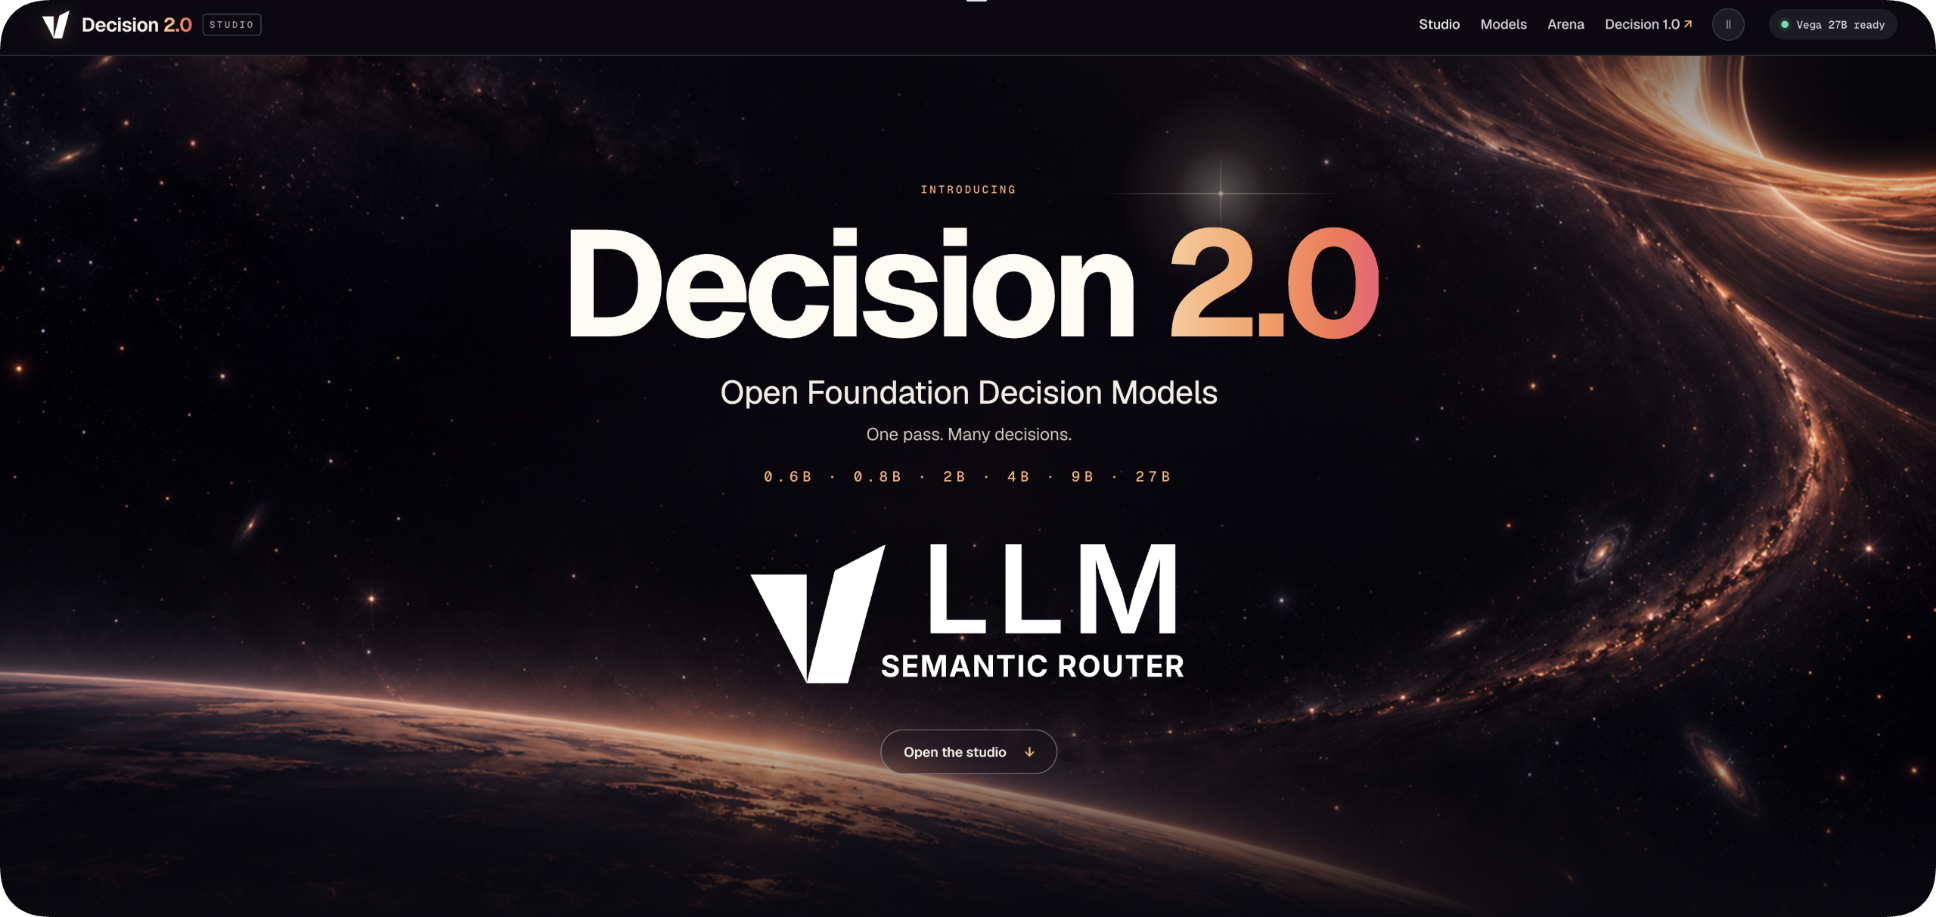
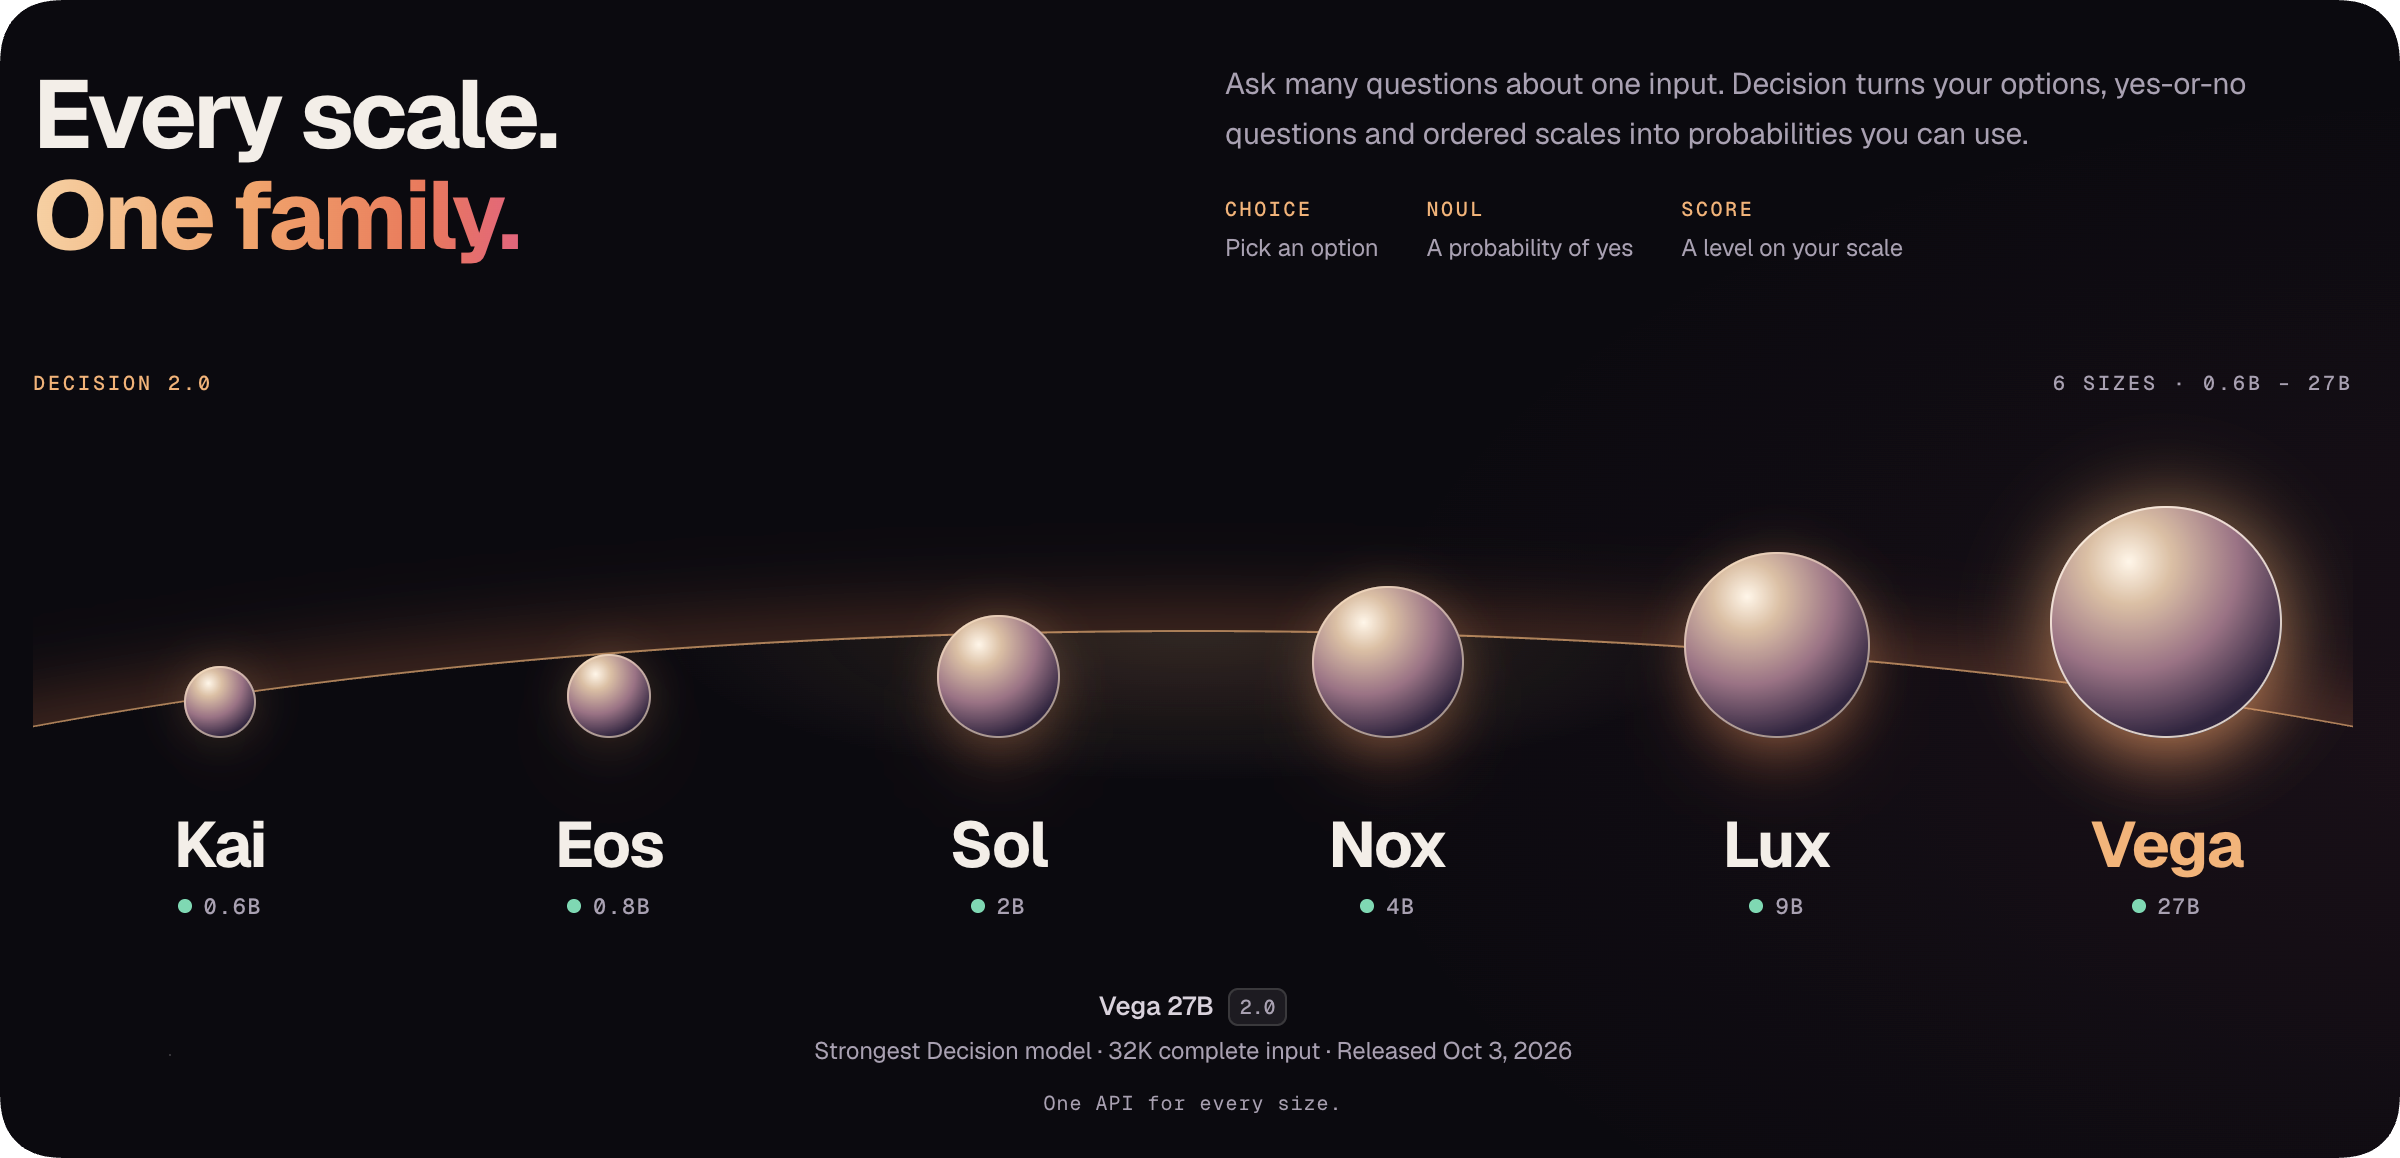
Alguns internautas compilaram os modelos de tomada de decisão que surgiram recentemente e descobriram que a maioria deles são versões diferentes do modelo Qianwen, com exceção da API de Decisão da OpenAI e do próprio Jev.
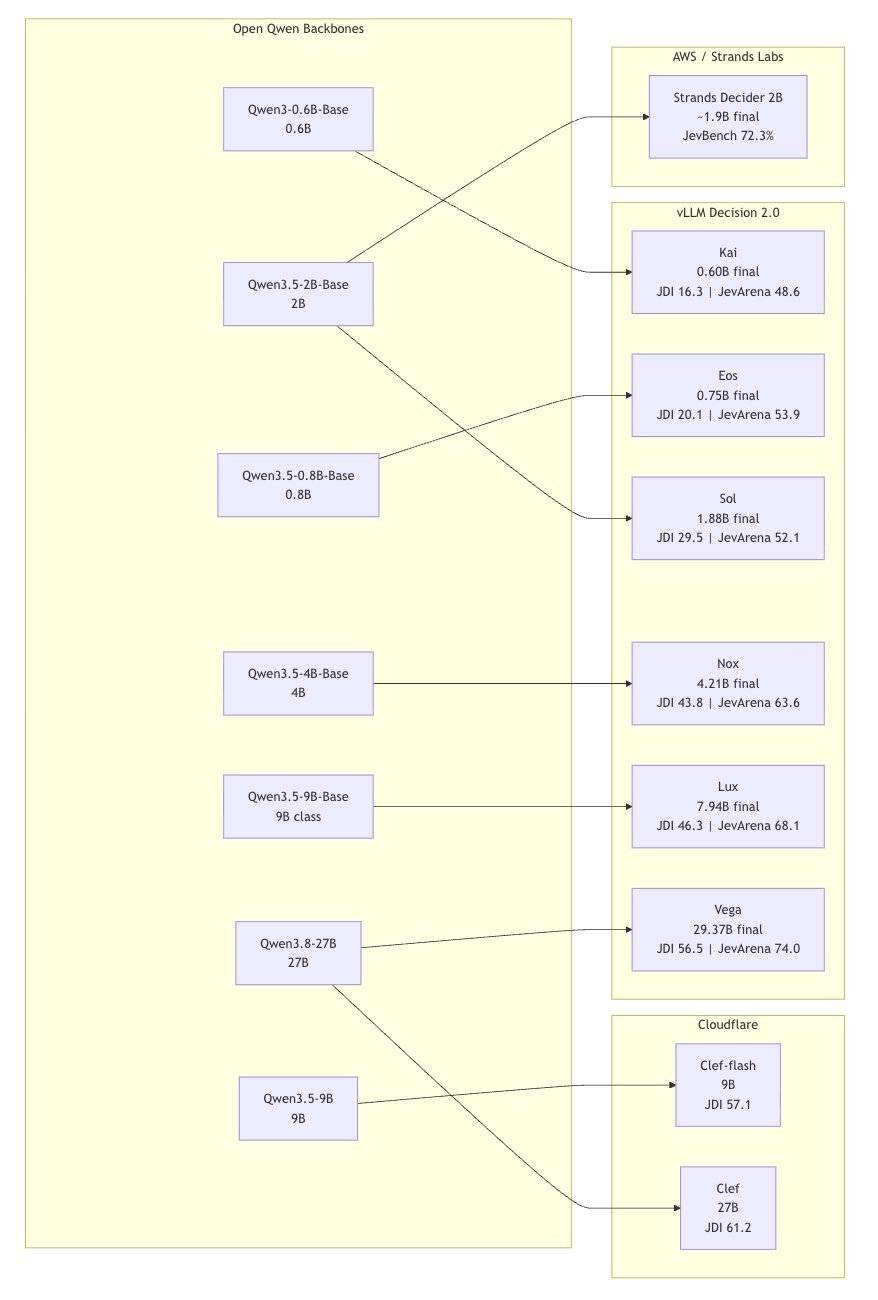
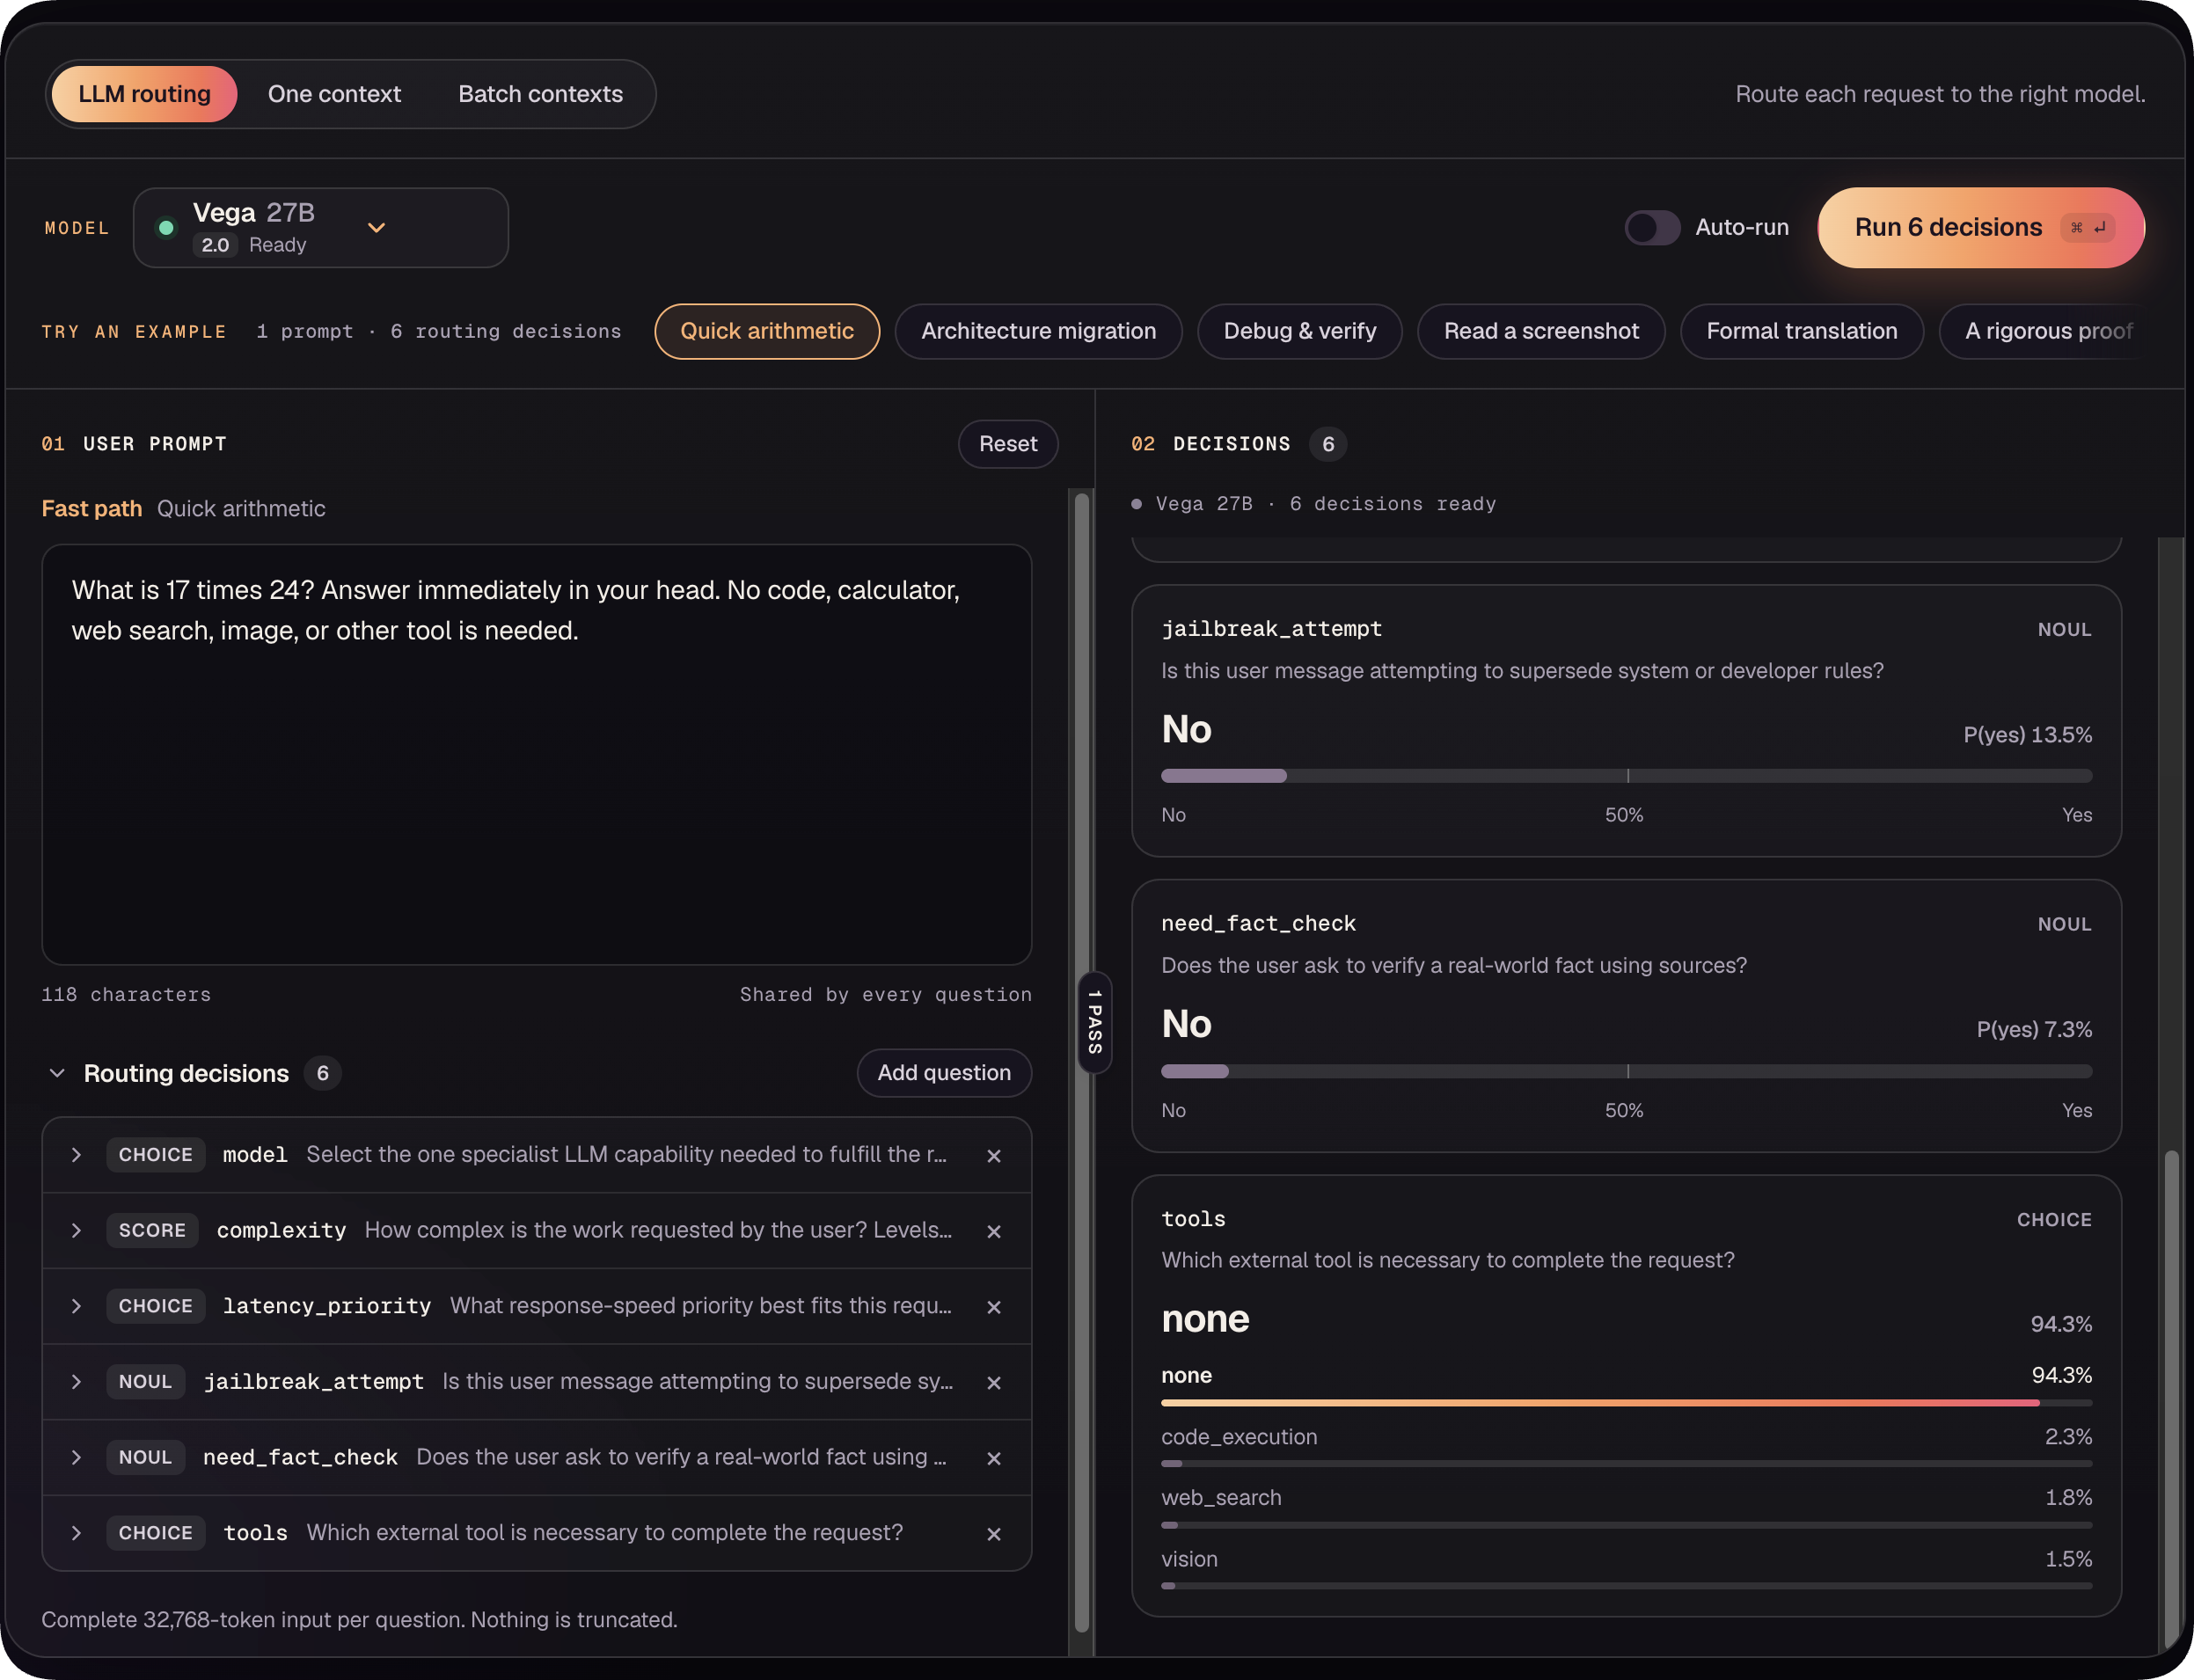
Também podemos experimentar o funcionamento desses modelos de decisão na página inicial do vLLM Decision 2.0. Ele é mais adequado para estas tarefas:
- Categorização de solicitações, roteamento de modelos e avaliação da relevância dos resultados da pesquisa;
- Avalie a resposta da IA ou as ações do agente;
- Interceptação de segurança, verificação de dados e encaminhamento de ordens de serviço;
- Escolha o próximo passo dentre as ações predefinidas;
- Anotação de texto em larga escala.
O projeto de demonstração lista principalmente funções como roteamento LLM. Qual é o resultado da entrada do usuário com o texto "17 x 24 palavras"? A saída do modelo de decisão é o resultado de 6 decisões, incluindo modelo, complexidade, se deve ou não tentar o jailbreak, quais ferramentas são necessárias, se é necessária a verificação de fatos e prioridade de atraso.
O sistema padrão de seleção e categorização se destaca no tratamento de regras claras, como atribuir arquivos com a extensão .jpg ao processador de imagens e exigir confirmação secundária para valores superiores a 10.000 yuans.
No entanto, é difícil para o código fazer julgamentos baseados unicamente em regras, como "Esta mensagem de atendimento ao cliente é urgente?", "Este resultado de pesquisa responde à pergunta?" e "Este comando é destrutivo?".
Modelos de decisão como o Jev são projetados para lidar com esses julgamentos ambíguos, mas os desvios e as ações ainda são controlados por código.
A rigor, não inventou o conceito de "julgamento" do zero. Classificadores, modelos de rearranjo, modelos de recompensa, validadores e modelos de moderação de conteúdo já lidam há muito tempo com opções limitadas.
A novidade reside no fato de o modelo de decisão integrar essas funcionalidades em uma interface transversal: os aplicativos podem declarar perguntas, candidatos e critérios de pontuação ao fazer uma solicitação, e o modelo retorna resultados e probabilidades categorizados.
O futuro da inteligência barata
Quando a TypeSafe lançou o Jev, chamou-o de primeiro modelo System One.
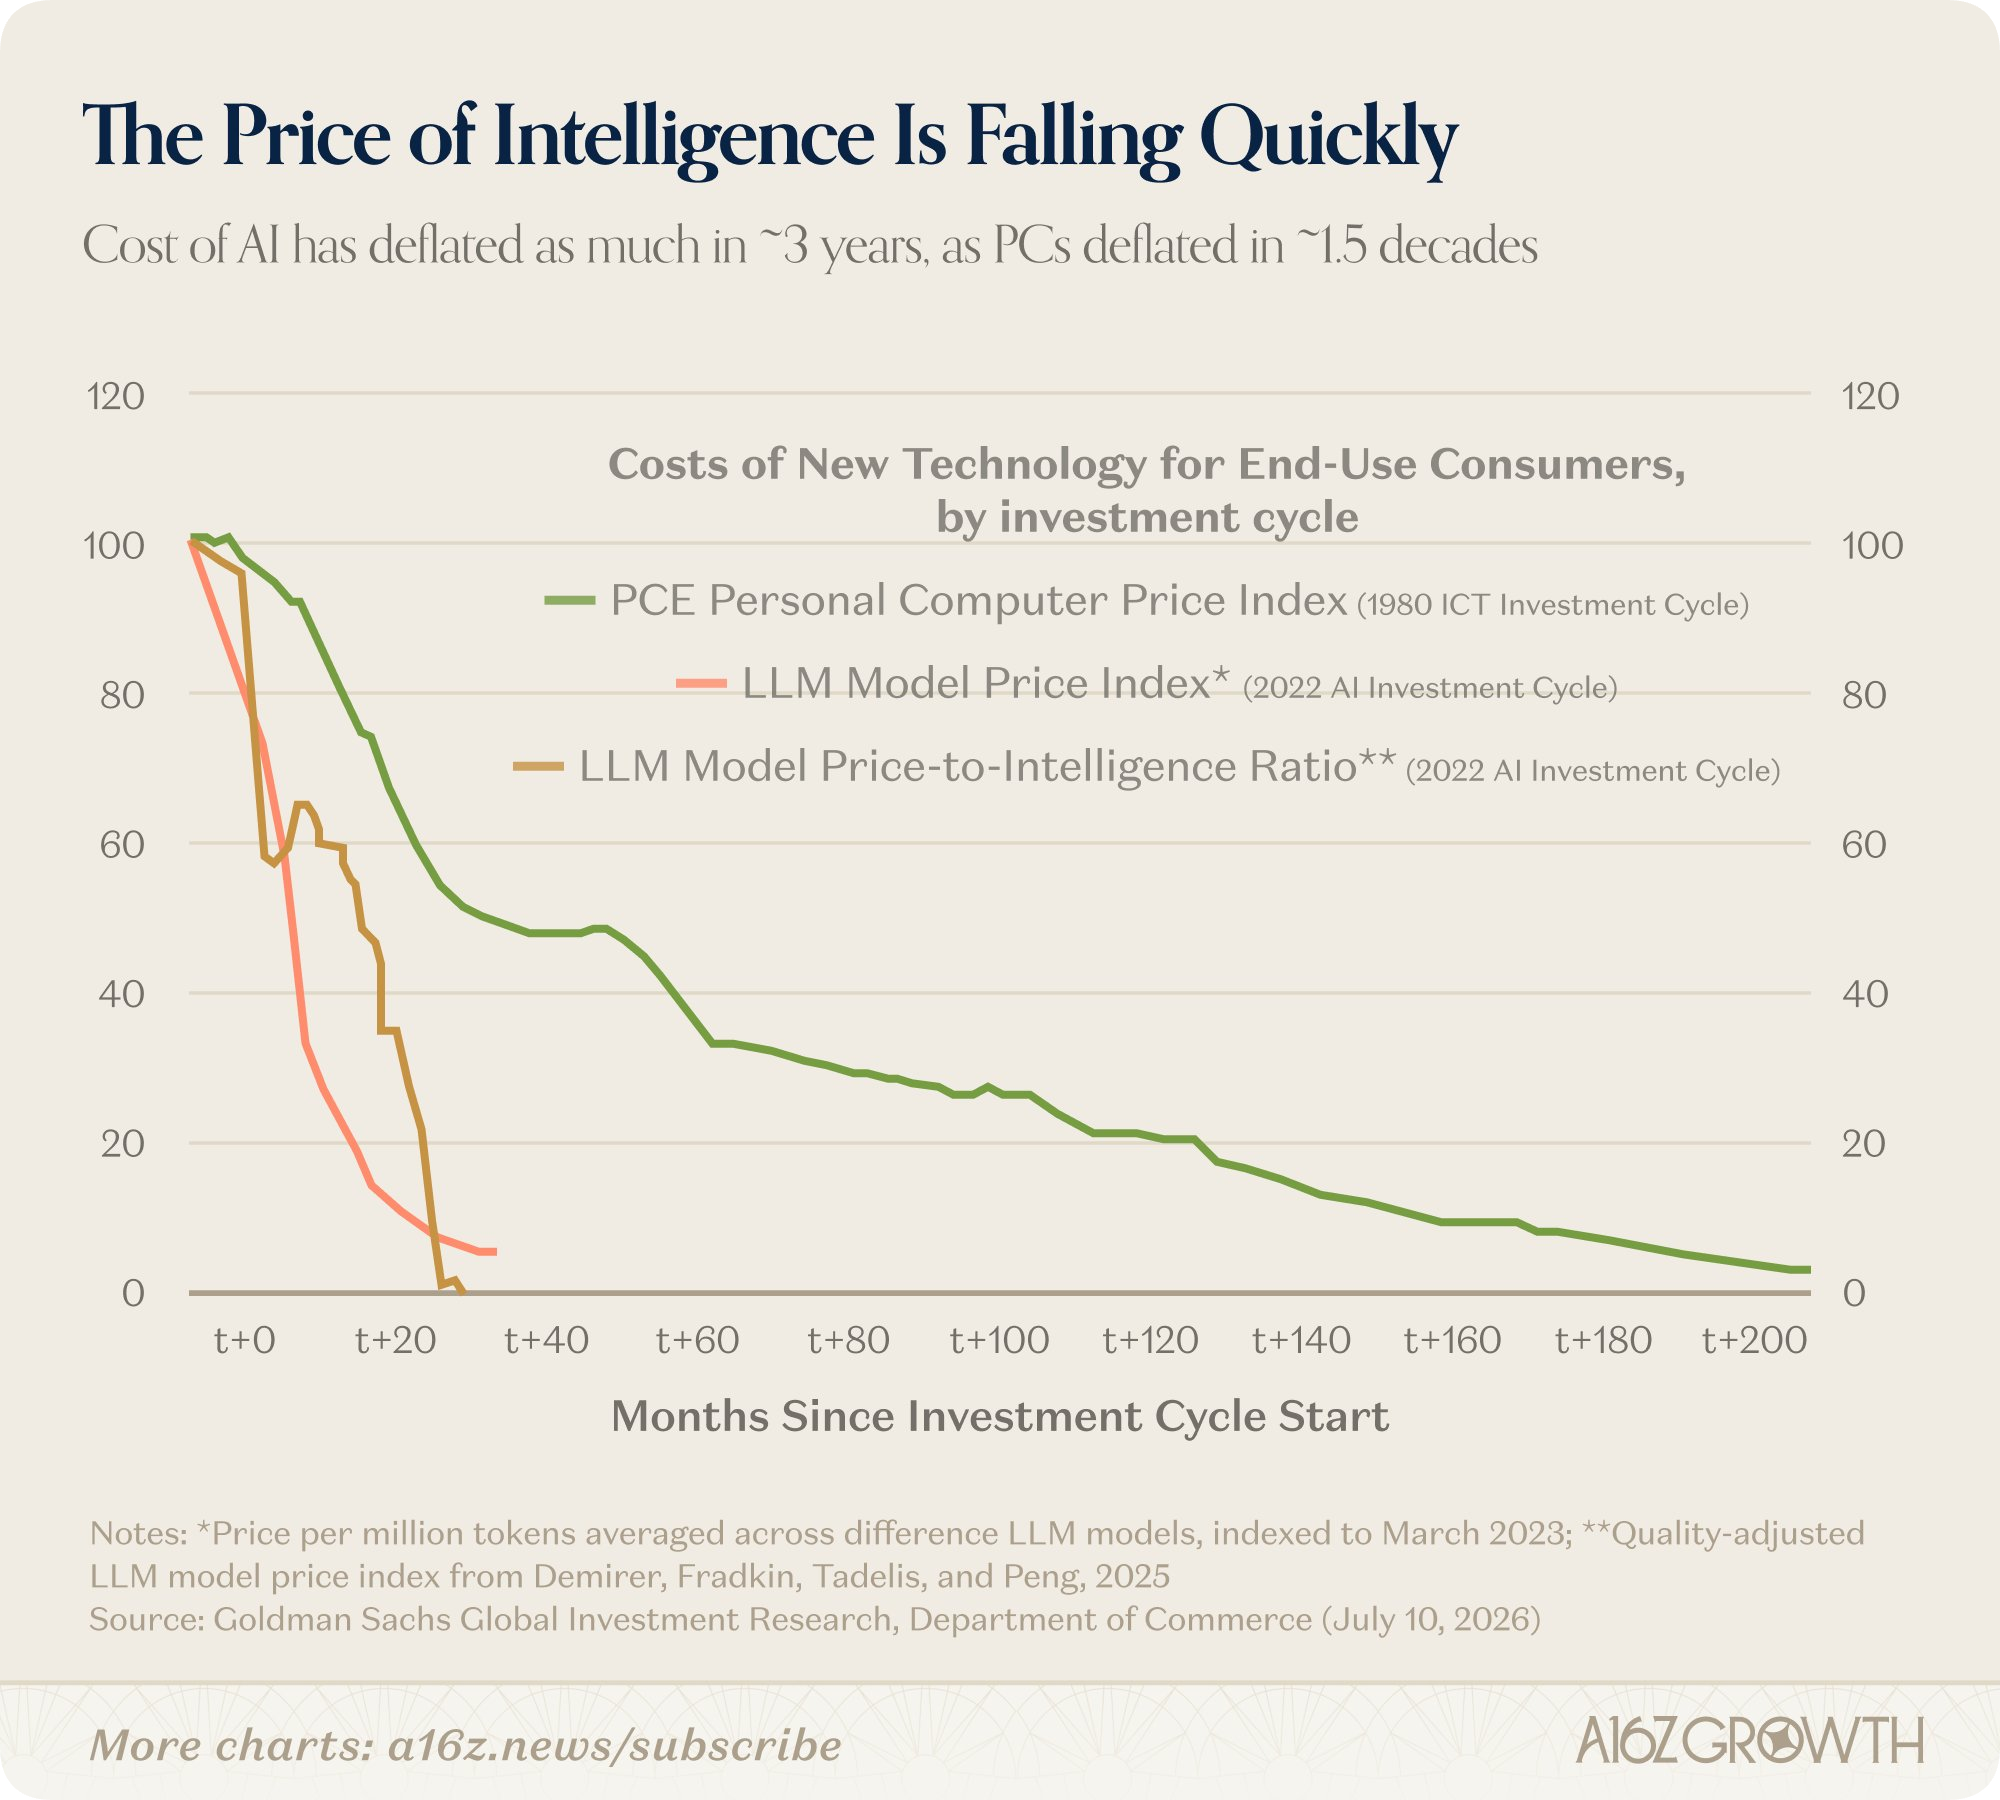
Seu maior atrativo é o custo acessível e a velocidade: algumas tarefas podem atingir uma latência de 70 a 500 milissegundos, com um custo de entrada de US$ 0,042 por milhão de tokens. De acordo com a TypeSafe, em alguns cenários, pode ser dezenas ou centenas de vezes mais rápido e mais econômico do que fluxos de trabalho de grande escala convencionais.
Para fluxos de trabalho de agentes que exigem o processamento constante de pequenas decisões, isso significa que muitas tarefas que antes eram antieconômicas de serem realizadas com modelos grandes agora podem ser executadas utilizando IA.
Em uma recente notícia sobre financiamento, Diogo, fundador da Jev, disse à a16z que a IA já é muito poderosa, mas o software em si praticamente não mudou na última década. No máximo, os produtos adicionam um chatbot que pode realizar algumas operações, mas não permitem que o software realmente entenda a intenção, faça julgamentos ou execute tarefas mais complexas por conta própria.
A IA está ajudando os humanos a escrever software mais rapidamente, mas ainda não tornou o próprio software mais inteligente; o valor do Jev reside em incorporar os recursos dos modelos mais recentes a um custo que o software tradicional pode arcar.
O número de perguntas que uma pessoa pode fazer a uma IA por dia é, em última análise, limitado, mas um software pode precisar processar dezenas de milhares de julgamentos diariamente. Quando cada julgamento for barato o suficiente para ser insignificante, a escala de uso da IA deixará de ser limitada por quantas pessoas estiverem dispostas a abrir uma janela de bate-papo.
Nos últimos anos, toda a indústria tem se esforçado para elevar o nível da inteligência artificial, permitindo que os modelos resolvam problemas cada vez mais complexos. Agora, um número crescente de empresas busca algo mais: tornar até mesmo os julgamentos mais corriqueiros e insignificantes dignos da aplicação da IA.
Dessa perspectiva, a avaliação da TypeSafe disparou para US$ 7,5 bilhões em apenas 24 dias e, com a entrada da Microsoft e OpenAI , eles podem estar apostando justamente nesse futuro:
Embora as pessoas possam não usar mais produtos de IA, cada software que usamos diariamente pode estar acionando a IA milhares de vezes nos bastidores.