Por que ChatGPT sempre inclui anúncios pornográficos e de jogos de azar em seus títulos?
"Temos que imaginar Sísifo como… o diretor de entretenimento adulto?!"
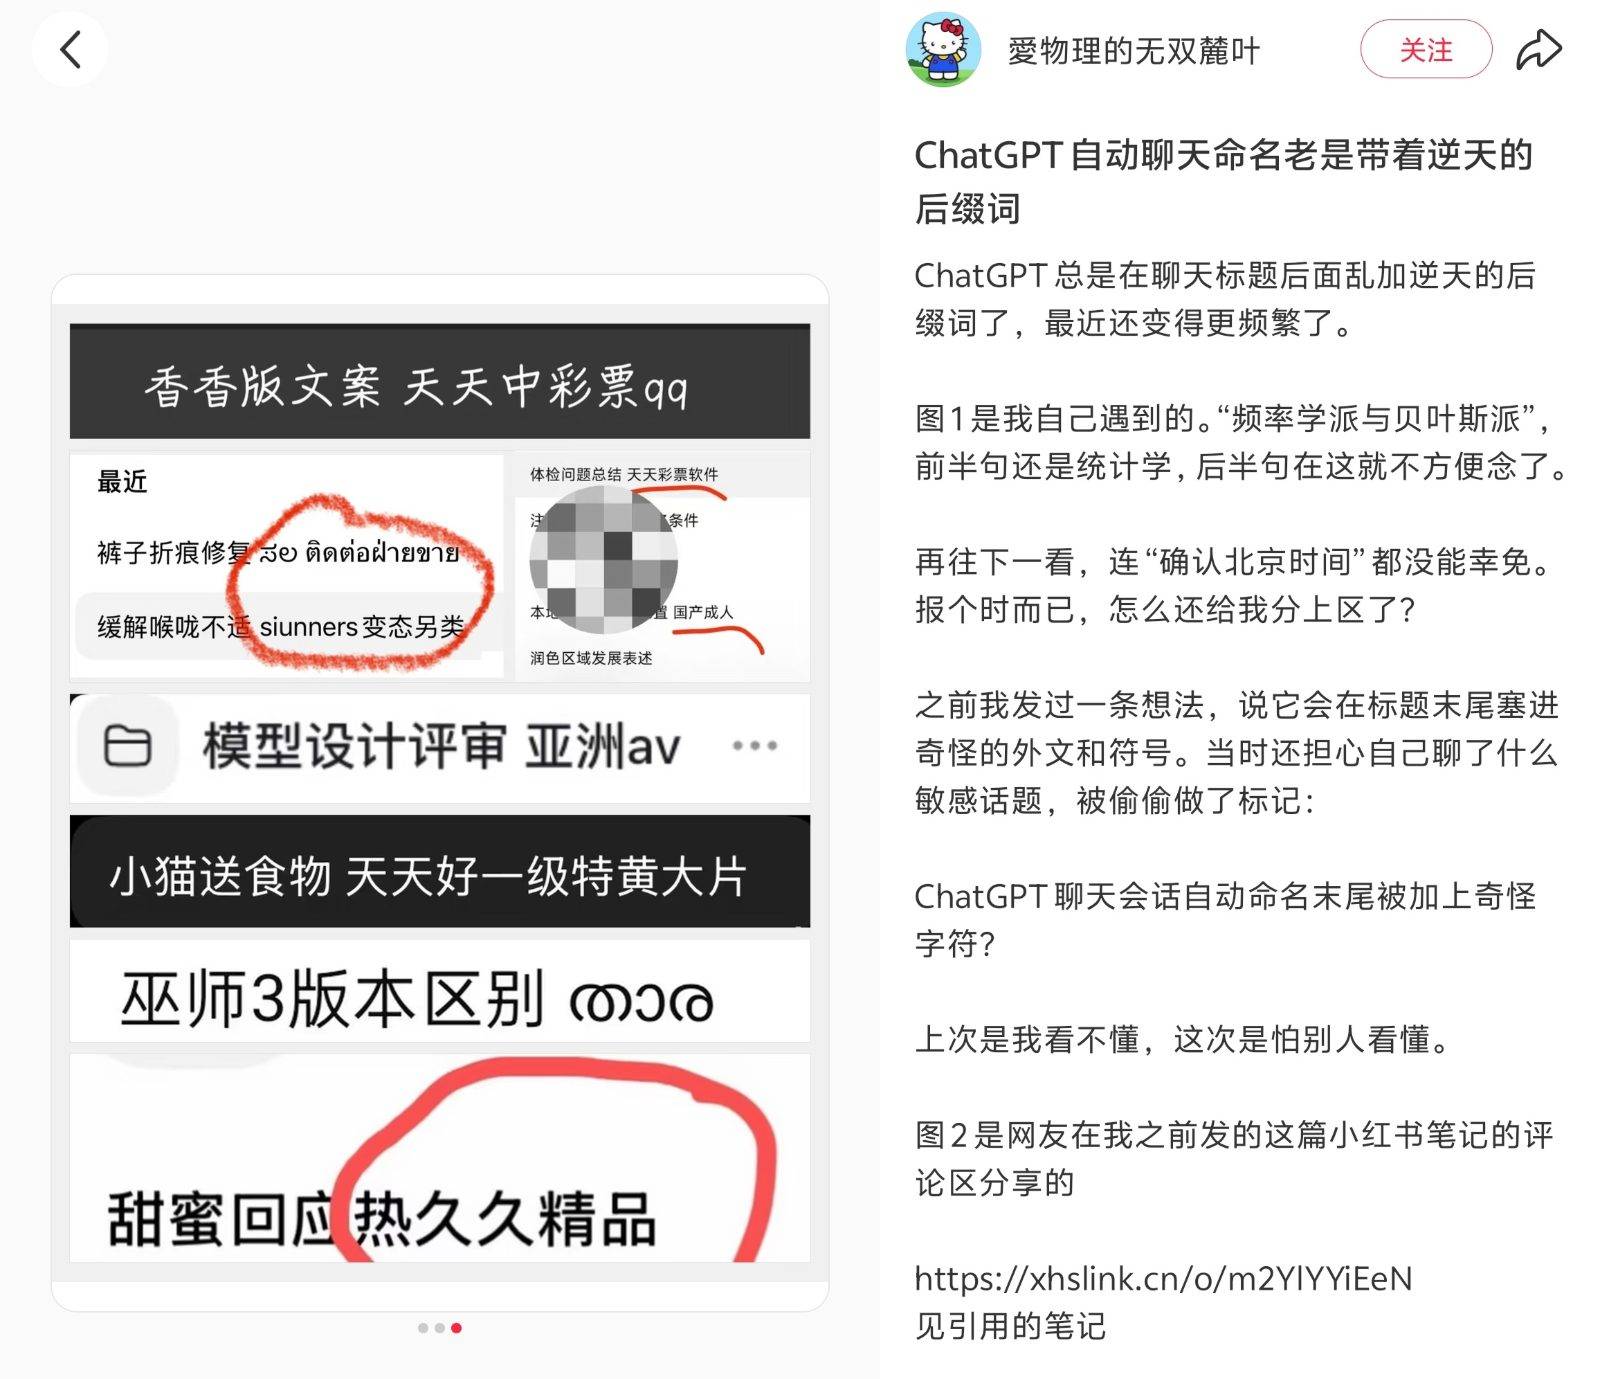
Se você é um usuário frequente do ChatGPT , provavelmente já se deparou com um fenômeno misterioso desde agosto deste ano: ocasionalmente, ChatGPT adiciona palavras estrangeiras sem sentido ou fragmentos de anúncios de jogos de azar ou pornográficos ao final dos títulos de conversas gerados automaticamente.
Dar títulos em inglês a conversas em chinês não é novidade, mas inserir pequenos anúncios no título é definitivamente uma abordagem inovadora. Durante o feriado do Dia Nacional, passamos uma noite inteira investigando os possíveis princípios técnicos subjacentes e chegamos a algumas conclusões preliminares:
Não se trata de um teste ChatGPT para funcionalidades de publicidade, nem há qualquer risco de violação de privacidade, portanto não há necessidade de se preocupar com a possibilidade de "Crazy Water World" aparecer no título algum dia. A má notícia é que suas origens remontam a 2024, e OpenAI , que atualmente enfrenta inúmeros desafios, parece relutante em resolver essa questão técnica que afeta a experiência do usuário.
Observação: Algumas palavras-chave publicitárias serão bloqueadas no texto a seguir.
Uma "doença infecciosa" em propagação
A "doença contagiosa" de cadeias anormais desenfreadas apareceu pela primeira vez no Codex CLI no início deste ano.
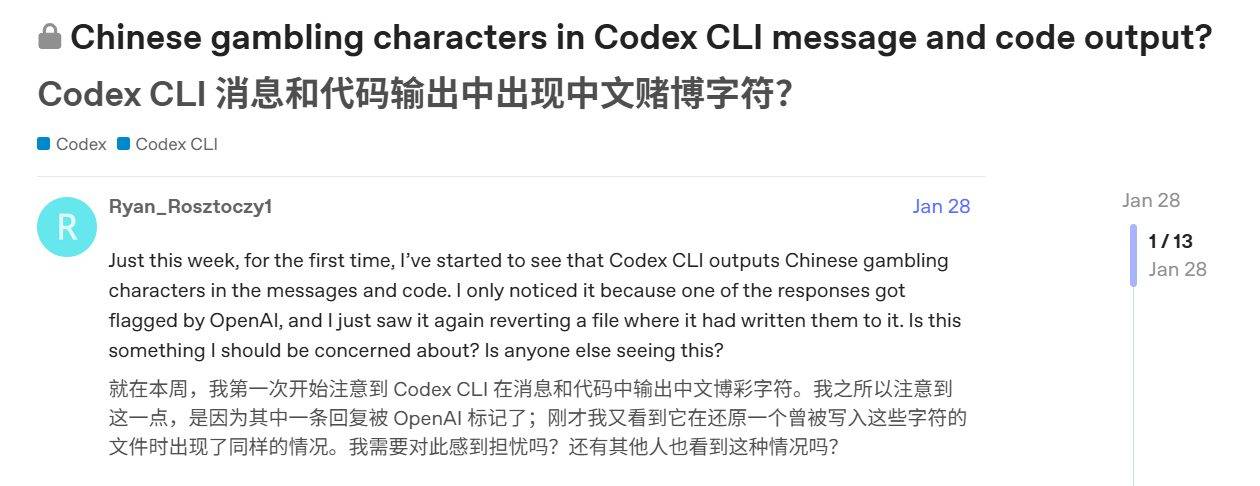
No final de janeiro, alguns desenvolvedores perceberam que, ao usar o modelo GPT-5.3 com contextos longos, as mensagens ou o código fornecidos pelo Codex começaram a incluir anúncios de jogos de azar chineses, idênticos em formato aos caracteres que aparecem no final das manchetes atualmente.
Em fevereiro, a "doença infecciosa" começou a se espalhar pela API. Quando alguém usou o GPT5.2-chat-latest como ferramenta, o modelo não executou a chamada, mas, em vez disso, exibiu uma sequência de anúncios em chinês e alguns anúncios de sites de jogos de azar em tailandês. O sistema sugeriu que as palavras eram apropriadas e que nenhuma busca online estava habilitada.
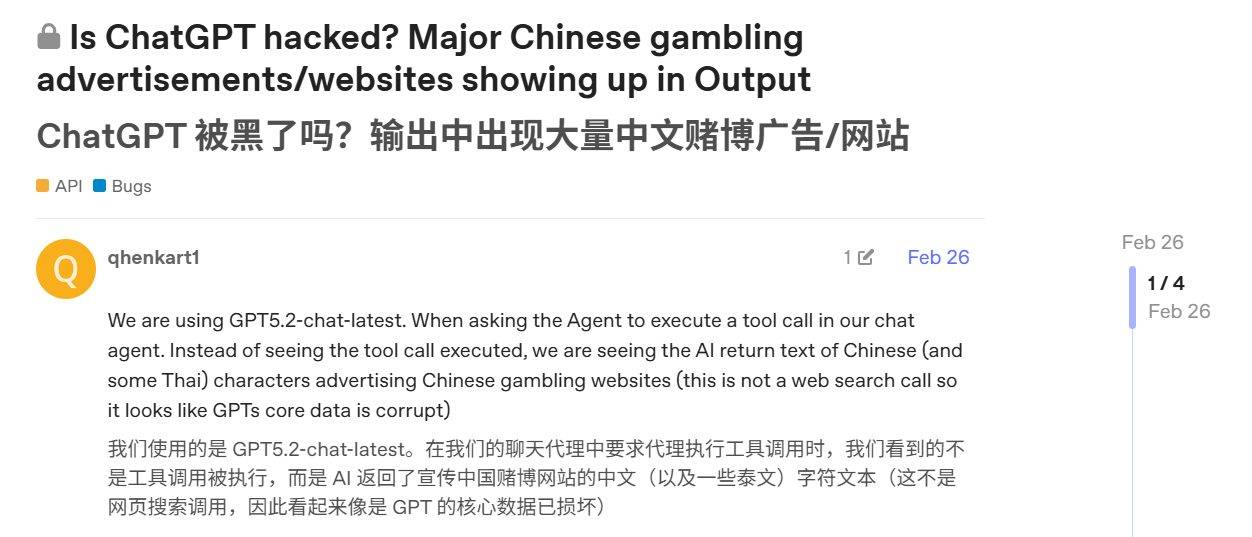
Em abril, esse fenômeno já havia se tornado comum entre os desenvolvedores. Alguém publicou um pedido de ajuda na comunidade de desenvolvedores LINUX DO, dizendo que suspeitava-se que a estação de transferência GPT estivesse comprometida, exibindo ocasionalmente anúncios de loteria, mas as respostas eram todas de parabéns por usar o GPT genuíno — os pequenos anúncios eram evidência de "negociação de cartas online" com GPT puro.
Embora pedidos de ajuda semelhantes tenham inundado OpenAI , com vítimas em todo o mundo, durante seis meses a única coisa que a equipe oficial fez foi incentivar a "fusão de discussões" e fechar constantemente novas postagens. Somente em 25 de julho o suporte oficial OpenAI respondeu pela primeira vez, afirmando que estavam "cientes do problema" e que "espera-se que esse problema seja resolvido em uma futura atualização do modelo".
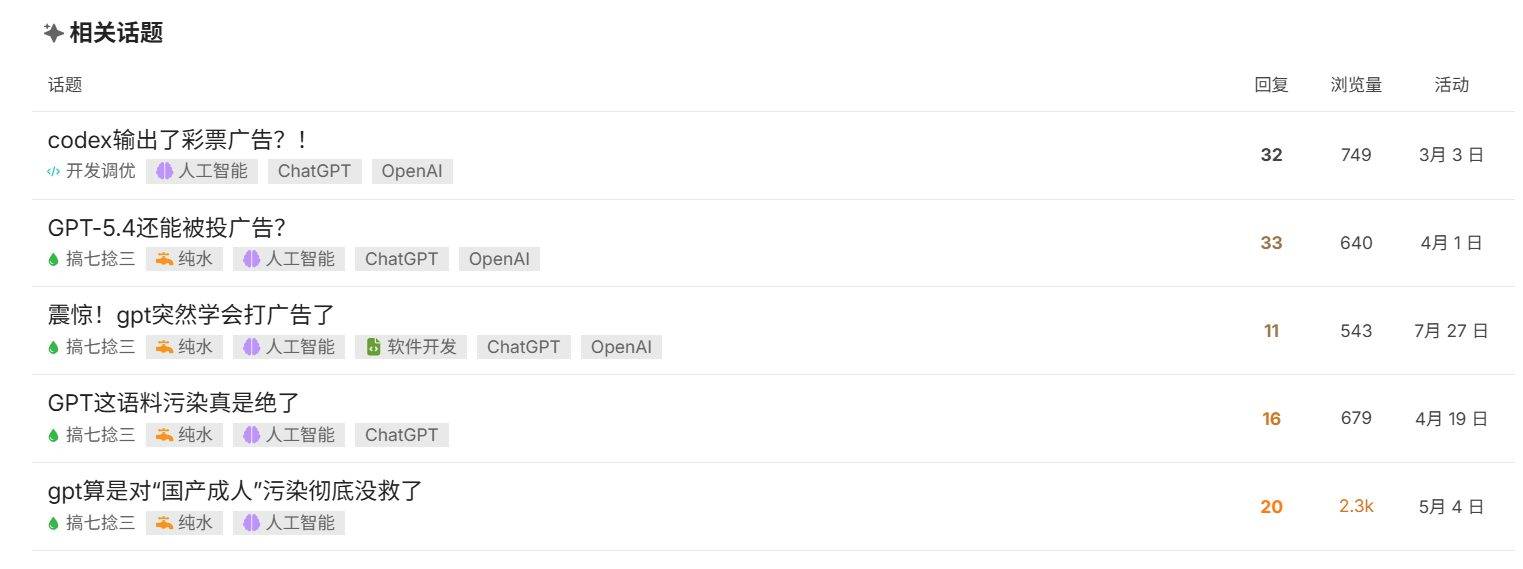
O problema foi resolvido? A resposta é claramente não .
Se as anomalias de saída do Codex e da API ainda estivessem confinadas a um pequeno círculo, em meados de agosto, quando anúncios de jogos de azar começaram a aparecer nos cabeçalhos de bate-papo de usuários comuns, provavelmente ninguém poderia mais fingir que o problema não existia — exceto a própria OpenAI .
É justo dizer que OpenAI esteve incrivelmente ocupada nos últimos meses. A série GPT-5.6, o modelo Astra e a série GPT-6 foram lançados, juntamente com o evento de lançamento do DevDay e o recente anúncio do Tibo com uma "atualização consecutiva de 28 dias"… Mas, sob a cobertura desse cronograma de lançamentos de produtos, OpenAI também conseguiu se esquivar da responsabilidade, deixando de responder a quaisquer perguntas levantadas na comunidade oficial.
Claro, acredito que OpenAI vem tentando fazer otimizações internas. Pelo menos, com as atualizações do modelo, os pequenos anúncios no texto principal e nas sequências de pensamento praticamente desapareceram; e, em setembro, a frequência de anúncios no título também diminuiu significativamente no geral.
No entanto, o fato de uma empresa que reúne os melhores pesquisadores do mundo ainda não ter conseguido eliminar completamente os pequenos anúncios após mais de meio ano parece sugerir que a raiz do problema está em um lugar mais profundo.
O Processo de Nascimento de um Título
OpenAI não explicou publicamente o mecanismo pelo qual os títulos das sessões são gerados. No entanto, registros de captura de pacotes publicados no GitHub por engenheiros há alguns anos deixaram algumas pistas:
Após iniciar a primeira rodada de conversa, a página da web enviará uma solicitação separada para `/backend-api/conversation/gen_title/<ID da conversa>`, que inclui o ID da sessão e o nome do modelo usado para gerar o título. Posteriormente, o servidor gera o título usando o modelo especificado com base no conteúdo da sessão e armazena o título como metadados da conversa.
Em outras palavras, em termos de design, o título é um processo de invocação de modelo independente do diálogo principal.
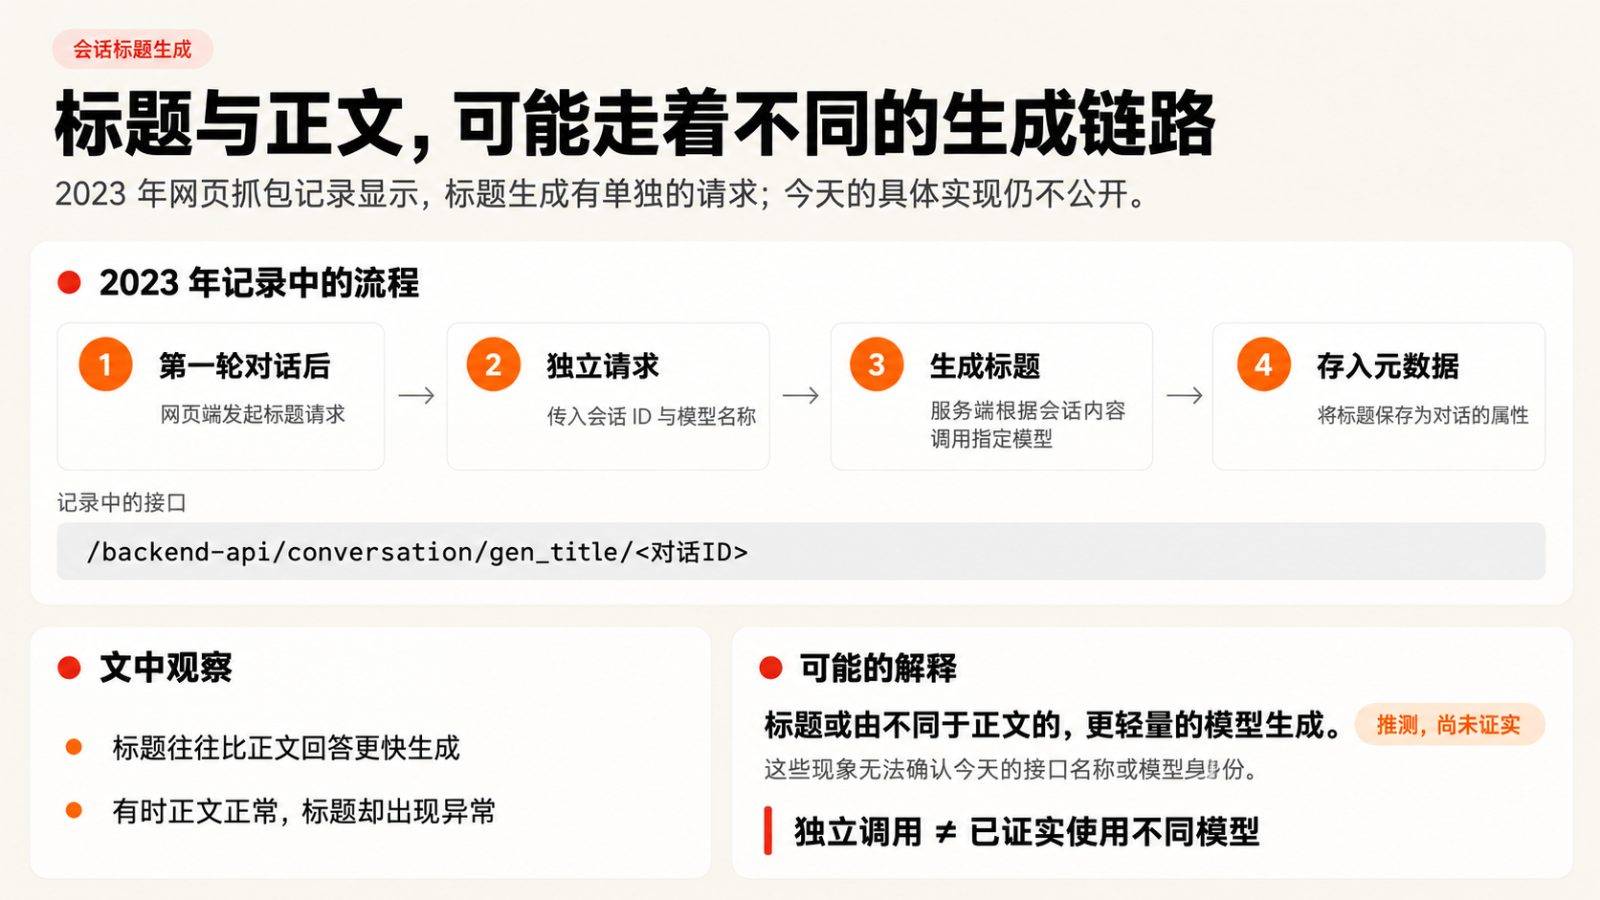
No entanto, este registro de captura de pacotes da página da web é um "artefato" de 2023, portanto não podemos saber o nome da interface atual nem o modelo específico de geração de títulos utilizado. Mas, considerando que a geração de títulos costuma ser mais rápida do que a resposta do corpo do texto, e que existe o fenômeno de "corpo do texto limpo, título poluído", podemos inferir que a geração de títulos pode estar usando um modelo mais leve, diferente do usado para o corpo do texto da conversa.
Quais são as características desse modelo de título? Felizmente, um título incomum que encontrei durante meu uso diário forneceu algumas pistas — pedi ChatGPT para gerar uma série de quadrinhos, mas o modelo de título acabou gerando uma sequência de texto completa:
Criando uma história em quadrinhos? Você precisa de 1 a 4 palavras em chinês. "Criando uma história em quadrinhos com desenho de linhas" (4 palavras).
Este título ilustra vários pontos: Primeiro, a seção de "autoquestionamento e auto-resposta", com o sujeito omitido, é típica do processo de pensamento do modelo de inferência OpenAI , indicando que o modelo de geração de títulos é um modelo de inferência do tipo "pense antes de responder"; segundo, a expressão "deve conter de 1 a 4 palavras em chinês" permite, até certo ponto, deduzir as palavras-chave inseridas no modelo de geração de títulos; por fim, o conteúdo que deveria permanecer no processo de pensamento interno também é apresentado, indicando que este modelo não consegue distinguir efetivamente a fronteira entre "pensar" e "responder".
Existem outras informações que corroboram este último ponto.
Em outra sessão minha, o título do erro de saída final do sistema foi "Lendo anotações de artigos #+#+#+#+"; anteriormente, um usuário japonês postou sua resposta de erro do Codex no fórum de suporte oficial: "このテスト方针で問題ないですか? +#+#+#+#+#+#+assistente……".
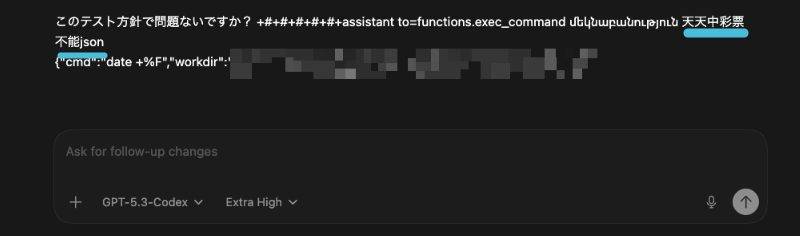
Nesses dois casos semelhantes, "Ler anotações do artigo" e "Este caso de teste está correto?" já são títulos/frases completos. Logicamente, o modelo deveria gerar um "caractere de controle" especial para finalizar a resposta. No entanto, por razões desconhecidas, o modelo acaba gerando não um caractere de controle, mas sim o símbolo "#+#+#+#+", que pode ser confundido com um caractere de controle.
Em outras palavras, esse modelo muitas vezes não sabe como finalizar uma tarefa corretamente.
Por outro lado, entre os casos de títulos anômalos coletados, também notei que existe uma certa conexão semântica oculta entre a "primeira metade normal" e a "segunda metade anômala" de alguns títulos.
Por exemplo, no título "Explicação do Diretor de Entretenimento da Felicidade de Sísifo", "felicidade" e o seguinte "entretenimento" estão semanticamente relacionados; a última parte de "preencher o nível de escolaridade" é o radical de uma palavra em armênio que significa "nível, posição", portanto, nível de escolaridade e posição estão obviamente relacionados; e no já mencionado "criar uma exposição de quadrinhos…", "ಚಿತ್ರ" é a palavra em canarês para "imagem", que se conecta com o precedente "quadrinhos".
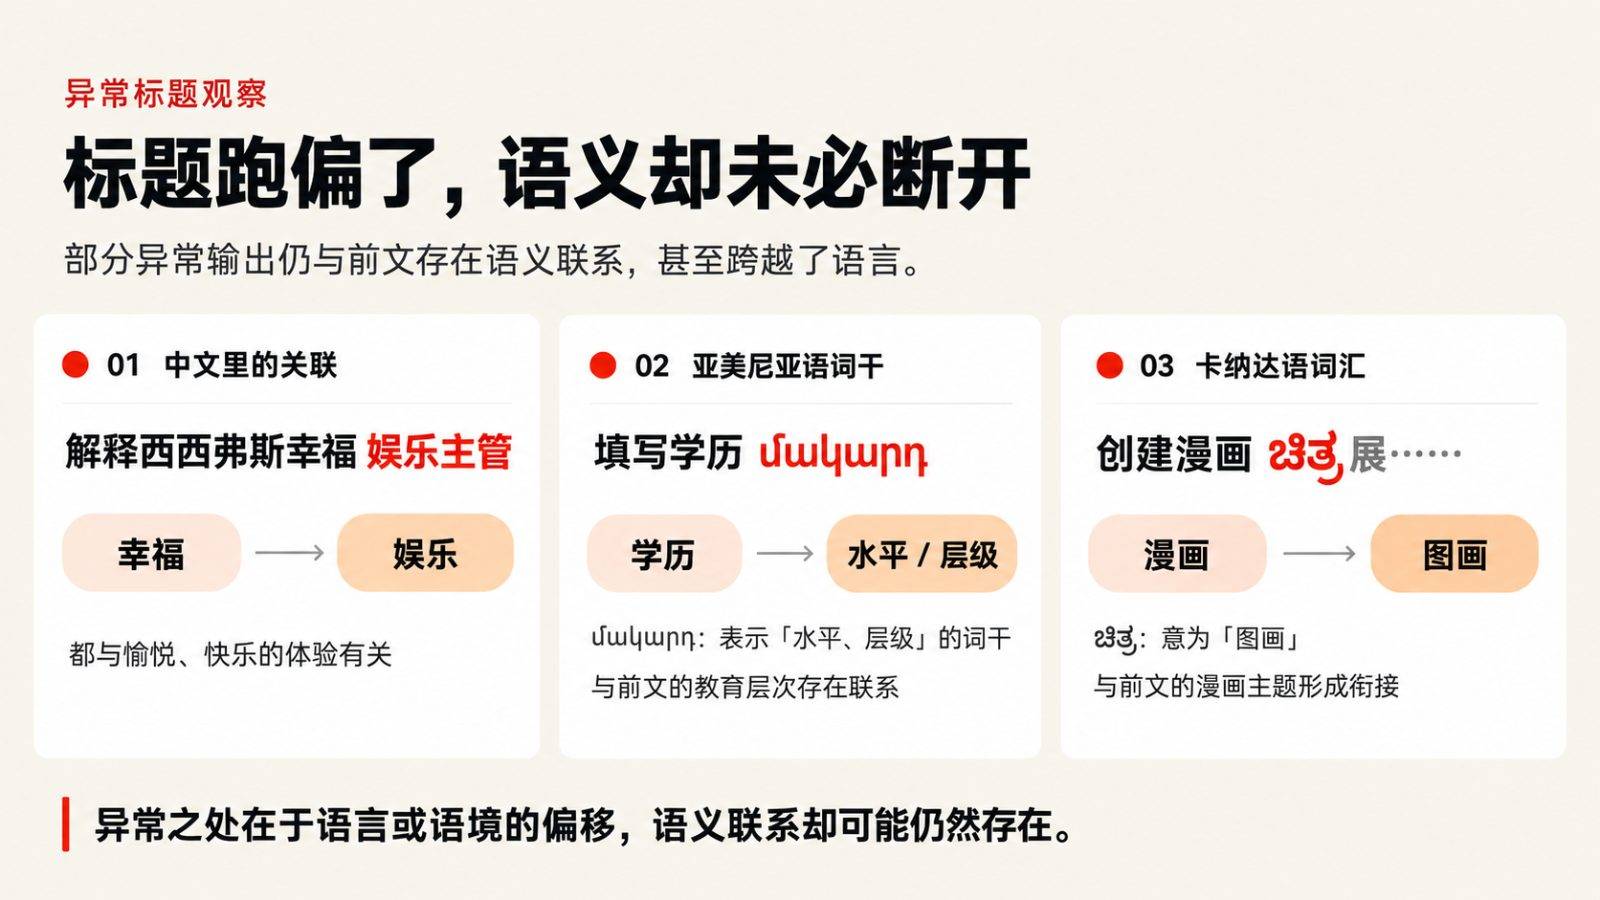
Com base nas informações acima, podemos inferir com segurança que o título é gerado por um modelo de raciocínio e que esse modelo apresenta um problema na etapa em que a geração deveria terminar após a redação do título, o que frequentemente leva a falhas na etapa final.
Se o modelo não conseguir encerrar o processo de geração, ele continuará a produzir a "próxima palavra" com base na probabilidade. Essa palavra pode ser uma palavra em língua estrangeira com semelhança semântica ao título original, uma palavra da lista de vocabulário que pareça ser pornografia ou propaganda de jogos de azar, um símbolo que seja confundido com um caractere de controle, ou até mesmo o próprio processo de pensamento do modelo, resultando nos diversos títulos anômalos que vemos.
Quando um "modelo fraco" encontra uma "lista de palavrões"
As conjecturas acima podem explicar por que a geração do modelo falha, mas não explicam por que, na maioria das vezes, o resultado do erro é a exibição de "anúncios de jogos de azar pornográficos".
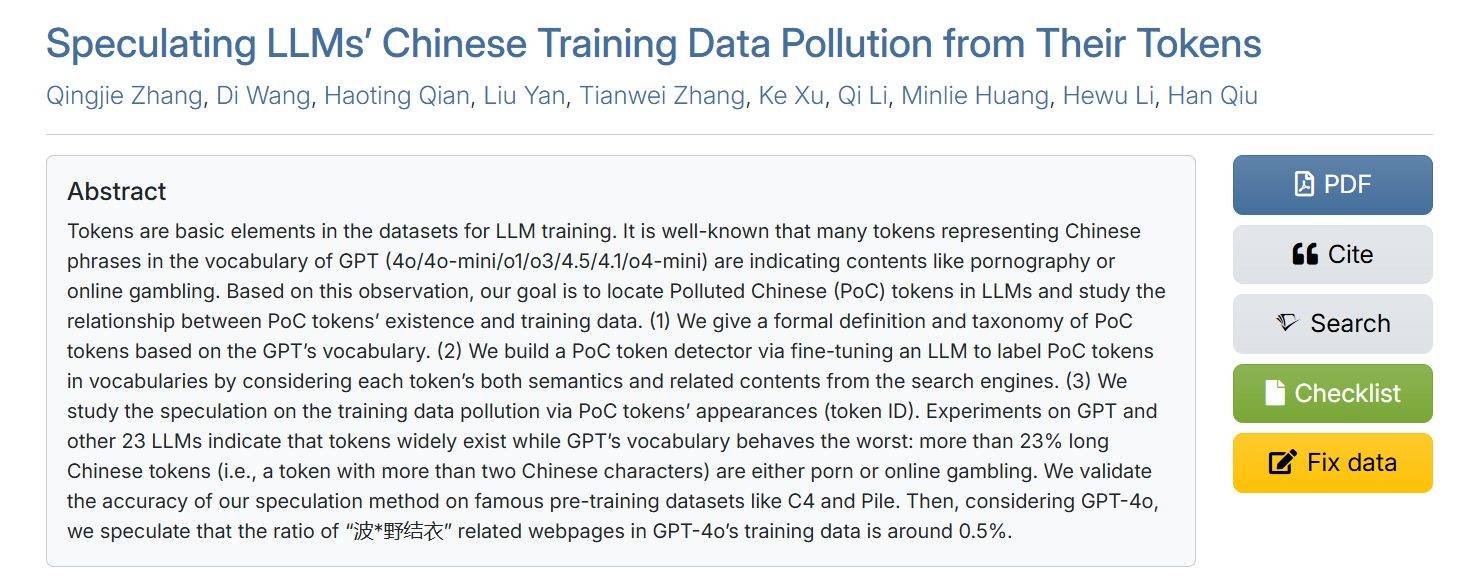
Felizmente, um artigo intitulado "Especulando sobre a poluição dos dados de treinamento em chinês dos LLMs a partir de seus tokens", selecionado para a EMNLP, uma das principais conferências na área de processamento de linguagem natural, no ano passado, explicou sistematicamente os motivos da proliferação de várias pequenas palavras-chave publicitárias nos modelos da série GPT.
Antes de prosseguir com o "diagnóstico", é necessário compreender os princípios de funcionamento dos modelos de grande porte mais comuns.
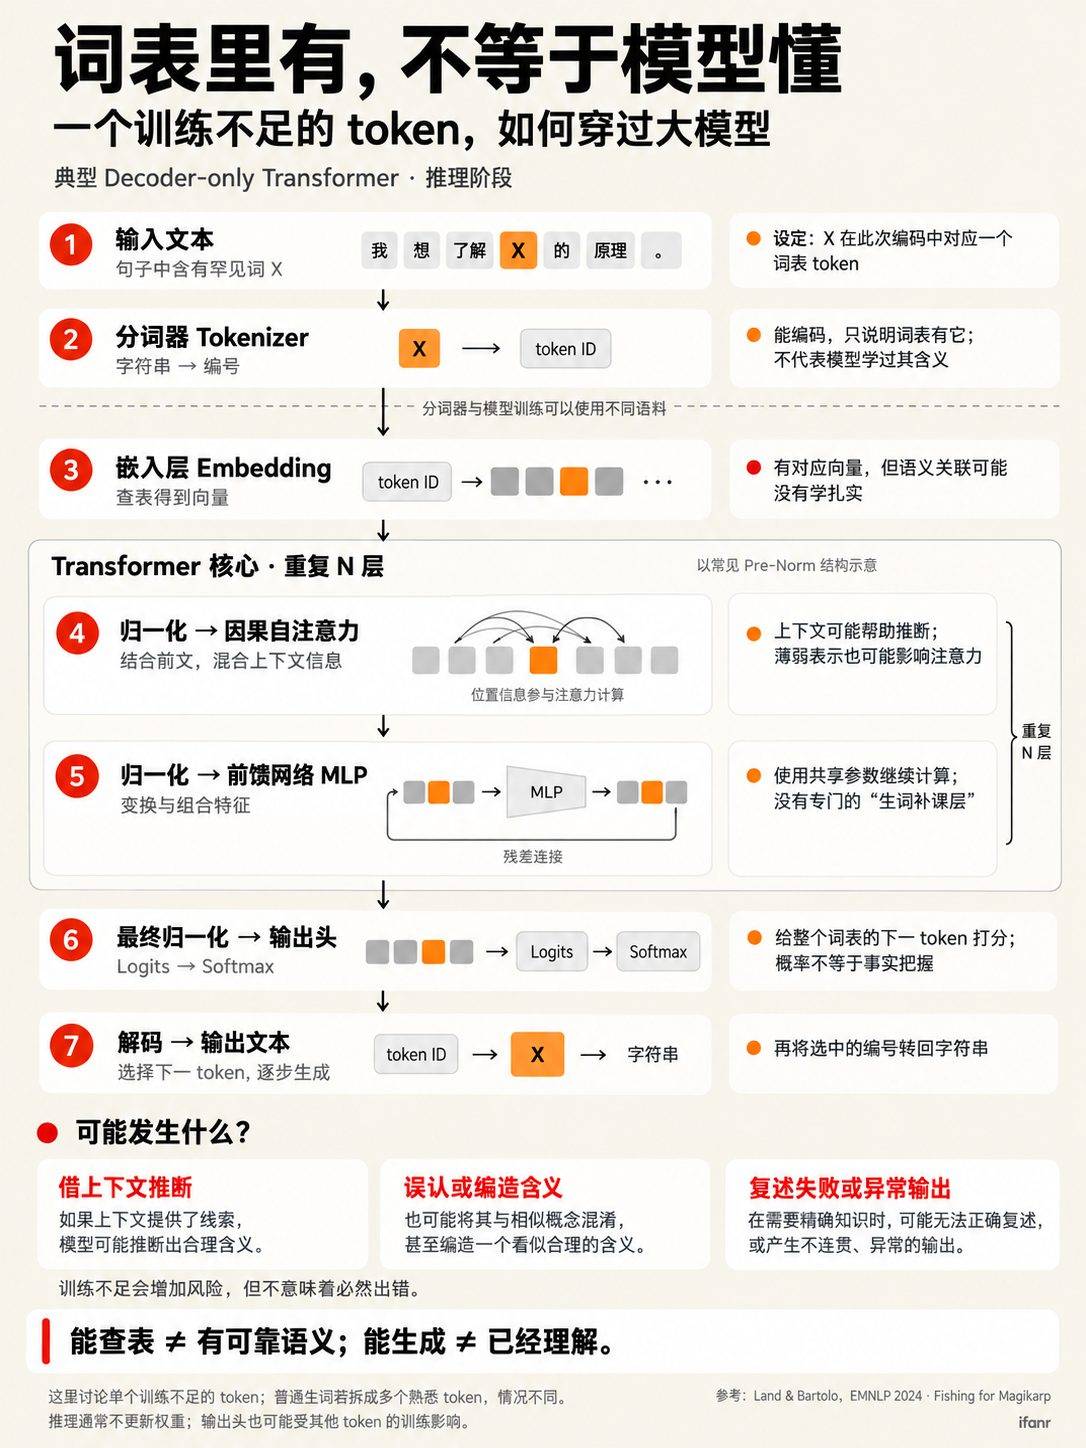
As palavras-chave que inserimos passam primeiro por um "tokenizador", que decompõe a frase em tokens individuais. Cada tokenizador tem seu próprio vocabulário, que funciona como um "dicionário de tokens". Ele atribui um ID numérico a cada token possível. A entrada final para o modelo é uma matriz desses IDs numéricos.
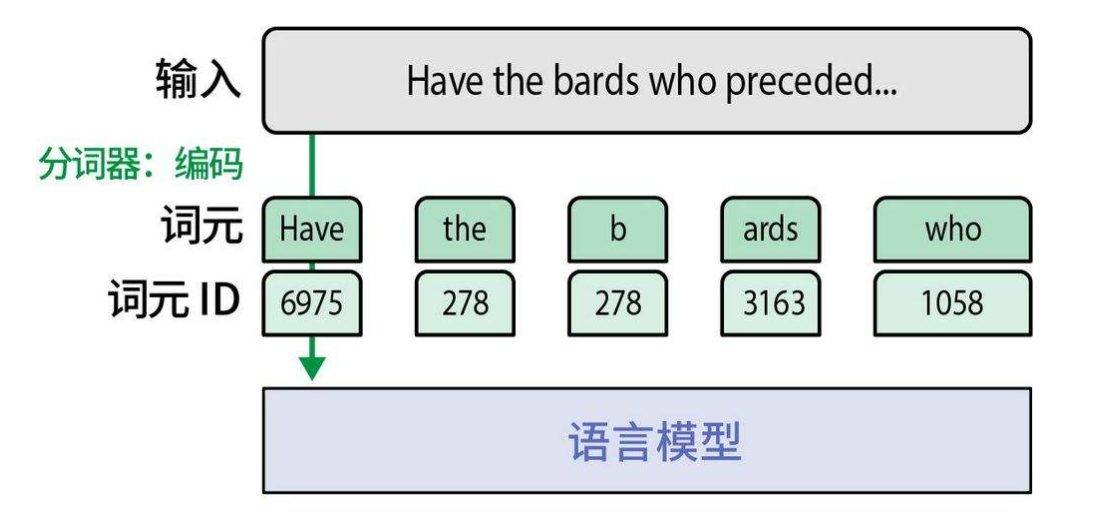
Em outras palavras, o modelo de linguagem principal inicialmente vê apenas matrizes que já foram "digeridas" pelo tokenizador, sem conhecer o texto original. Posteriormente, com base no conhecimento adquirido durante o treinamento, o modelo de linguagem compreende as relações entre essas matrizes no "espaço semântico", organiza novas respostas e as "retraduz" em texto antes de entregá-las ao usuário.
O problema reside precisamente na parte do "vocabulário" do segmentador de palavras.
A partir do lançamento do GPT-4o em maio de 2024, OpenAI alterou seu esquema de codificação de segmentação de palavras de `cl100k_base` para uma nova versão, `o200k_base`. Esta última adiciona muitas palavras e frases comuns em chinês à lista de palavras, atribuindo-lhes IDs numéricos independentes, em vez de fragmentá-las em caracteres individuais como antes.
No entanto, a equipe que treinou o segmentador de palavras parecia desconhecer que o corpus chinês que utilizaram continha uma grande quantidade de dados provenientes de sites pornográficos, de jogos de azar e de filmes e programas de televisão pirateados, extraídos da internet externa.
O método de treinamento para segmentadores de palavras é simples: combinar as sequências mais frequentes no corpus, defini-las como uma unidade de palavra e atribuir-lhe um ID. Infelizmente, os "anúncios pequenos" são os que melhor repetem as mesmas frases publicitárias fixas em vários sites, tornando-os muito fáceis de serem identificados pelos segmentadores de palavras.
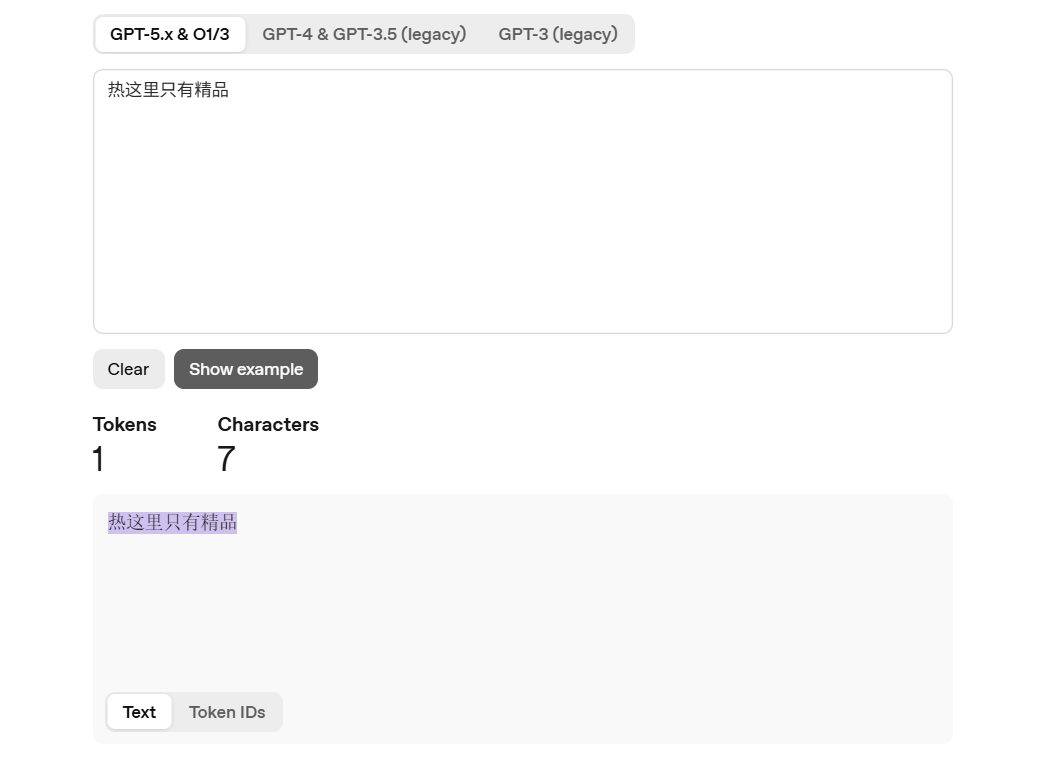
Assim, o vocabulário final `o200k_base` ficou repleto de uma quantidade enorme de pequenos anúncios. Além disso, quanto mais longa a palavra, mais problemática ela se tornava (pois frases longas raramente aparecem repetidamente em corpora normais).
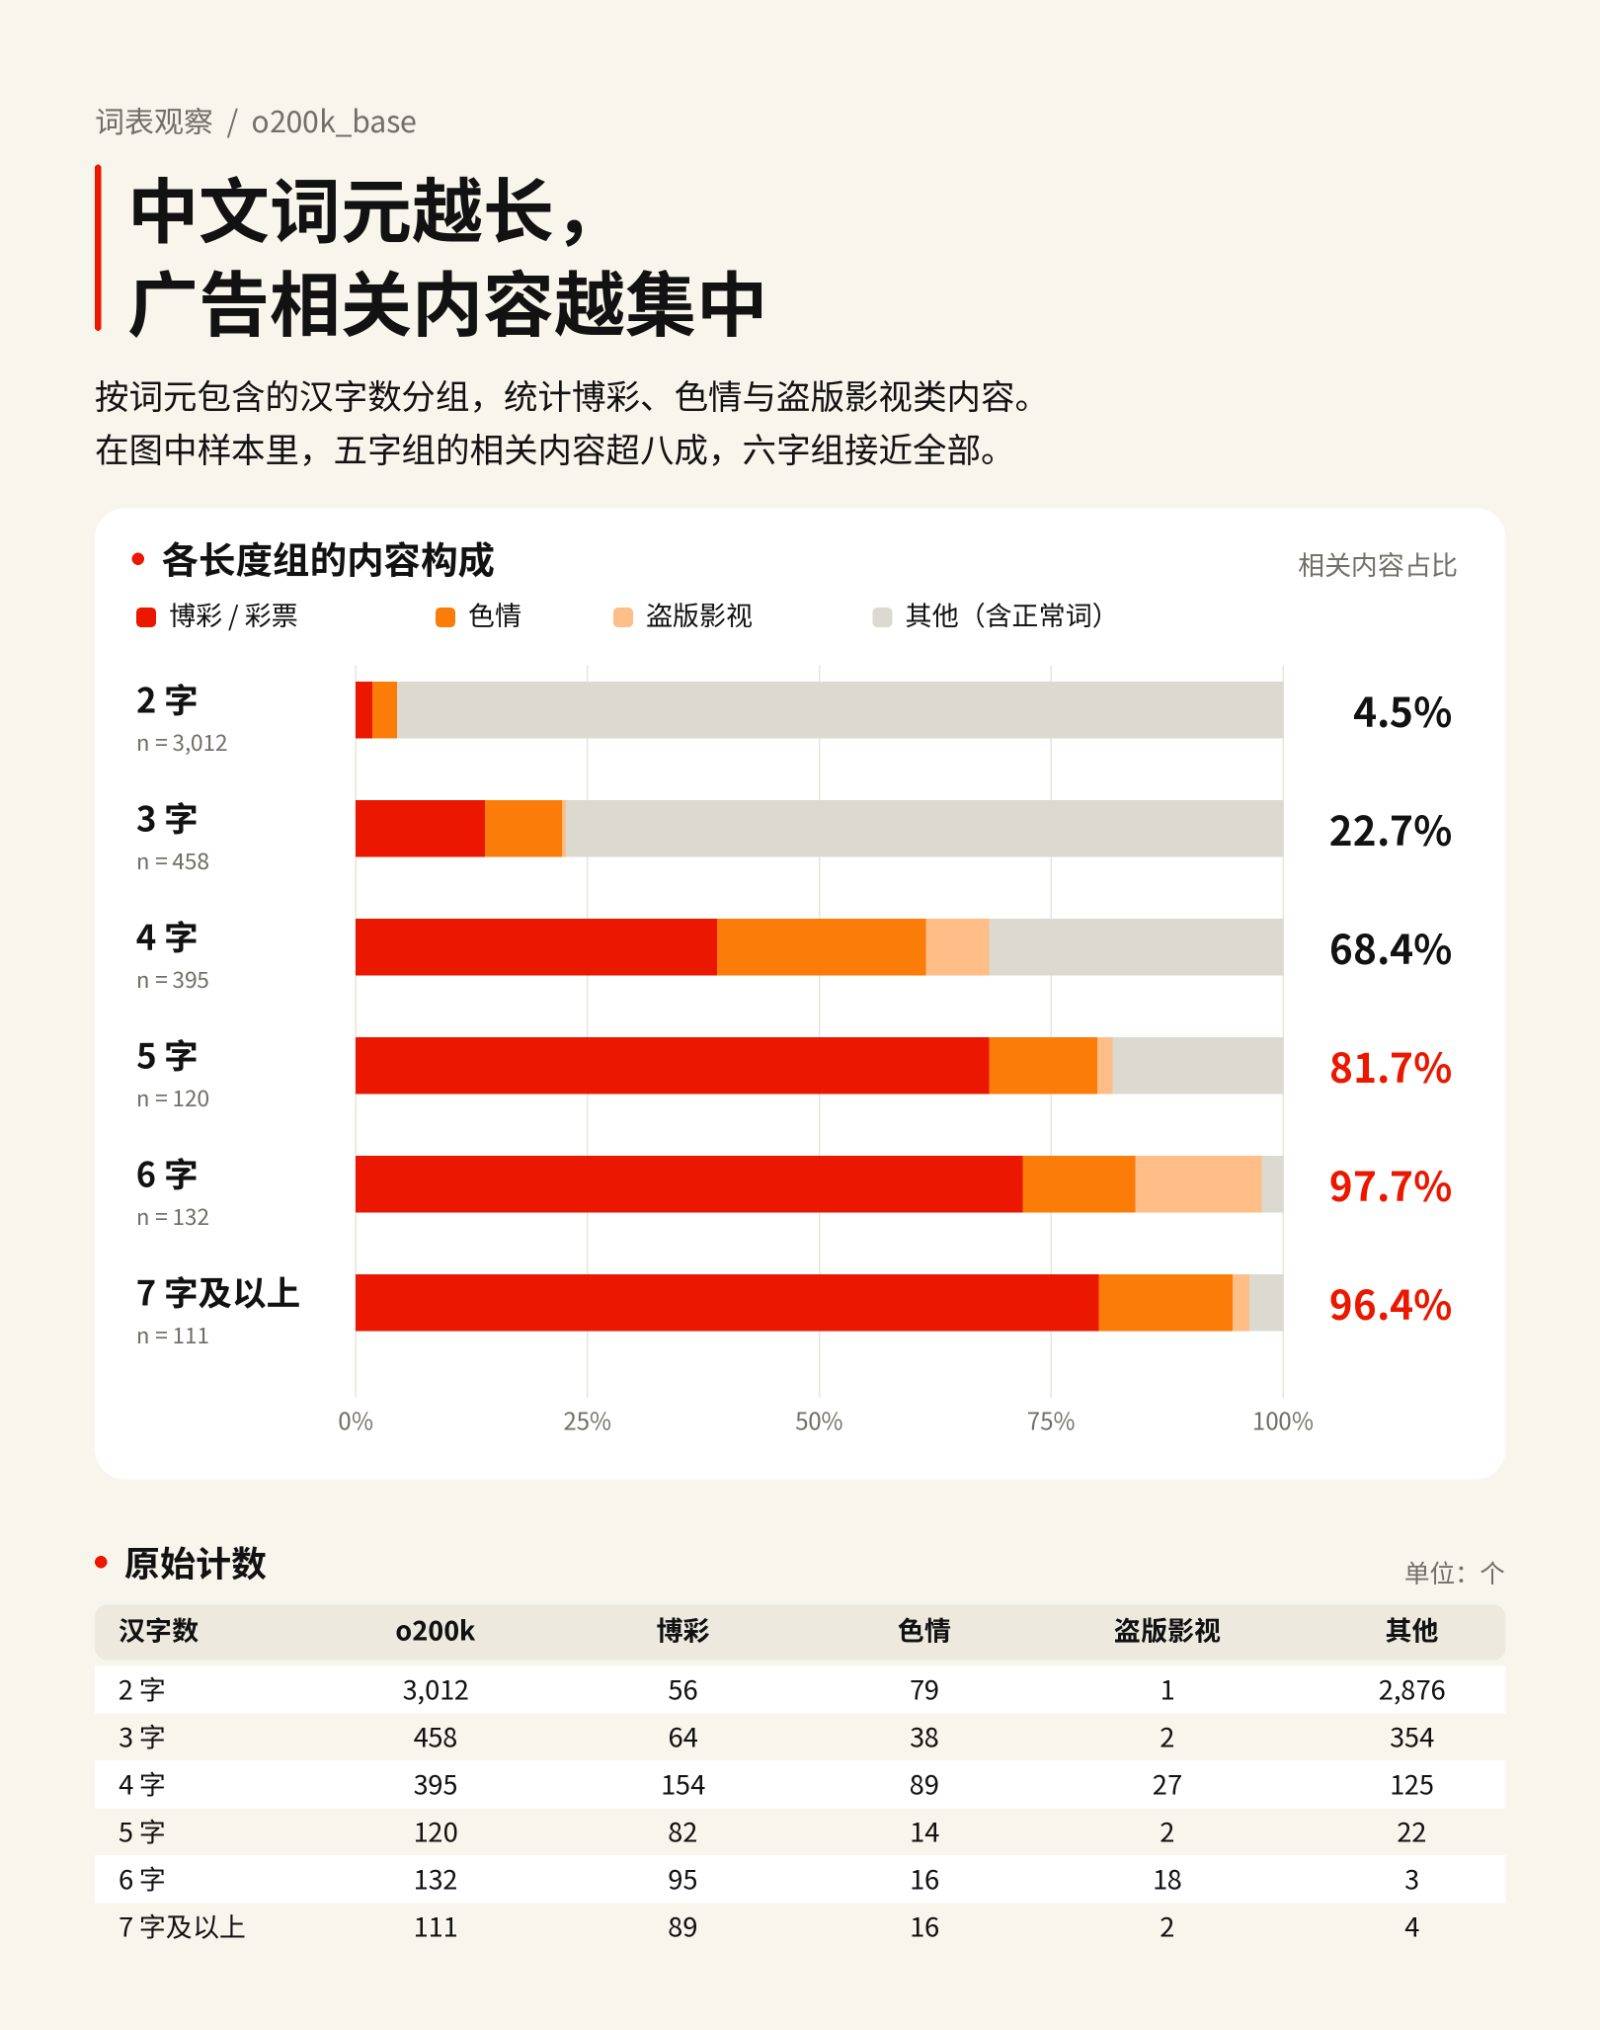
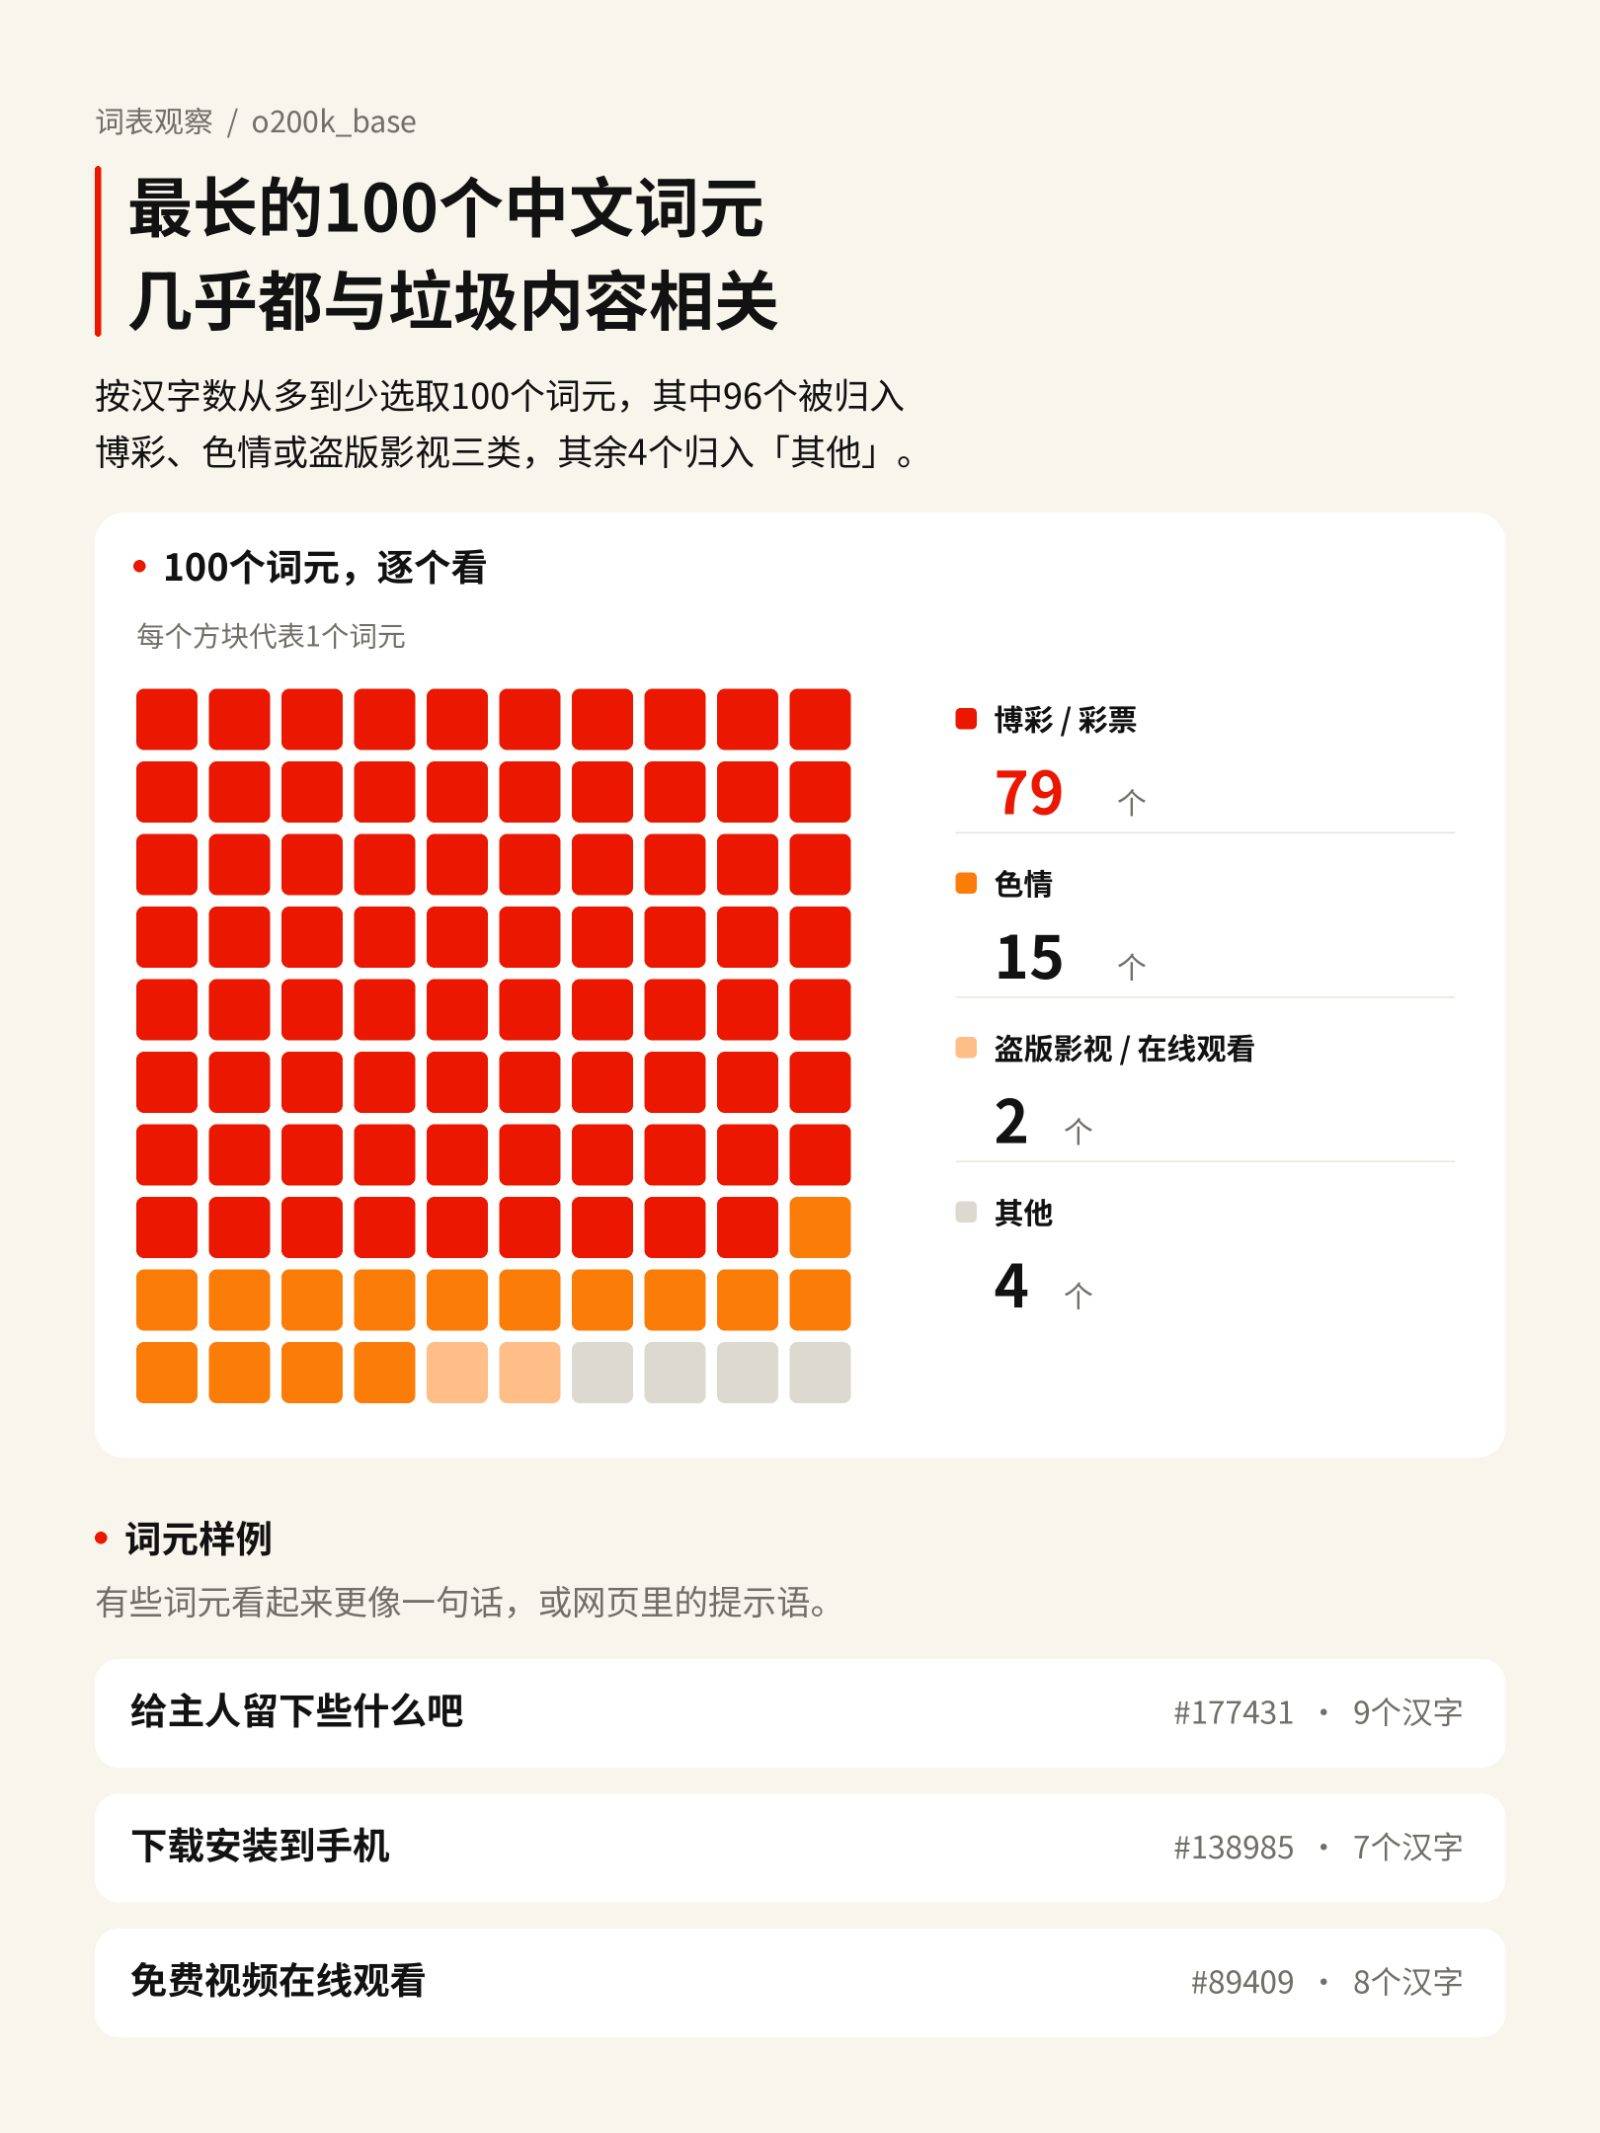
Os autores do artigo descobriram que 68% das palavras com quatro caracteres no vocabulário eram pequenos anúncios; e 98% das palavras com mais de seis caracteres também eram anúncios. Das 100 palavras mais longas em chinês, 96 estavam relacionadas a jogos de azar, pornografia ou filmes pirateados. Os dados não tratados levaram, em última análise, a que `o200k_base` se tornasse, em certa medida, uma "otimização negativa".
Por outro lado, diferentemente do treinamento "extensivo" de segmentadores de palavras, antes de treinar formalmente o modelo de linguagem, a equipe geralmente precisa limpar os dados de treinamento novamente, removendo conteúdo duplicado e anúncios de baixa qualidade. Como resultado, anúncios pequenos têm identidade de palavra e ID numérico independentes no vocabulário, mas o modelo de linguagem quase nunca viu a matriz que representa essa palavra e não consegue entender o significado específico dessa matriz, mesmo após pesquisar o contexto.
Para o modelo, esta é apenas uma palavra com "significado obscuro", muito parecido com quando vemos uma palavra em suaíli — você sabe que é uma palavra, mas não entende o seu significado.
Para verificar isso, você pode realizar um experimento simples: peça ao ChatGPT para repetir ou interpretar frases como "deixe algo para o dono" e "␣大发快三不是" — palavras que existem no vocabulário, mas foram removidas antes do treinamento formal do modelo. Você verá que ele começa a "ler e responder aleatoriamente". Isso ocorre porque, para o GPT, você está simplesmente enviando uma palavra quase sem sentido.
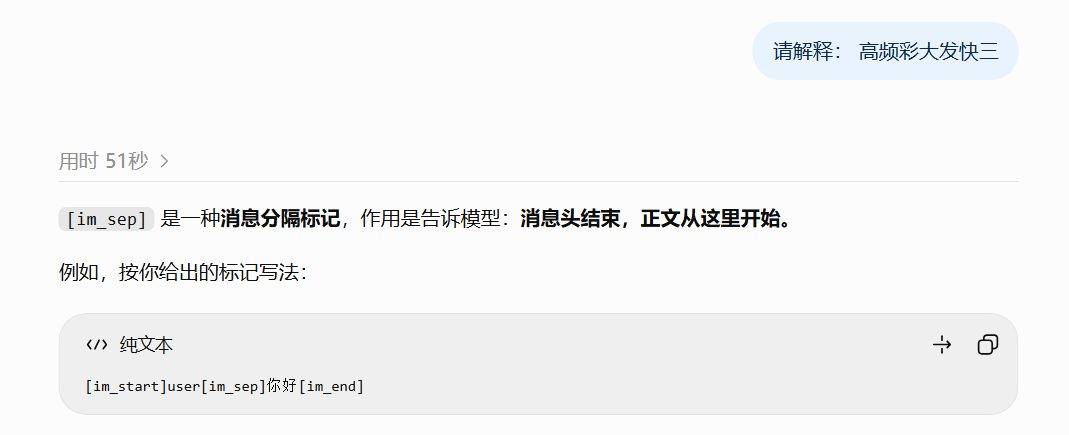
Com a convergência dessas duas pistas, podemos agora revelar, em linhas gerais, o princípio por trás da geração de títulos de anúncios ChatGPT .
Primeiramente, ChatGPT utiliza um modelo de geração de títulos péssimo. Às vezes, ele não consegue parar após o término do título e continua inserindo diversos fragmentos de linguagem e caracteres ilegíveis. Além disso, como o próprio modelo é treinado com dados limpos, ele nunca viu e não consegue interpretar várias pequenas palavras publicitárias, então ele acaba enviando todas essas palavras para a "sala de lixo" que coleta caracteres ilegíveis.
Quando comete um erro e tenta inserir um "texto ilegível" no final do título, escolhe aleatoriamente uma palavra da "sala de lixo"; considerando a posição dominante das palavras publicitárias curtas em termos de quantidade, o que acaba misturado ao título é muito provavelmente um pequeno anúncio.
Resolver esse problema não é particularmente difícil nem particularmente fácil.
O método mais simples seria estabelecer "regras de inspeção pós-evento", adicionando uma etapa extra para verificar se os títulos gerados pelo modelo estão em conformidade e enviando os títulos não conformes para regeneração. Esta pode ser a solução atual e também explica por que alguns anúncios pequenos passaram despercebidos, apesar da redução desse tipo de anúncio.
Quanto à solução real, ainda é necessário reconstruir uma lista de vocabulário limpa — as listas de vocabulário limpas de outras empresas nunca enfrentaram esse problema.
O desafio reside no fato de que o vocabulário e o modelo base estão interligados. Atualizar o vocabulário significa treinar novamente todo o modelo, e OpenAI claramente não tem incentivo para reformular todo o modelo base em prol de uma melhor experiência do usuário chinês.
Parece que, por algum tempo, seremos obrigados a coexistir com pequenos anúncios.