Primeira análise prática do notebook NVIDIA RTX Spark: consegui atingir o limite de crédito do WorkBuddy
O primeiro lote de laptops Windows equipados com os superchips NVIDIA RTX Spark acaba de ser lançado para venda.
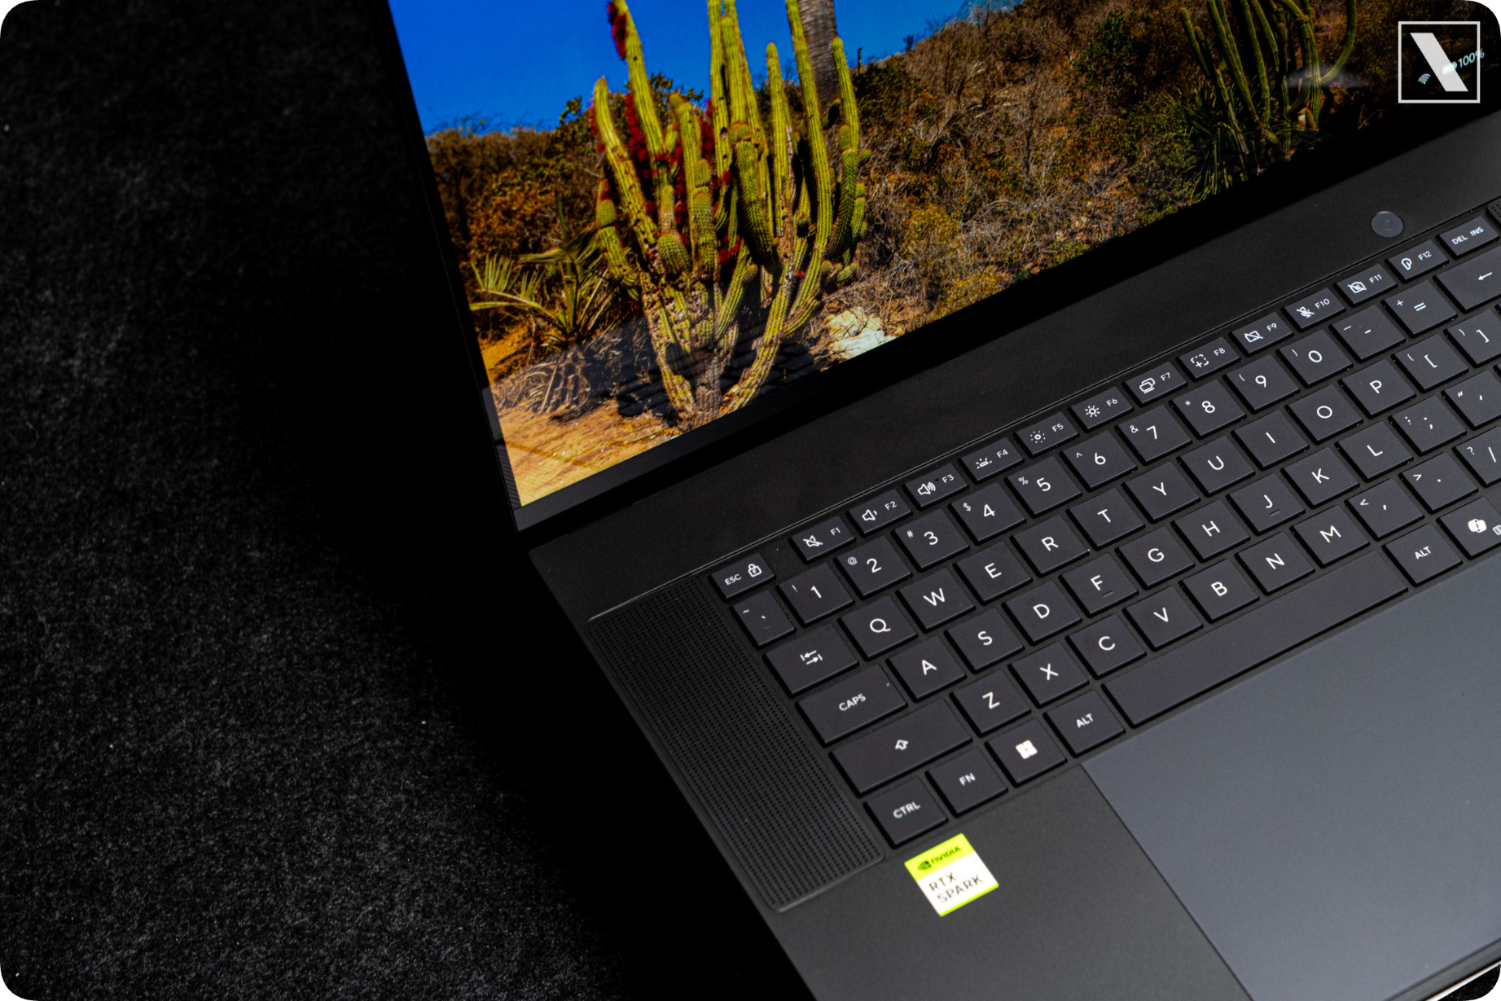
A APPSO também teve acesso antecipado ao ASUS ProArt 16 RTX Spark. A versão de 16 polegadas com 64 GB de memória unificada custa 28.999 RMB, enquanto a versão de 128 GB com memória unificada custa 37.999 RMB.
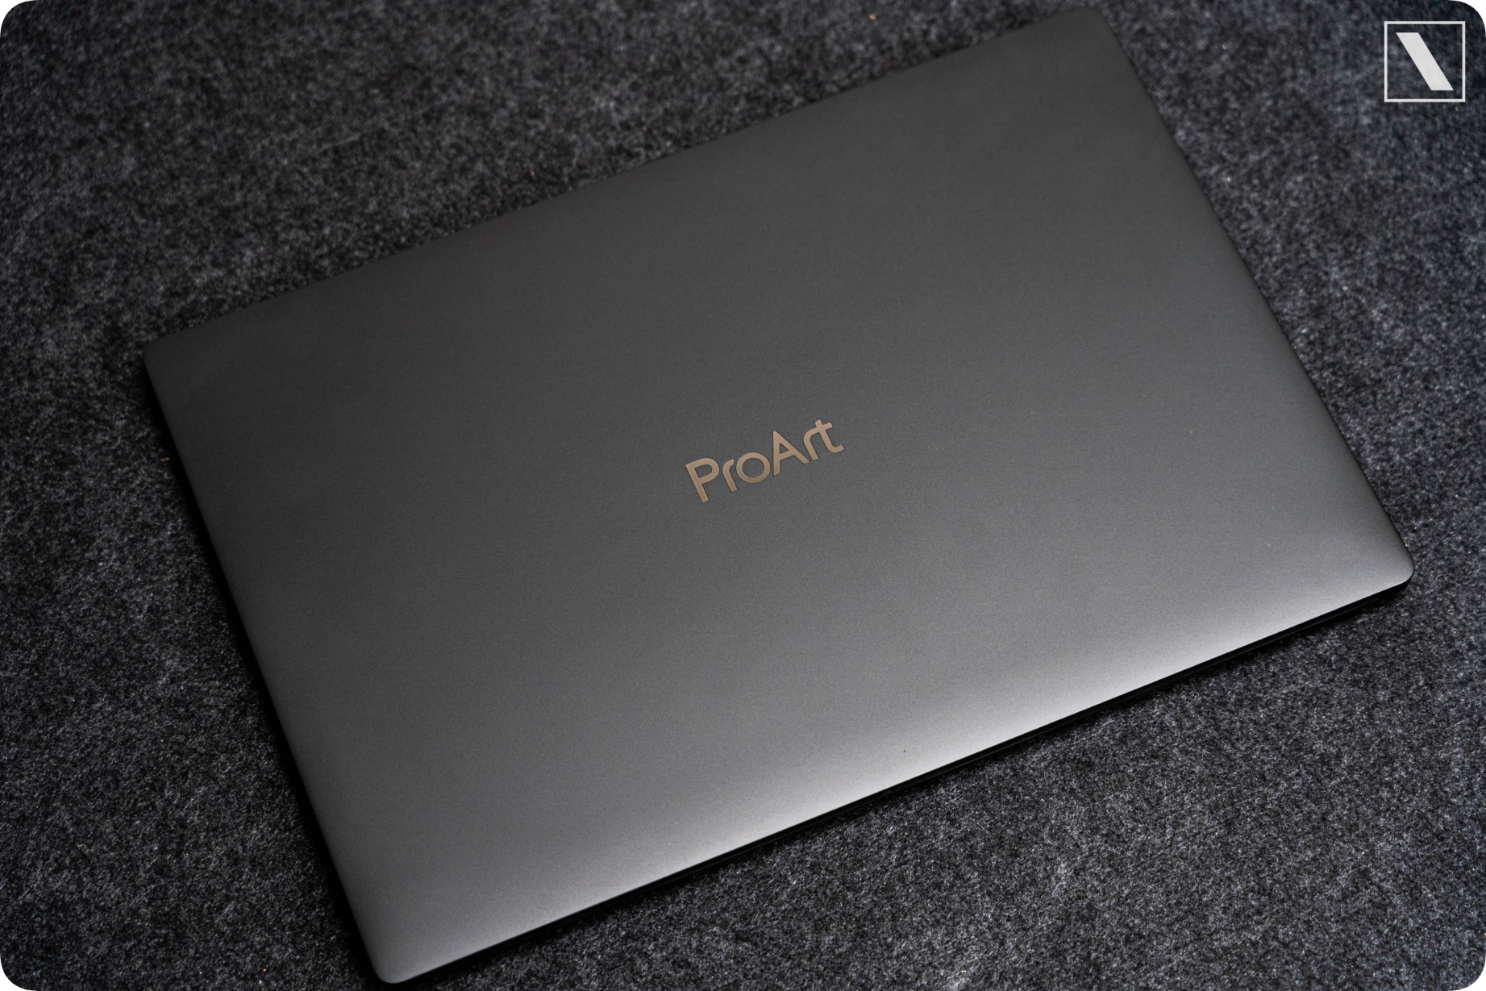
Esta é a primeira vez que a Nvidia entra na plataforma de hardware principal dos PCs com Windows desta forma. Anteriormente, a maioria dos computadores com Windows utilizava processadores Intel ou AMD, sendo a Nvidia responsável apenas pelo fornecimento de placas gráficas aos fabricantes de computadores.
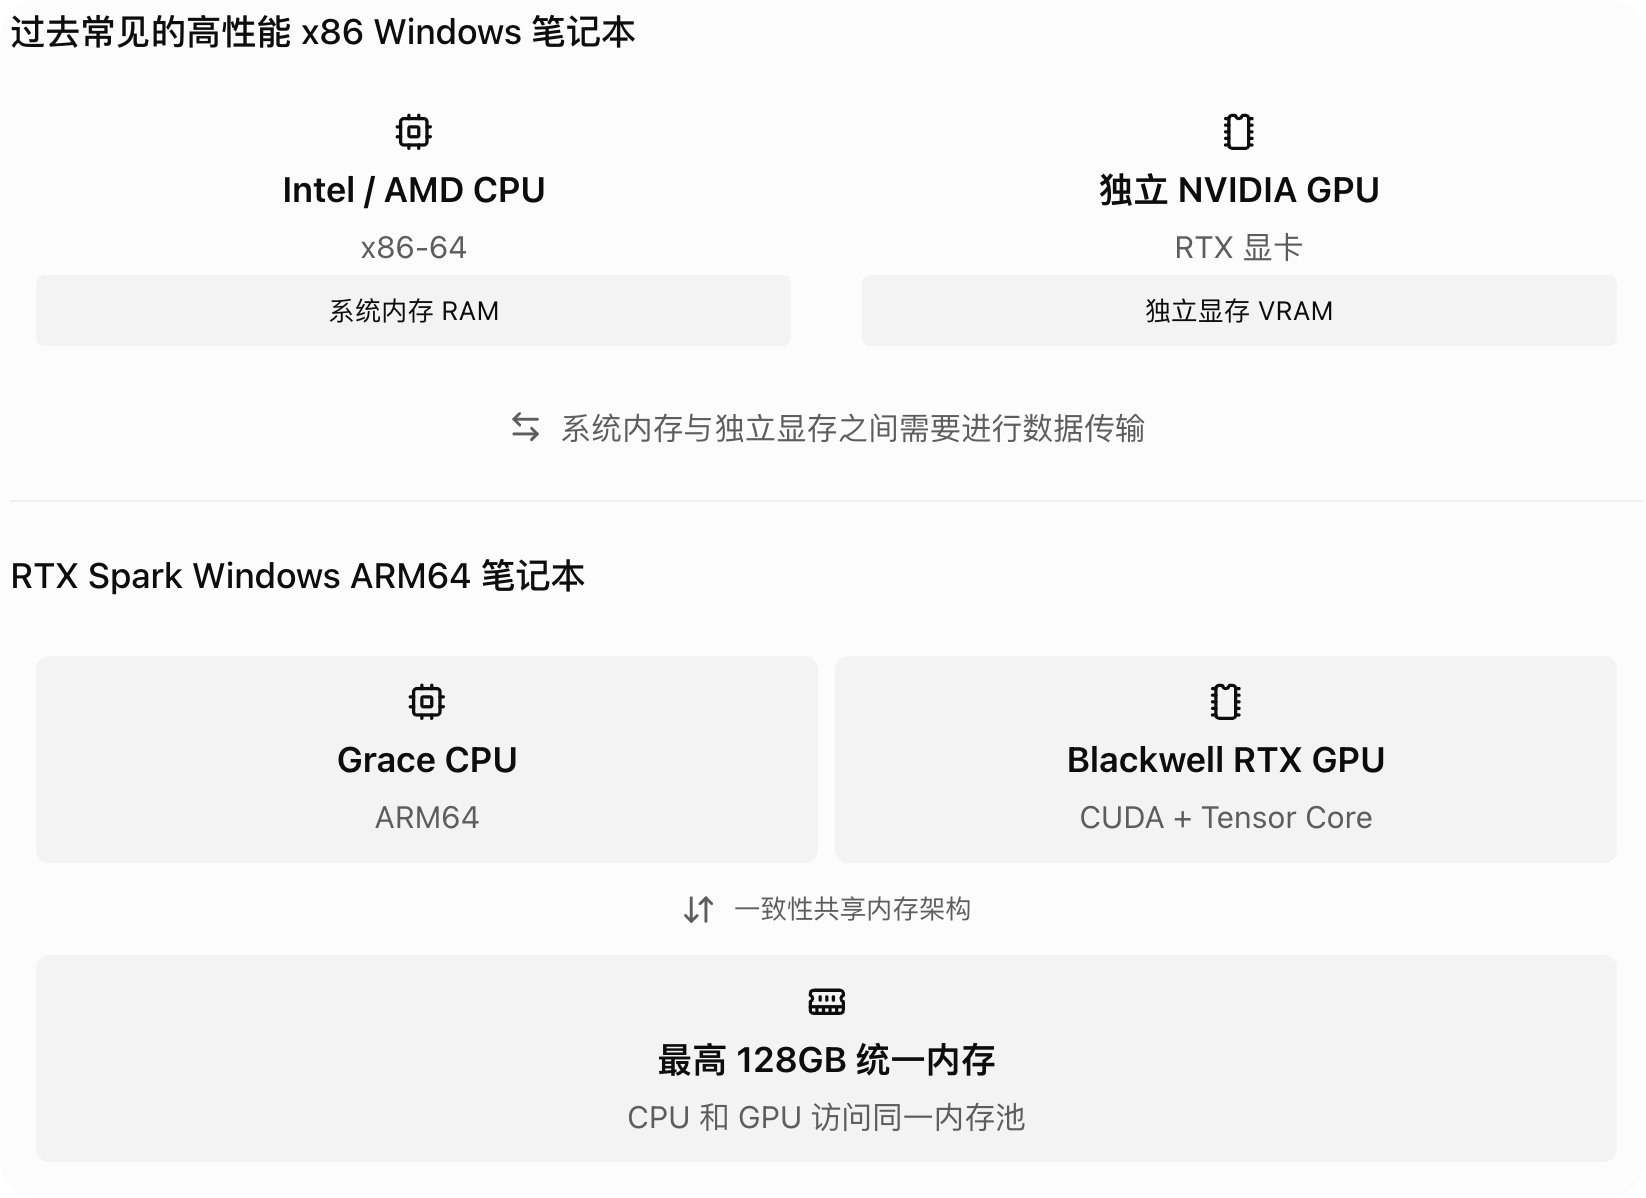
Agora, a Nvidia está começando a combinar suas CPUs ARM, GPUs Blackwell RTX e memória unificada para lançar uma plataforma de computação completa capaz de executar o Windows.
Após algum tempo de uso, a APPSO revelou mais detalhes para todos, incluindo como ele se compara a um Mac como um PC com IA e se pode ser considerado um "produto de investimento" com potencial de valorização.
Adaptar o modelo grande a um computador com pelo menos 12,9 mm de espessura.
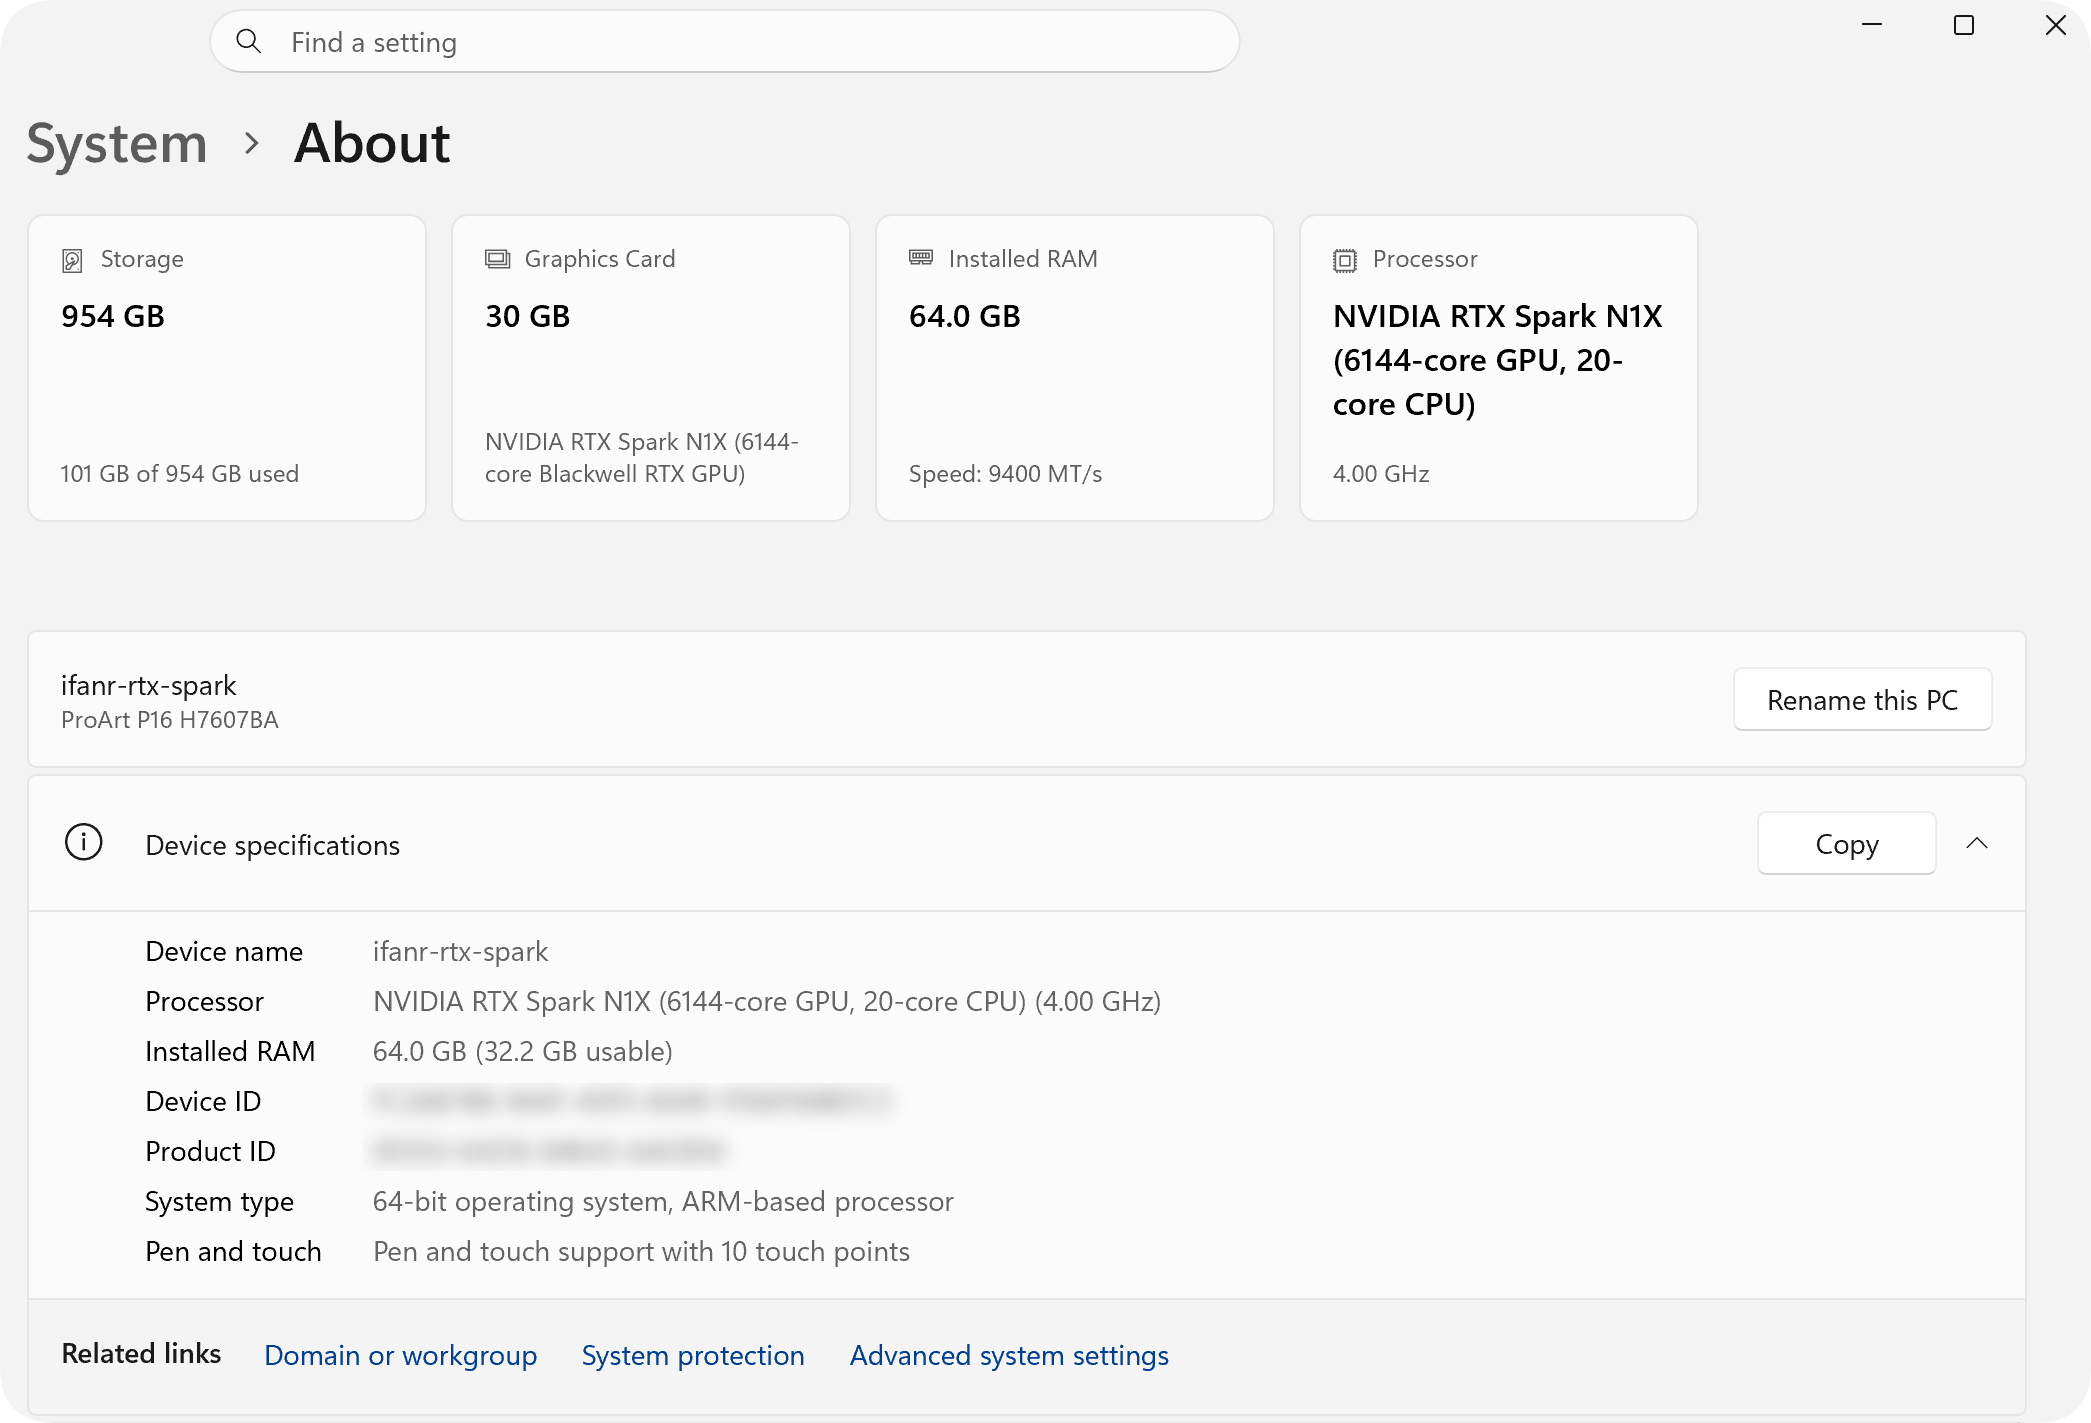
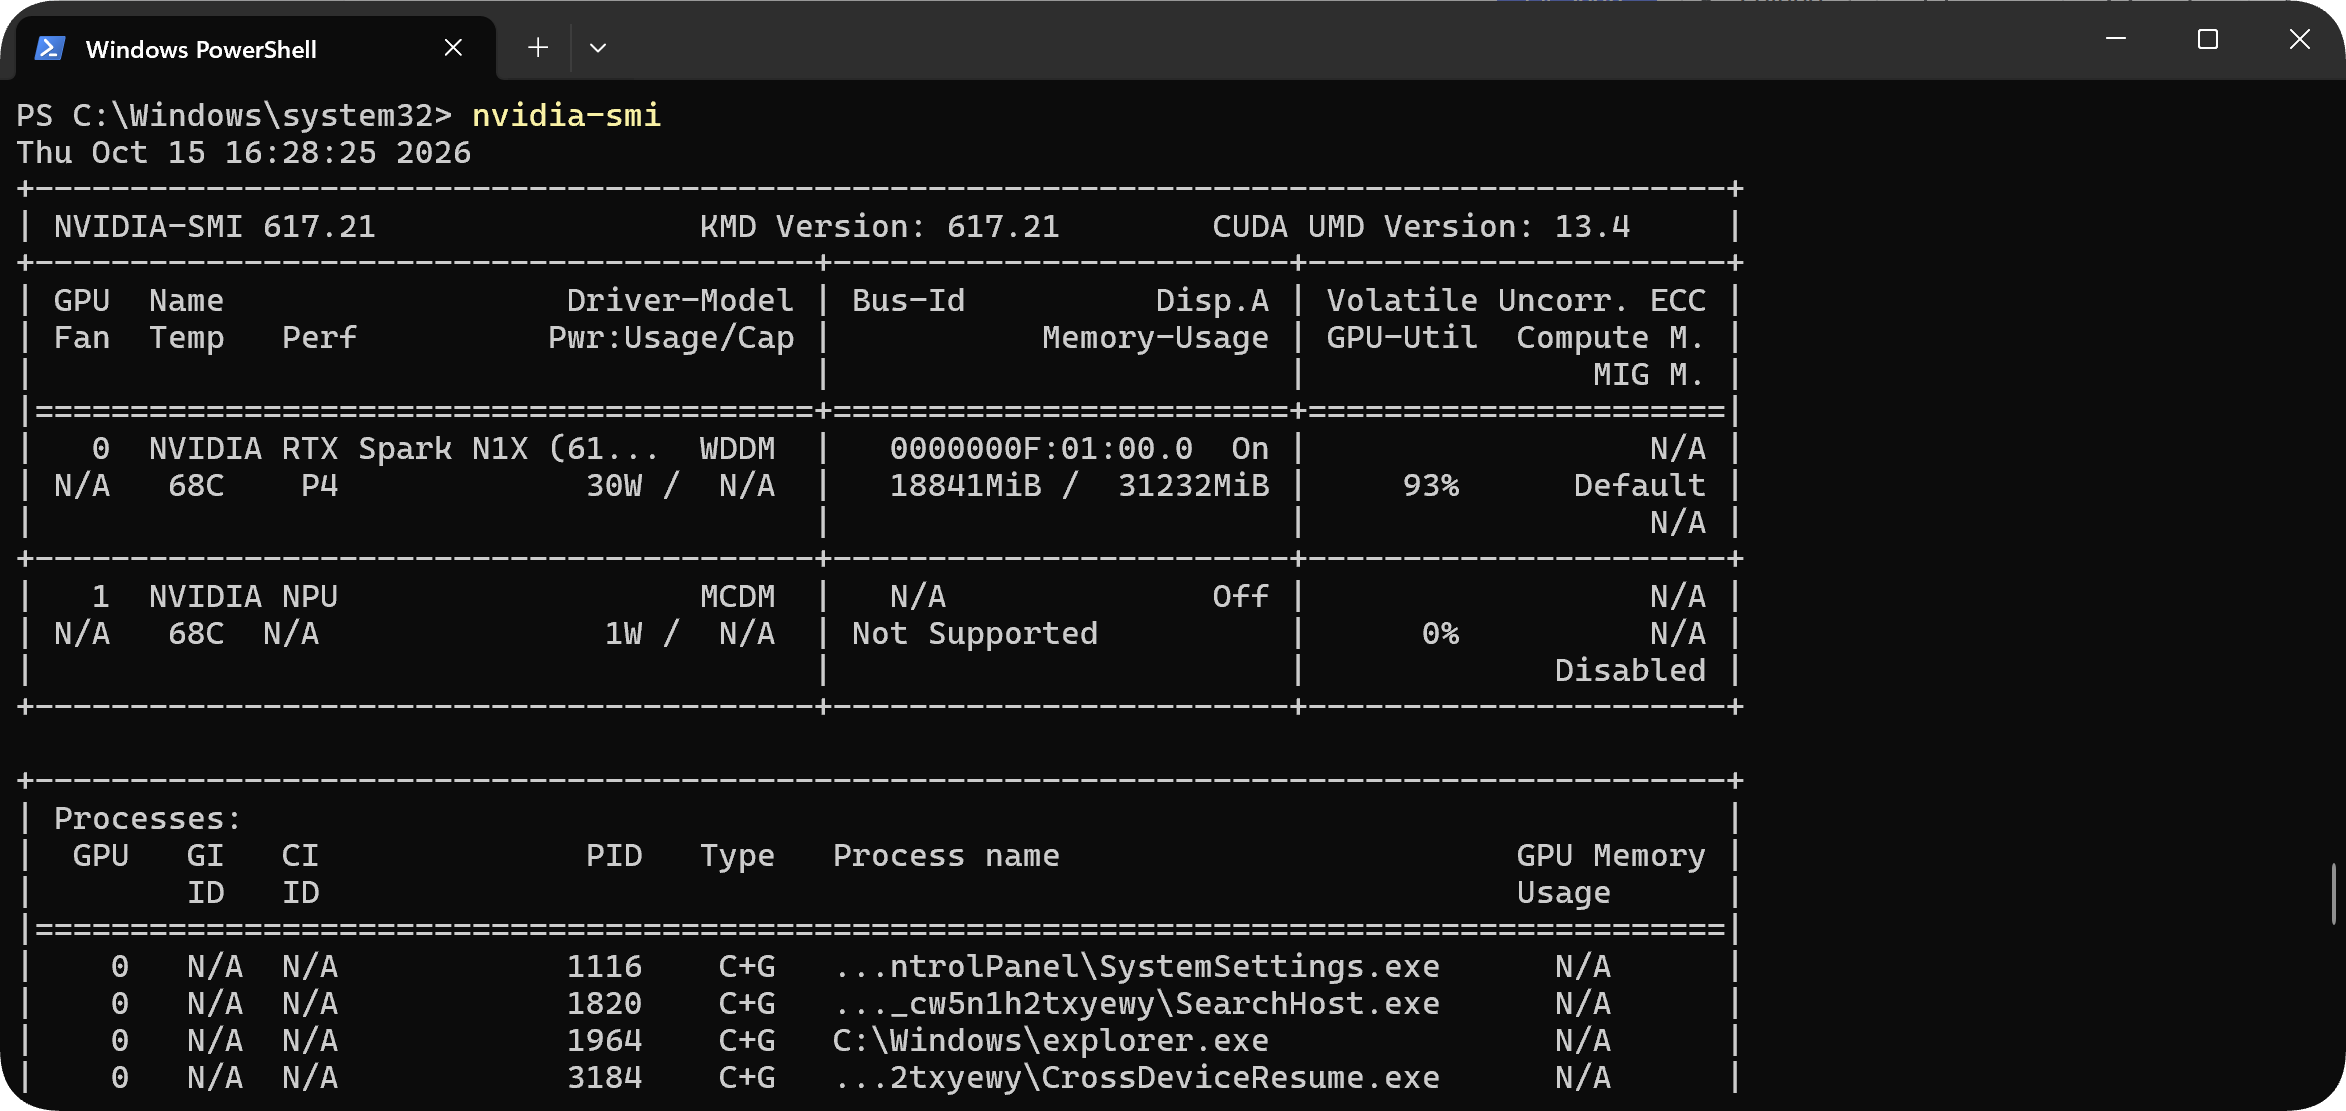
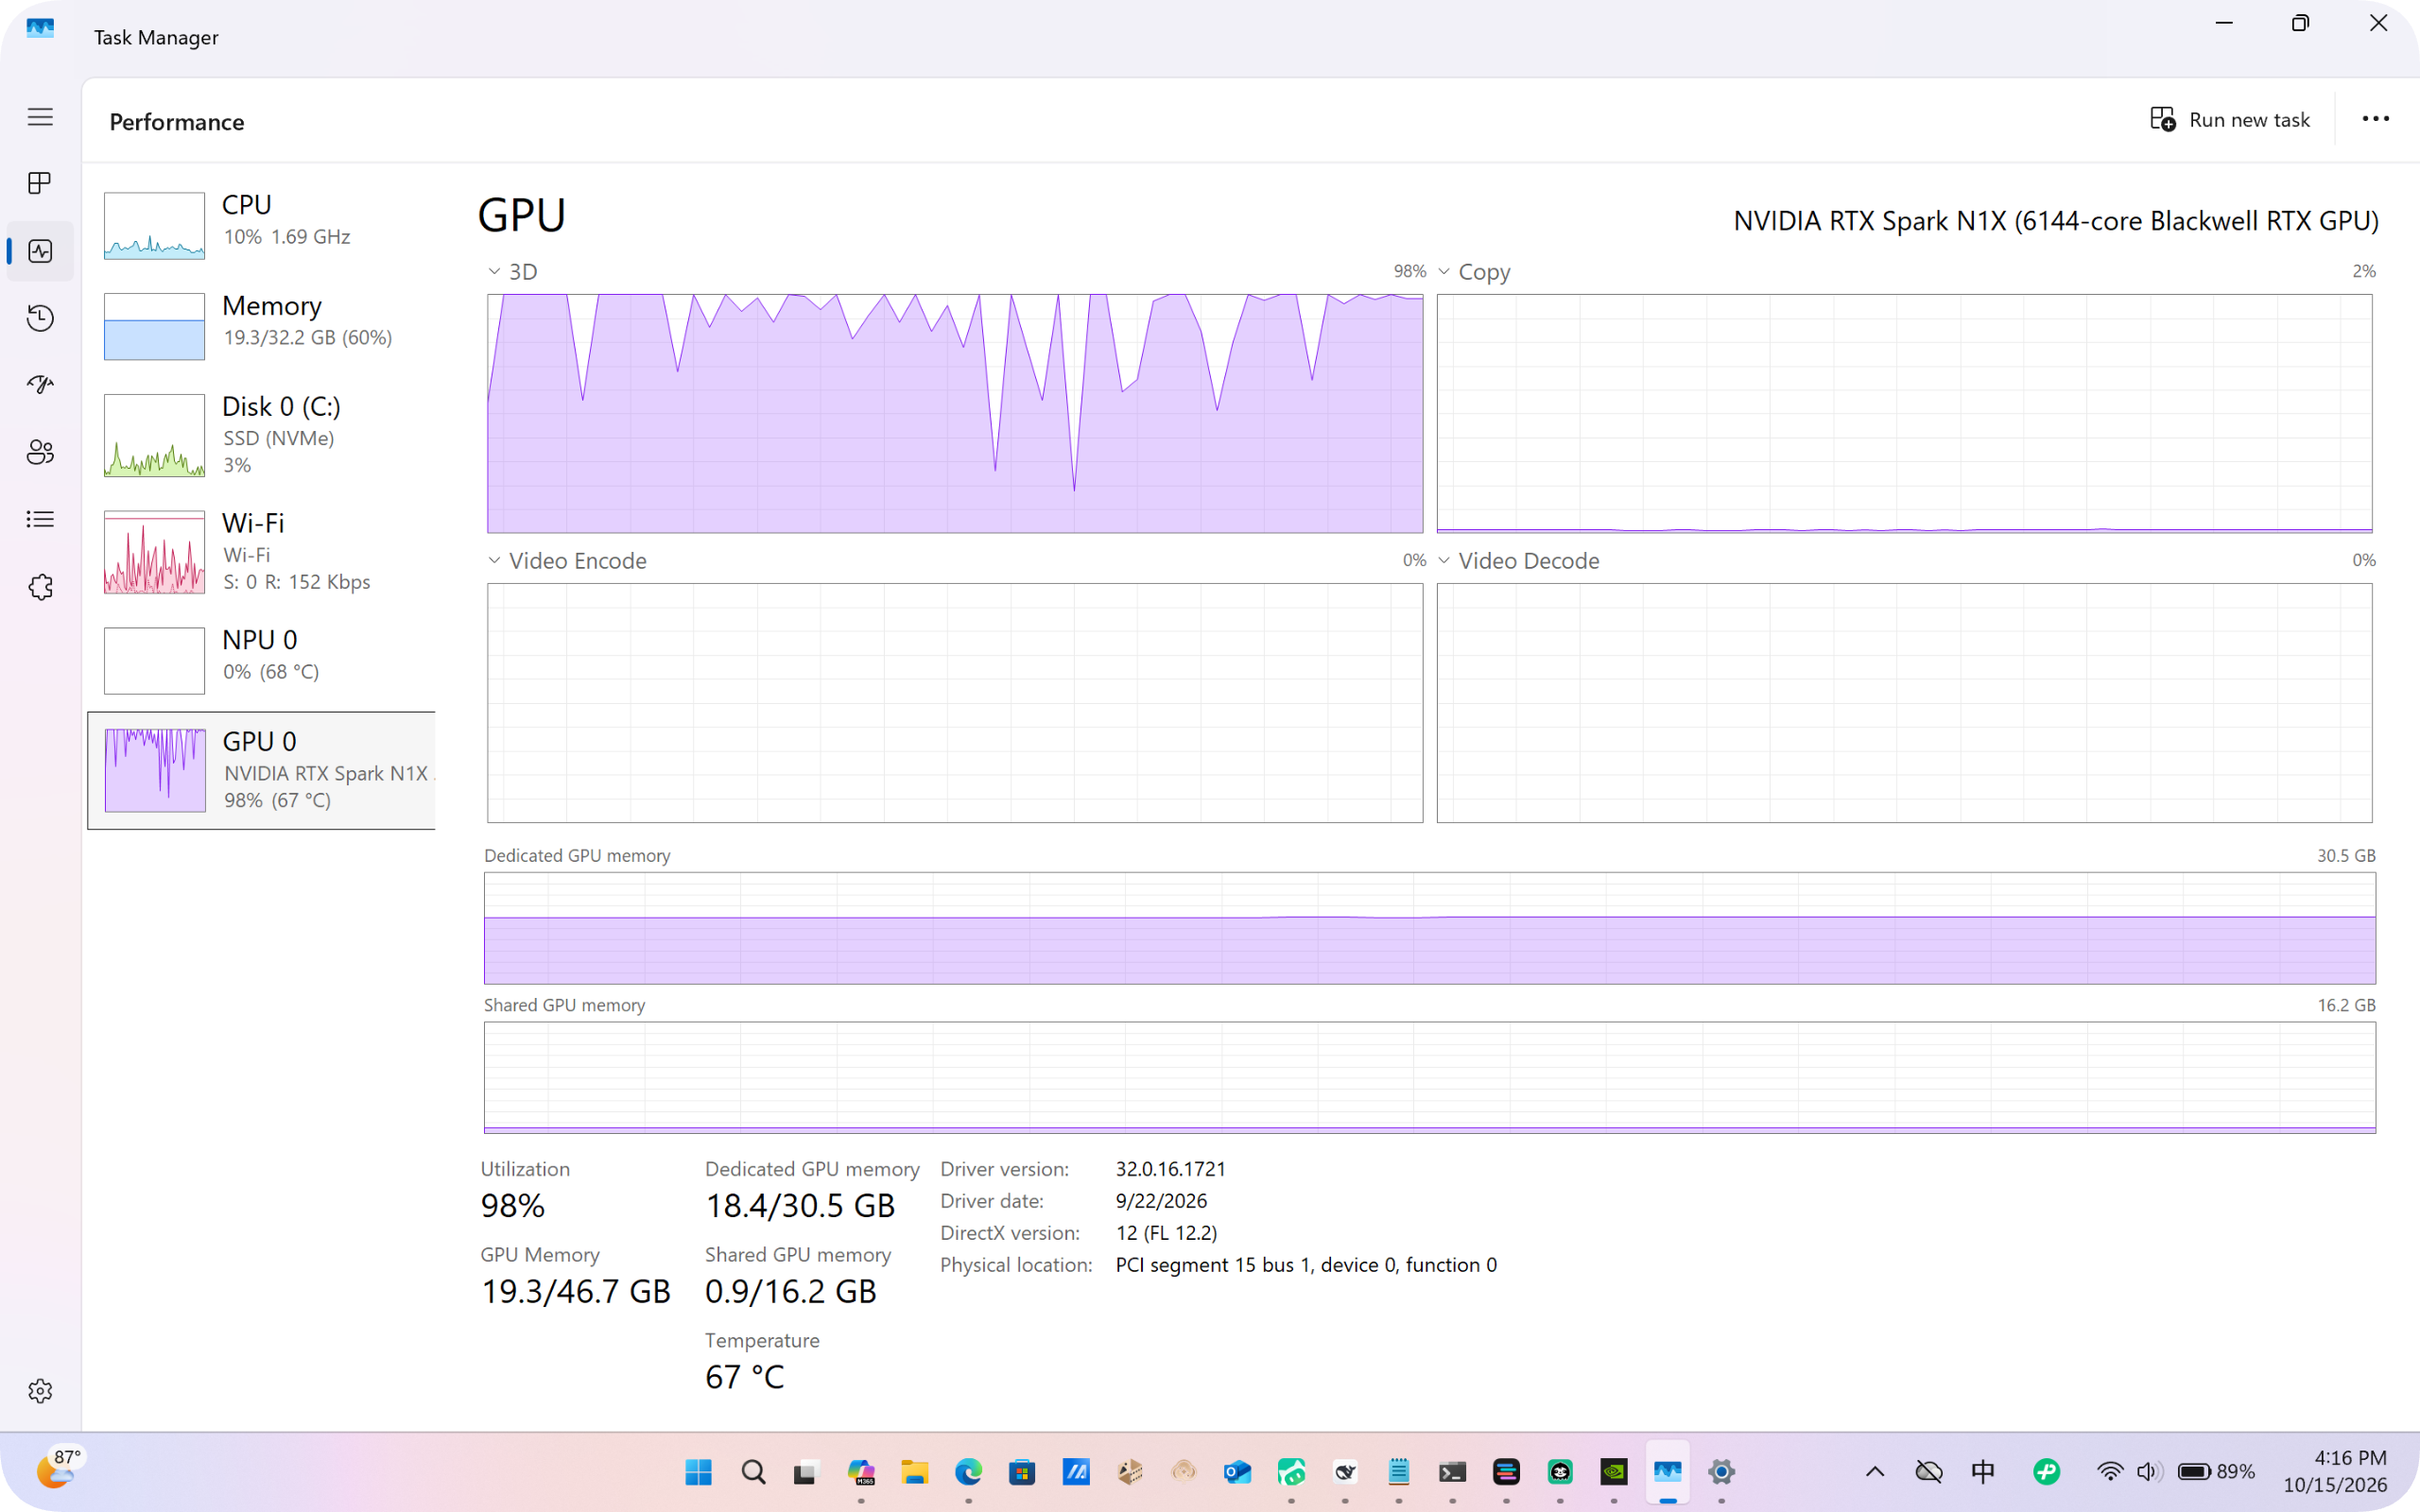
A versão que recebemos possui 64 GB de memória unificada. Como utiliza memória unificada, a memória útil da GPU é de aproximadamente 46,7 GB. O tipo de memória LPDDR5X teoricamente oferece uma velocidade máxima de banda larga de 300 GB/s, o que é suficiente para executar modelos como o Qwen 3.8 com 27 bilhões de parâmetros.
Por outro lado, os laptops com arquitetura ARM e Windows do passado tinham como principal objetivo responder à pergunta: "Será que eles podem ser tão finos, leves, eficientes em termos de energia e ter uma bateria de longa duração quanto o MacBook Air?".
A arquitetura ARM64 do RTX Spark permite que este computador alcance uma eficiência energética semelhante e vantagens de memória unificada como os Macs Apple Silicon, mantendo ao mesmo tempo o ecossistema de aplicativos do Windows e os recursos CUDA da NVIDIA.
Em termos de duração da bateria, o ASUS ProArt 16 RTX Spark possui uma bateria de 99,9 Wh. Utilizamos um modelo local com 27 bilhões de parâmetros para gerar texto continuamente e realizar inferências. Após desconectar o cabo de alimentação, observamos que a potência de descarga da bateria foi de aproximadamente 86,5 W, e a carga restante caiu de 98,5 Wh para 96,1 Wh em apenas 2 minutos.
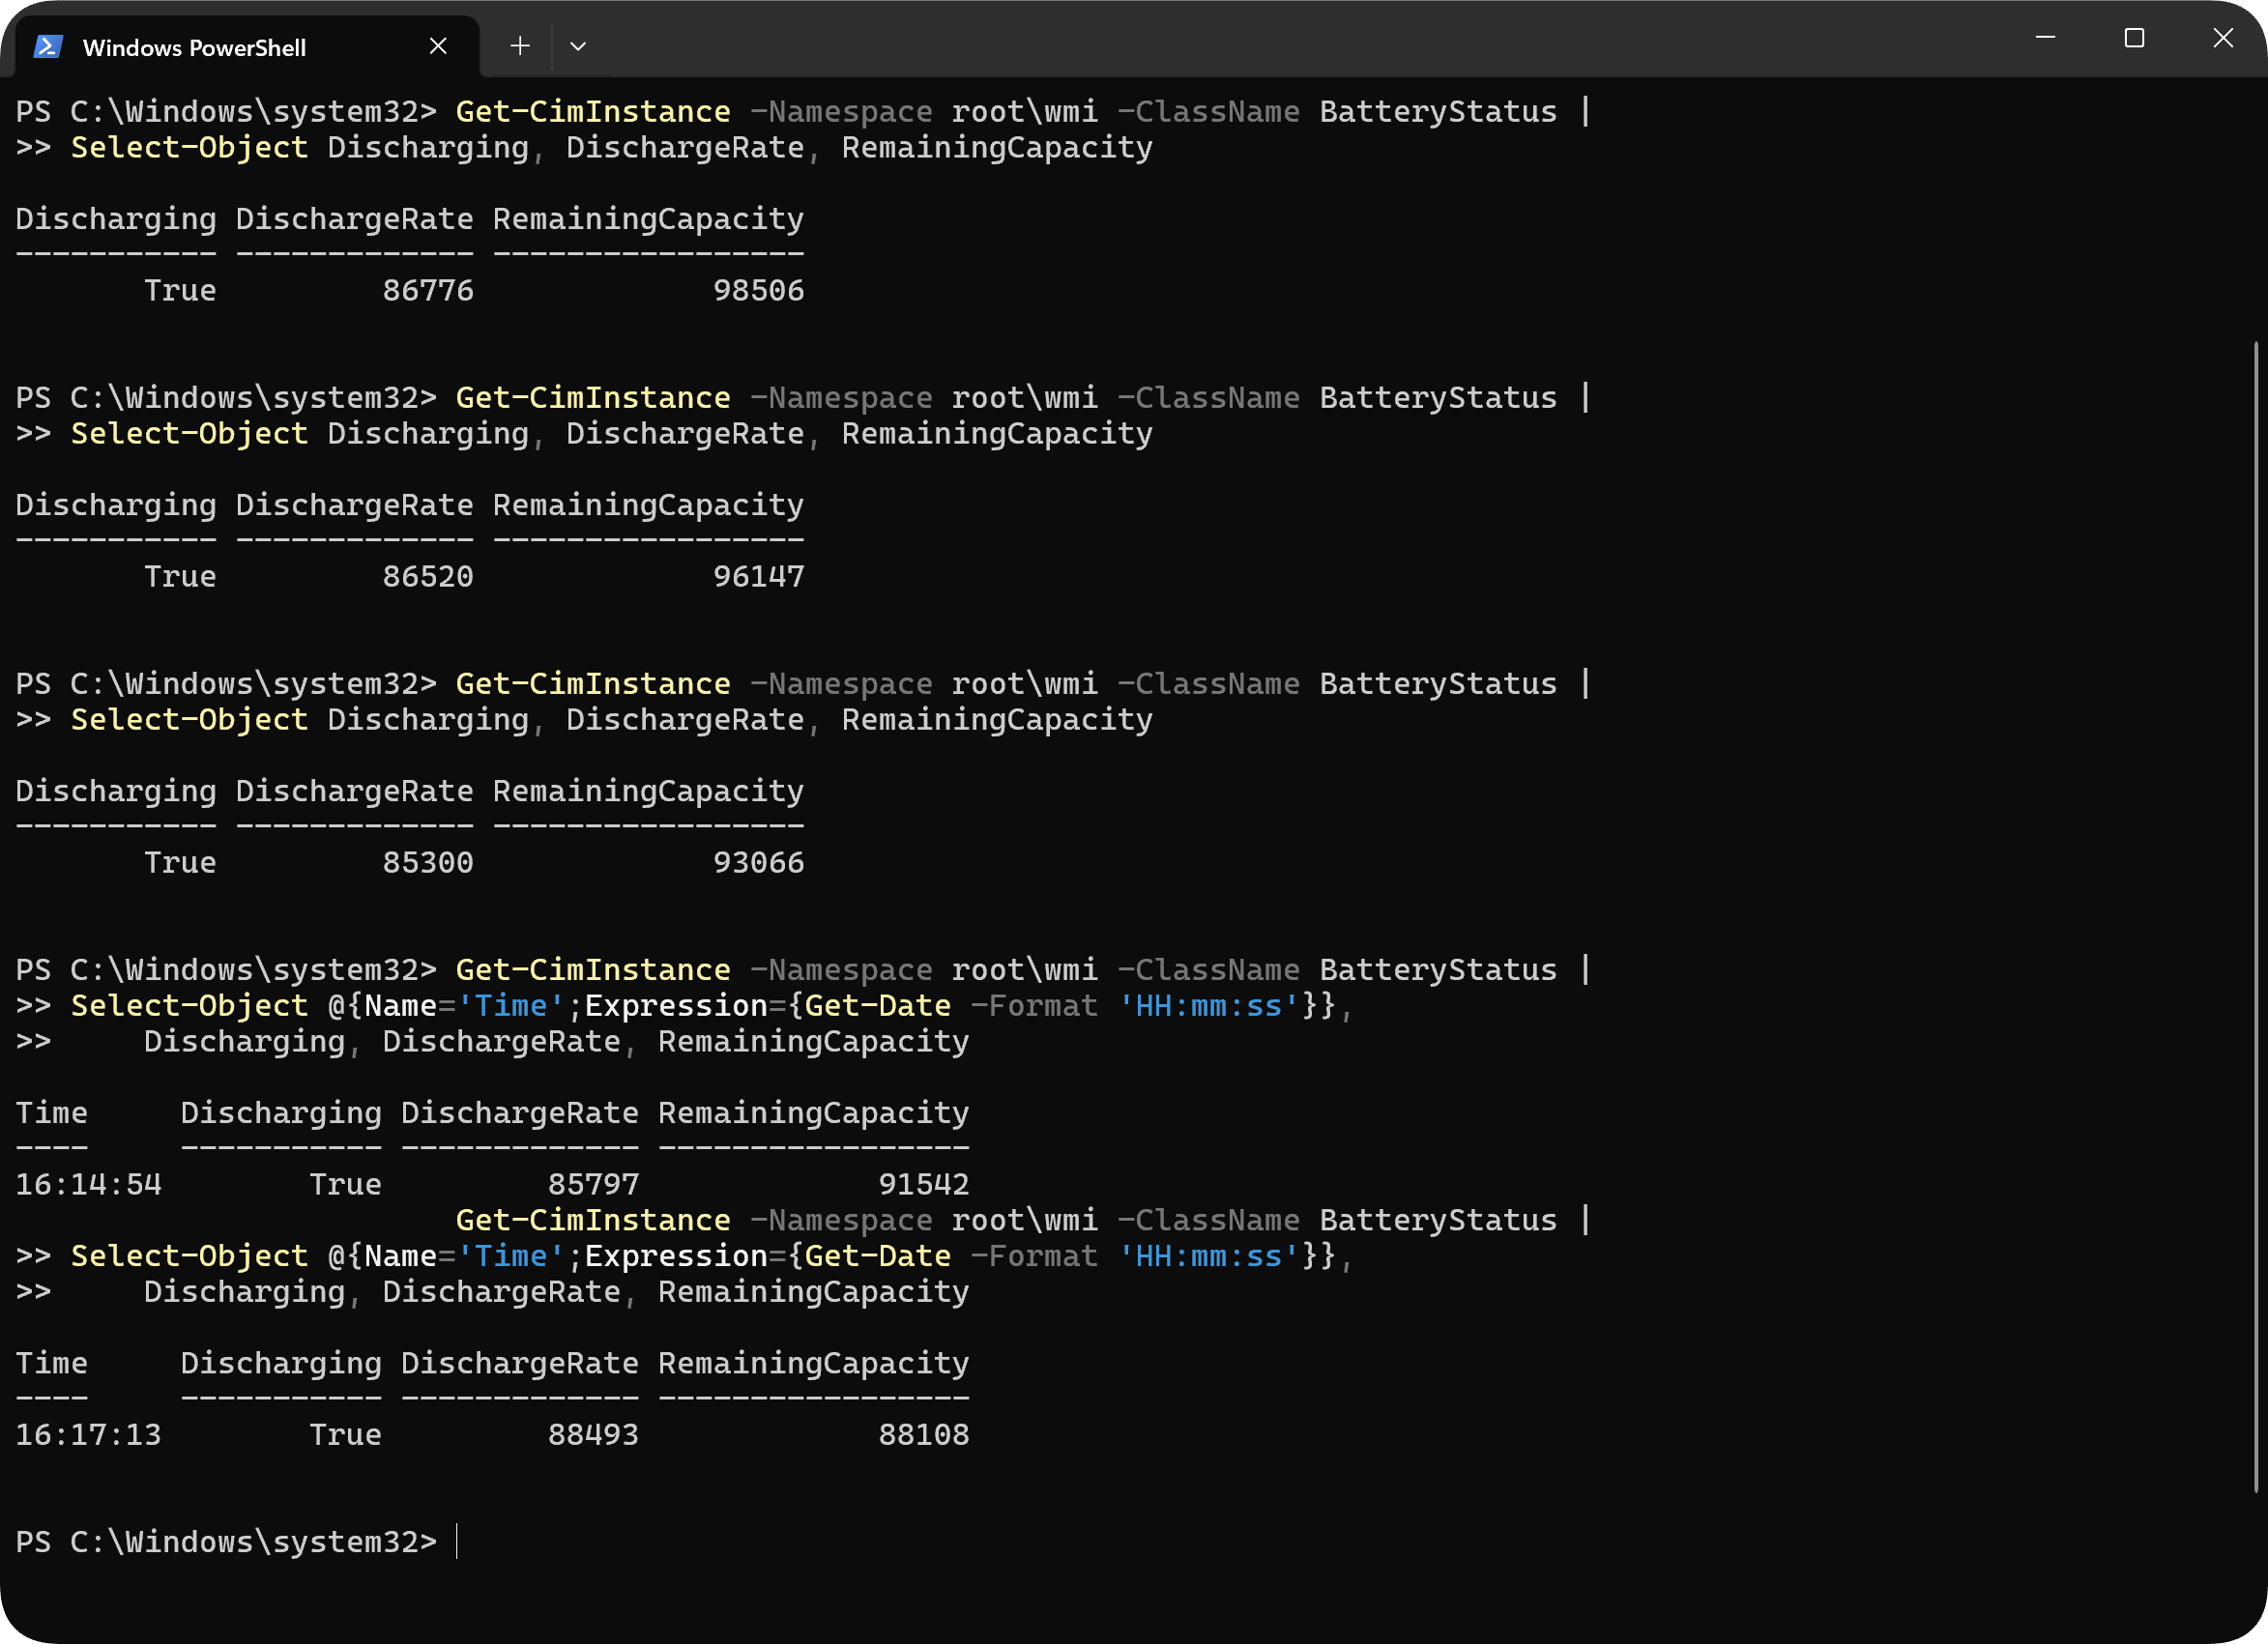
Considerando um consumo médio de energia de 80 W, a duração teórica da bateria de 99,9 Wh é de aproximadamente 1 hora e 15 minutos. Em outras palavras, se você usar continuamente um modelo 27B ou superior, ele poderá durar cerca de uma hora sem precisar ser conectado à tomada.
Para um laptop capaz de executar grandes modelos de IA localmente, com apenas 12,9 mm de espessura e pesando cerca de 1,77 kg, isso significa que, mesmo sem energia, ele pode continuar a lidar com tarefas computacionais de alta carga por um período de tempo.
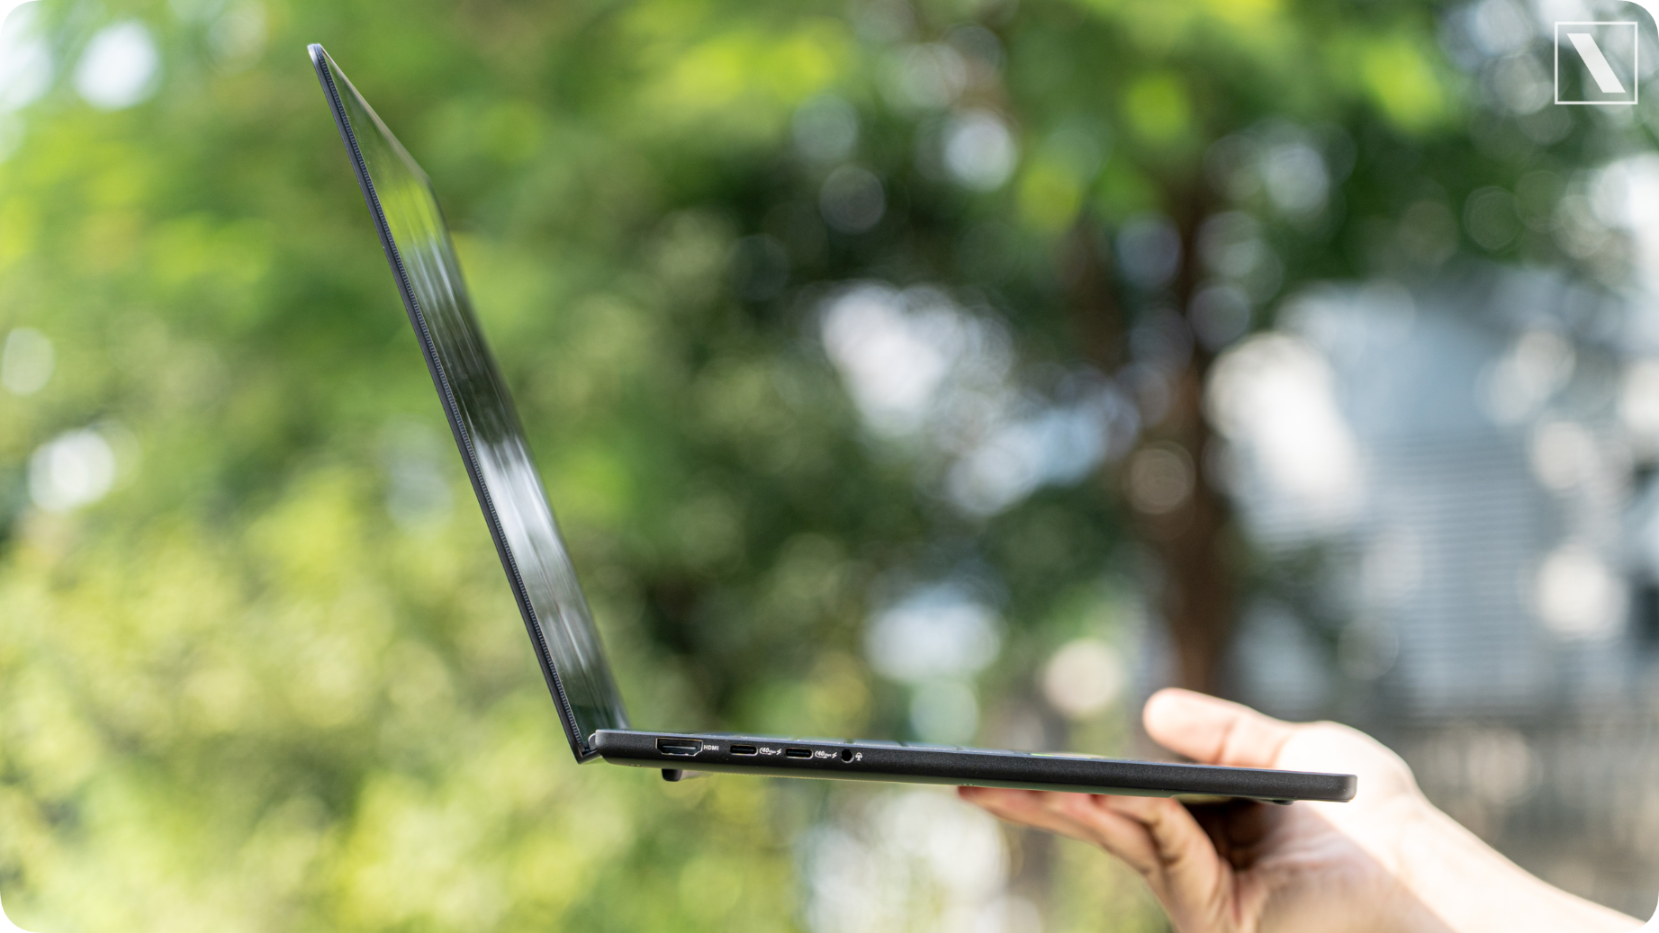
Além da duração da bateria, este notebook ASUS ProArt 16 RTX Spark vem equipado com diversas portas externas, incluindo três portas USB4 Type-C, cada uma com velocidade máxima de 40 Gbps, compatíveis com saída de vídeo e carregamento USB PD.
Uma porta USB-A com USB 3.2 Gen 2, até 10 Gbps; uma porta HDMI 2.1 FRL para conectar um monitor externo; uma porta SD Express 7.0 para cartões de memória de alta velocidade; e uma entrada de áudio de 3,5 mm.
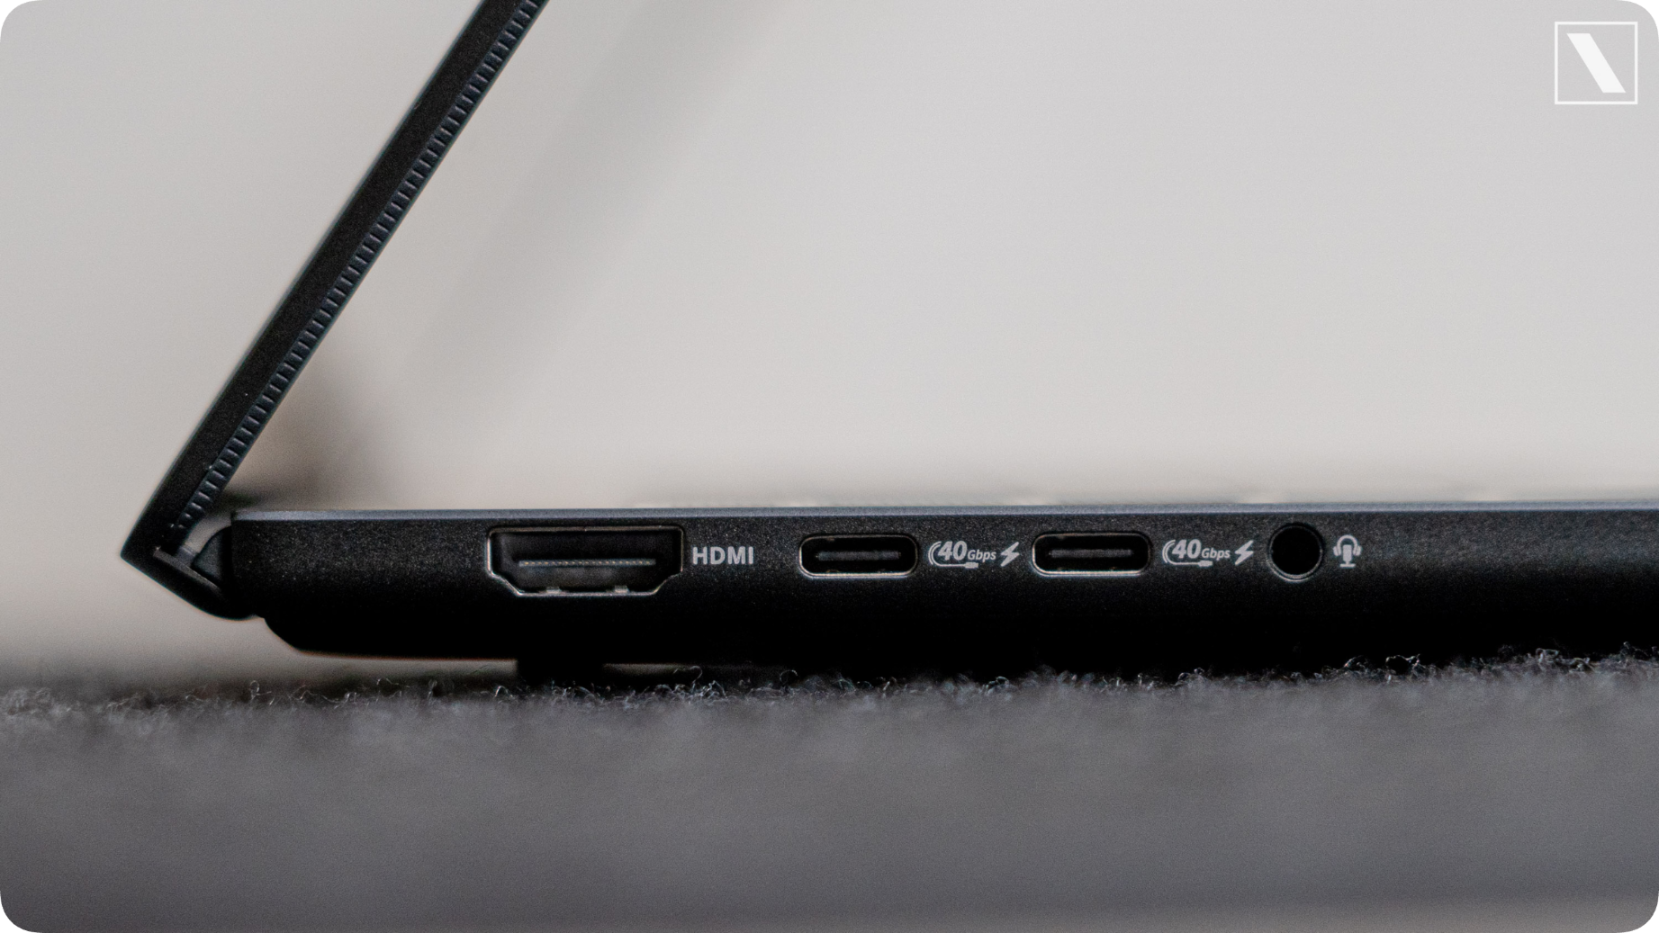
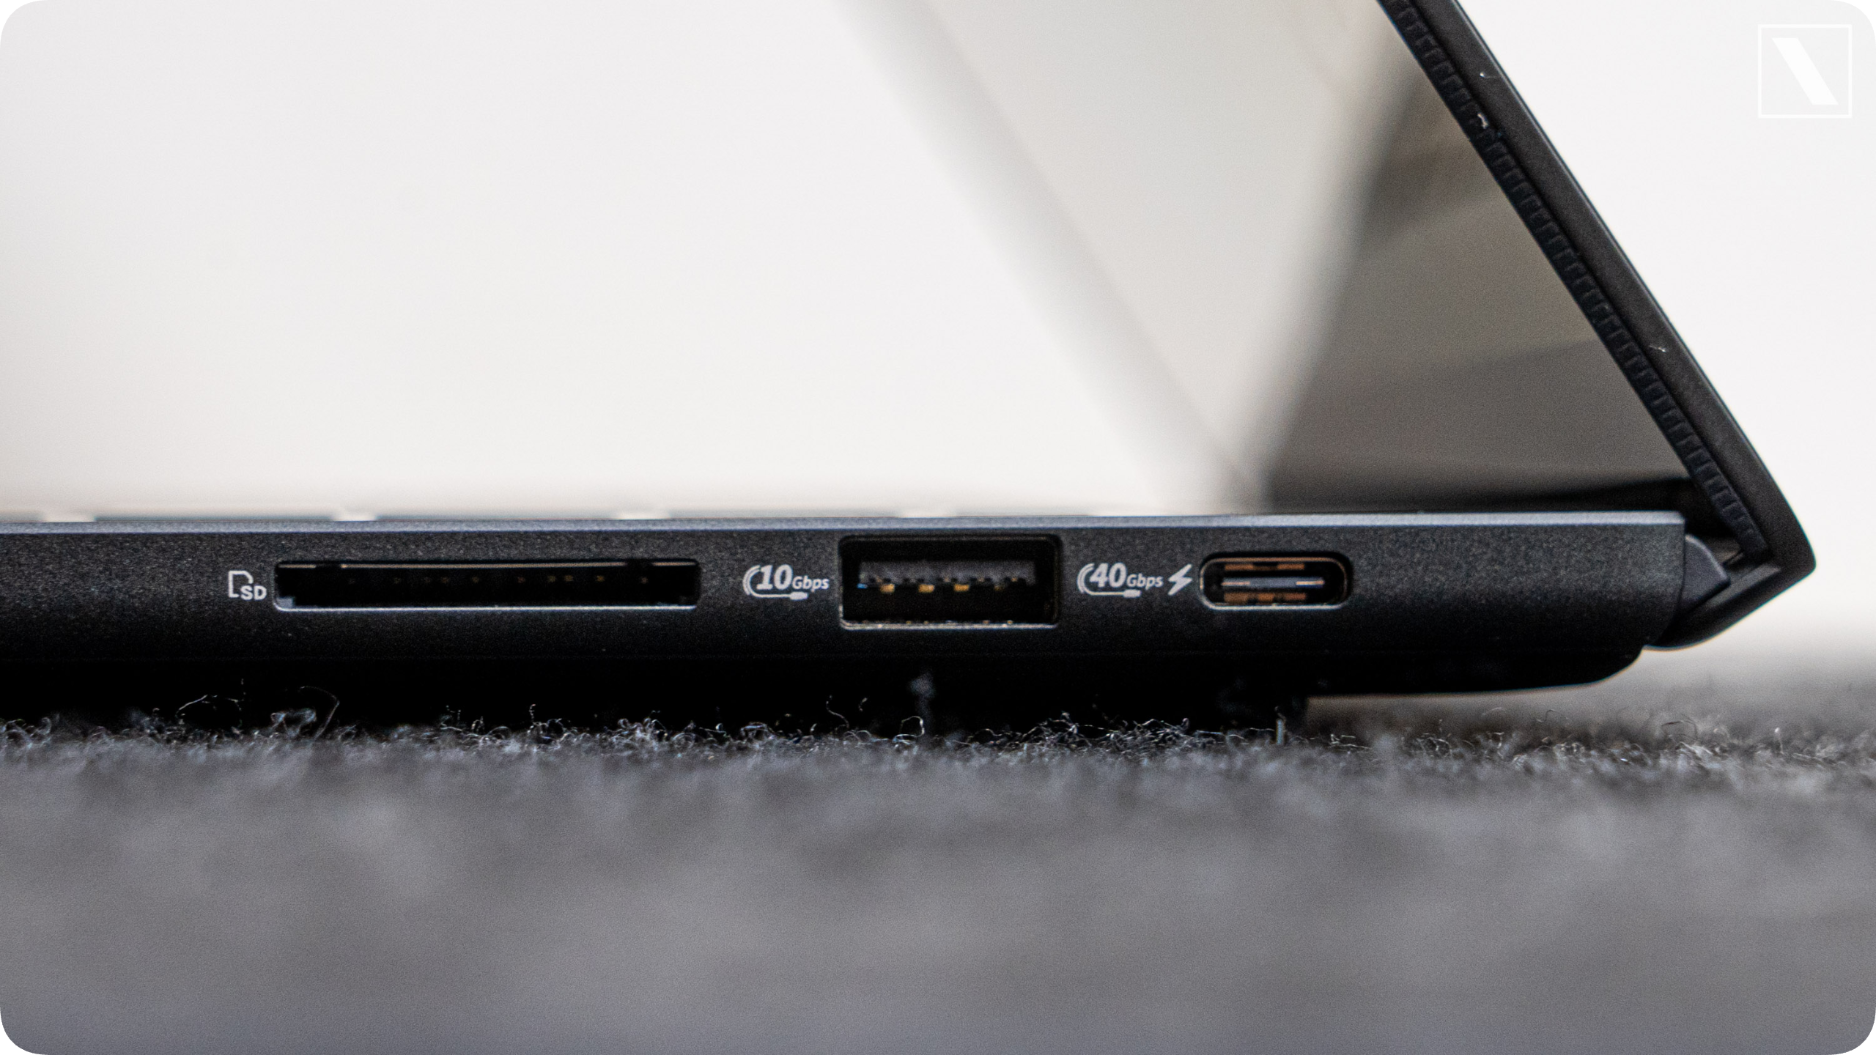
A maior importância dessas interfaces reside no fato de permitirem que o dispositivo funcione como uma estação de trabalho móvel: conectando-se a discos rígidos externos de alta velocidade, monitores 4K, cartões de memória de câmeras e diversos dispositivos criativos.
Quanta tarefa a IA consegue realizar com 64 GB de memória unificada?
Há alguns dias, em um evento especial da Microsoft, eles dividiram os PCs com Windows em mini desktops prontos para uso imediato, o Copilot+ PC com inteligência híbrida, IA local e na nuvem, e o Builder PC, que pode utilizar IA na nuvem e local para trabalhos criativos.
Este notebook ASUS ProArt 16 RTX Spark se enquadra na categoria de PCs para criadores, que são computadores pessoais voltados para profissionais da área criativa. Atualmente, os trabalhos criativos mais populares utilizam inteligência artificial (IA), como desenvolvimento de jogos, modelagem 3D e aplicativos web simples, todos os quais requerem o envolvimento de IA.
Para o ASUS ProArt 16 RTX Spark, uma forma de introduzir IA é através da implementação local, pois esta é a única maneira de utilizar plenamente as capacidades do NVIDIA RTX Spark.
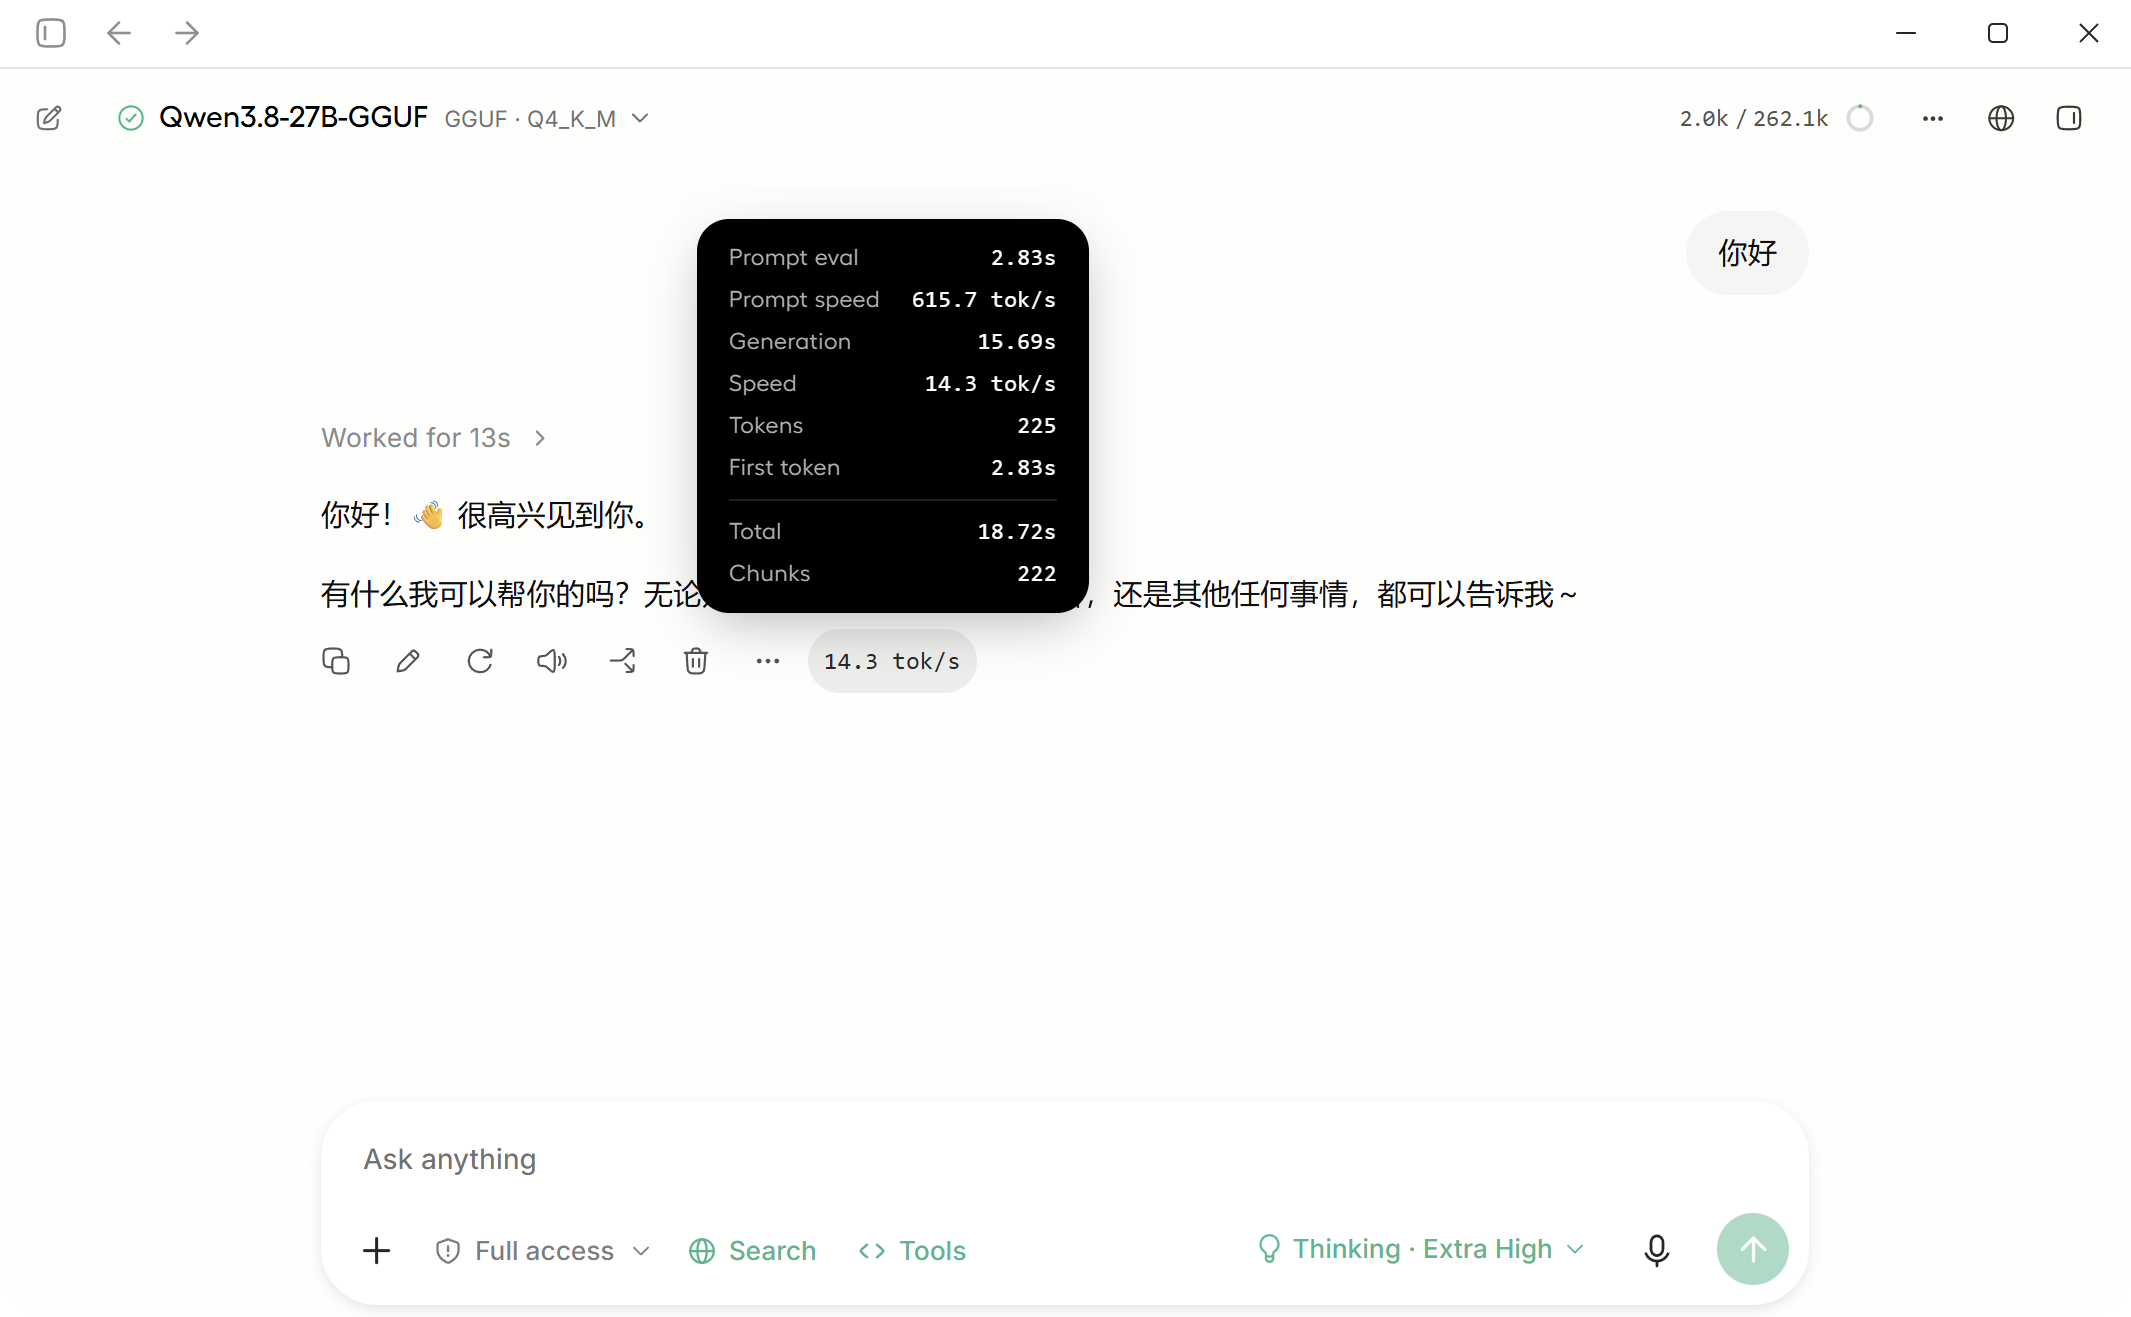
Baixamos o LM Studio e instalamos o modelo Qwen 3.8 27B. Com a profundidade de pensamento definida como "Muito Alta", o laptop levou um total de 18 segundos para concluir a mensagem de entrada "Olá". A velocidade de resposta do modelo para leitura e processamento de entrada foi de 615,7 tokens/s, a velocidade de geração de tokens foi de 14,3 tokens/s e o tempo para gerar o primeiro token foi de 2,83 segundos.
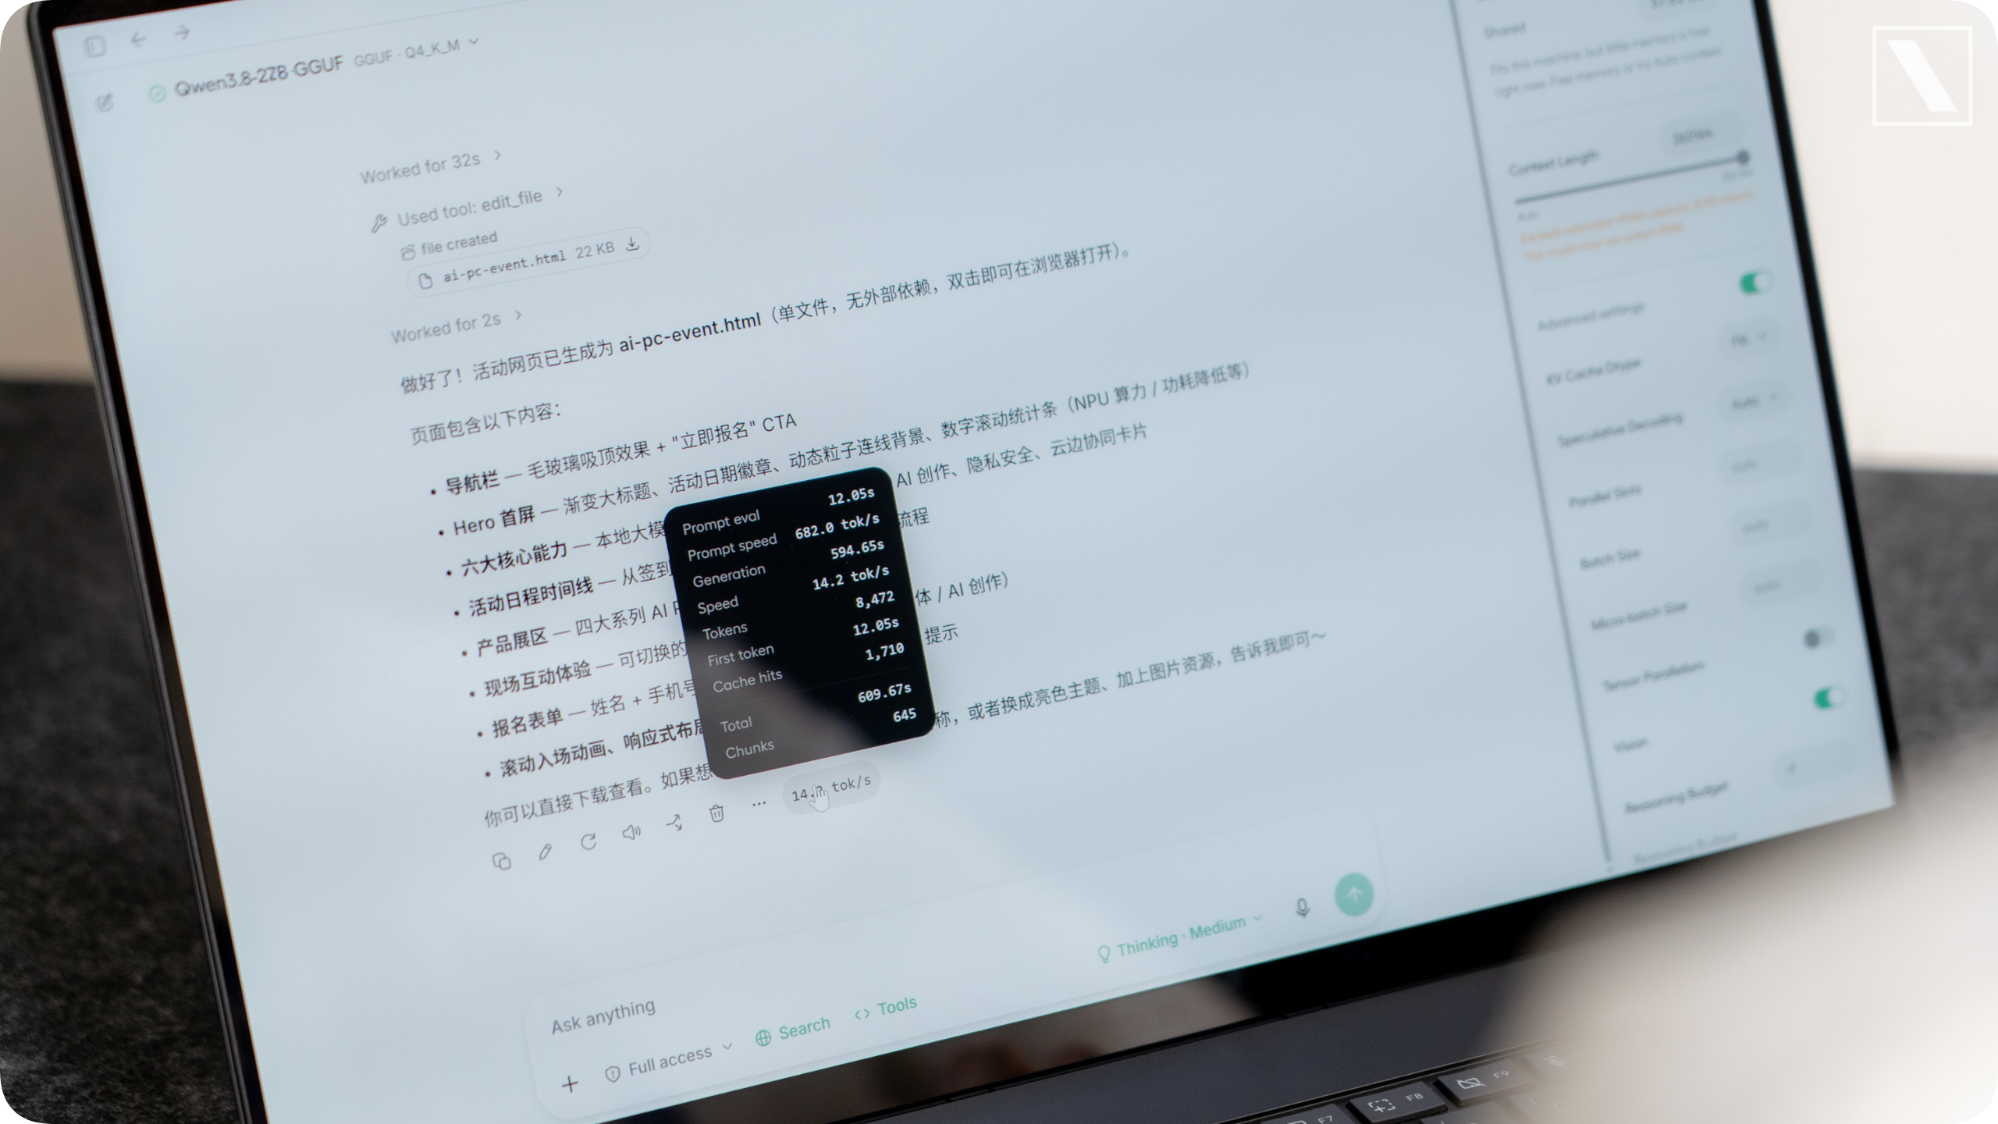
Quando tentamos pedir que ele execute alguns projetos web, como o design de uma página web para um evento de computadores com inteligência artificial.
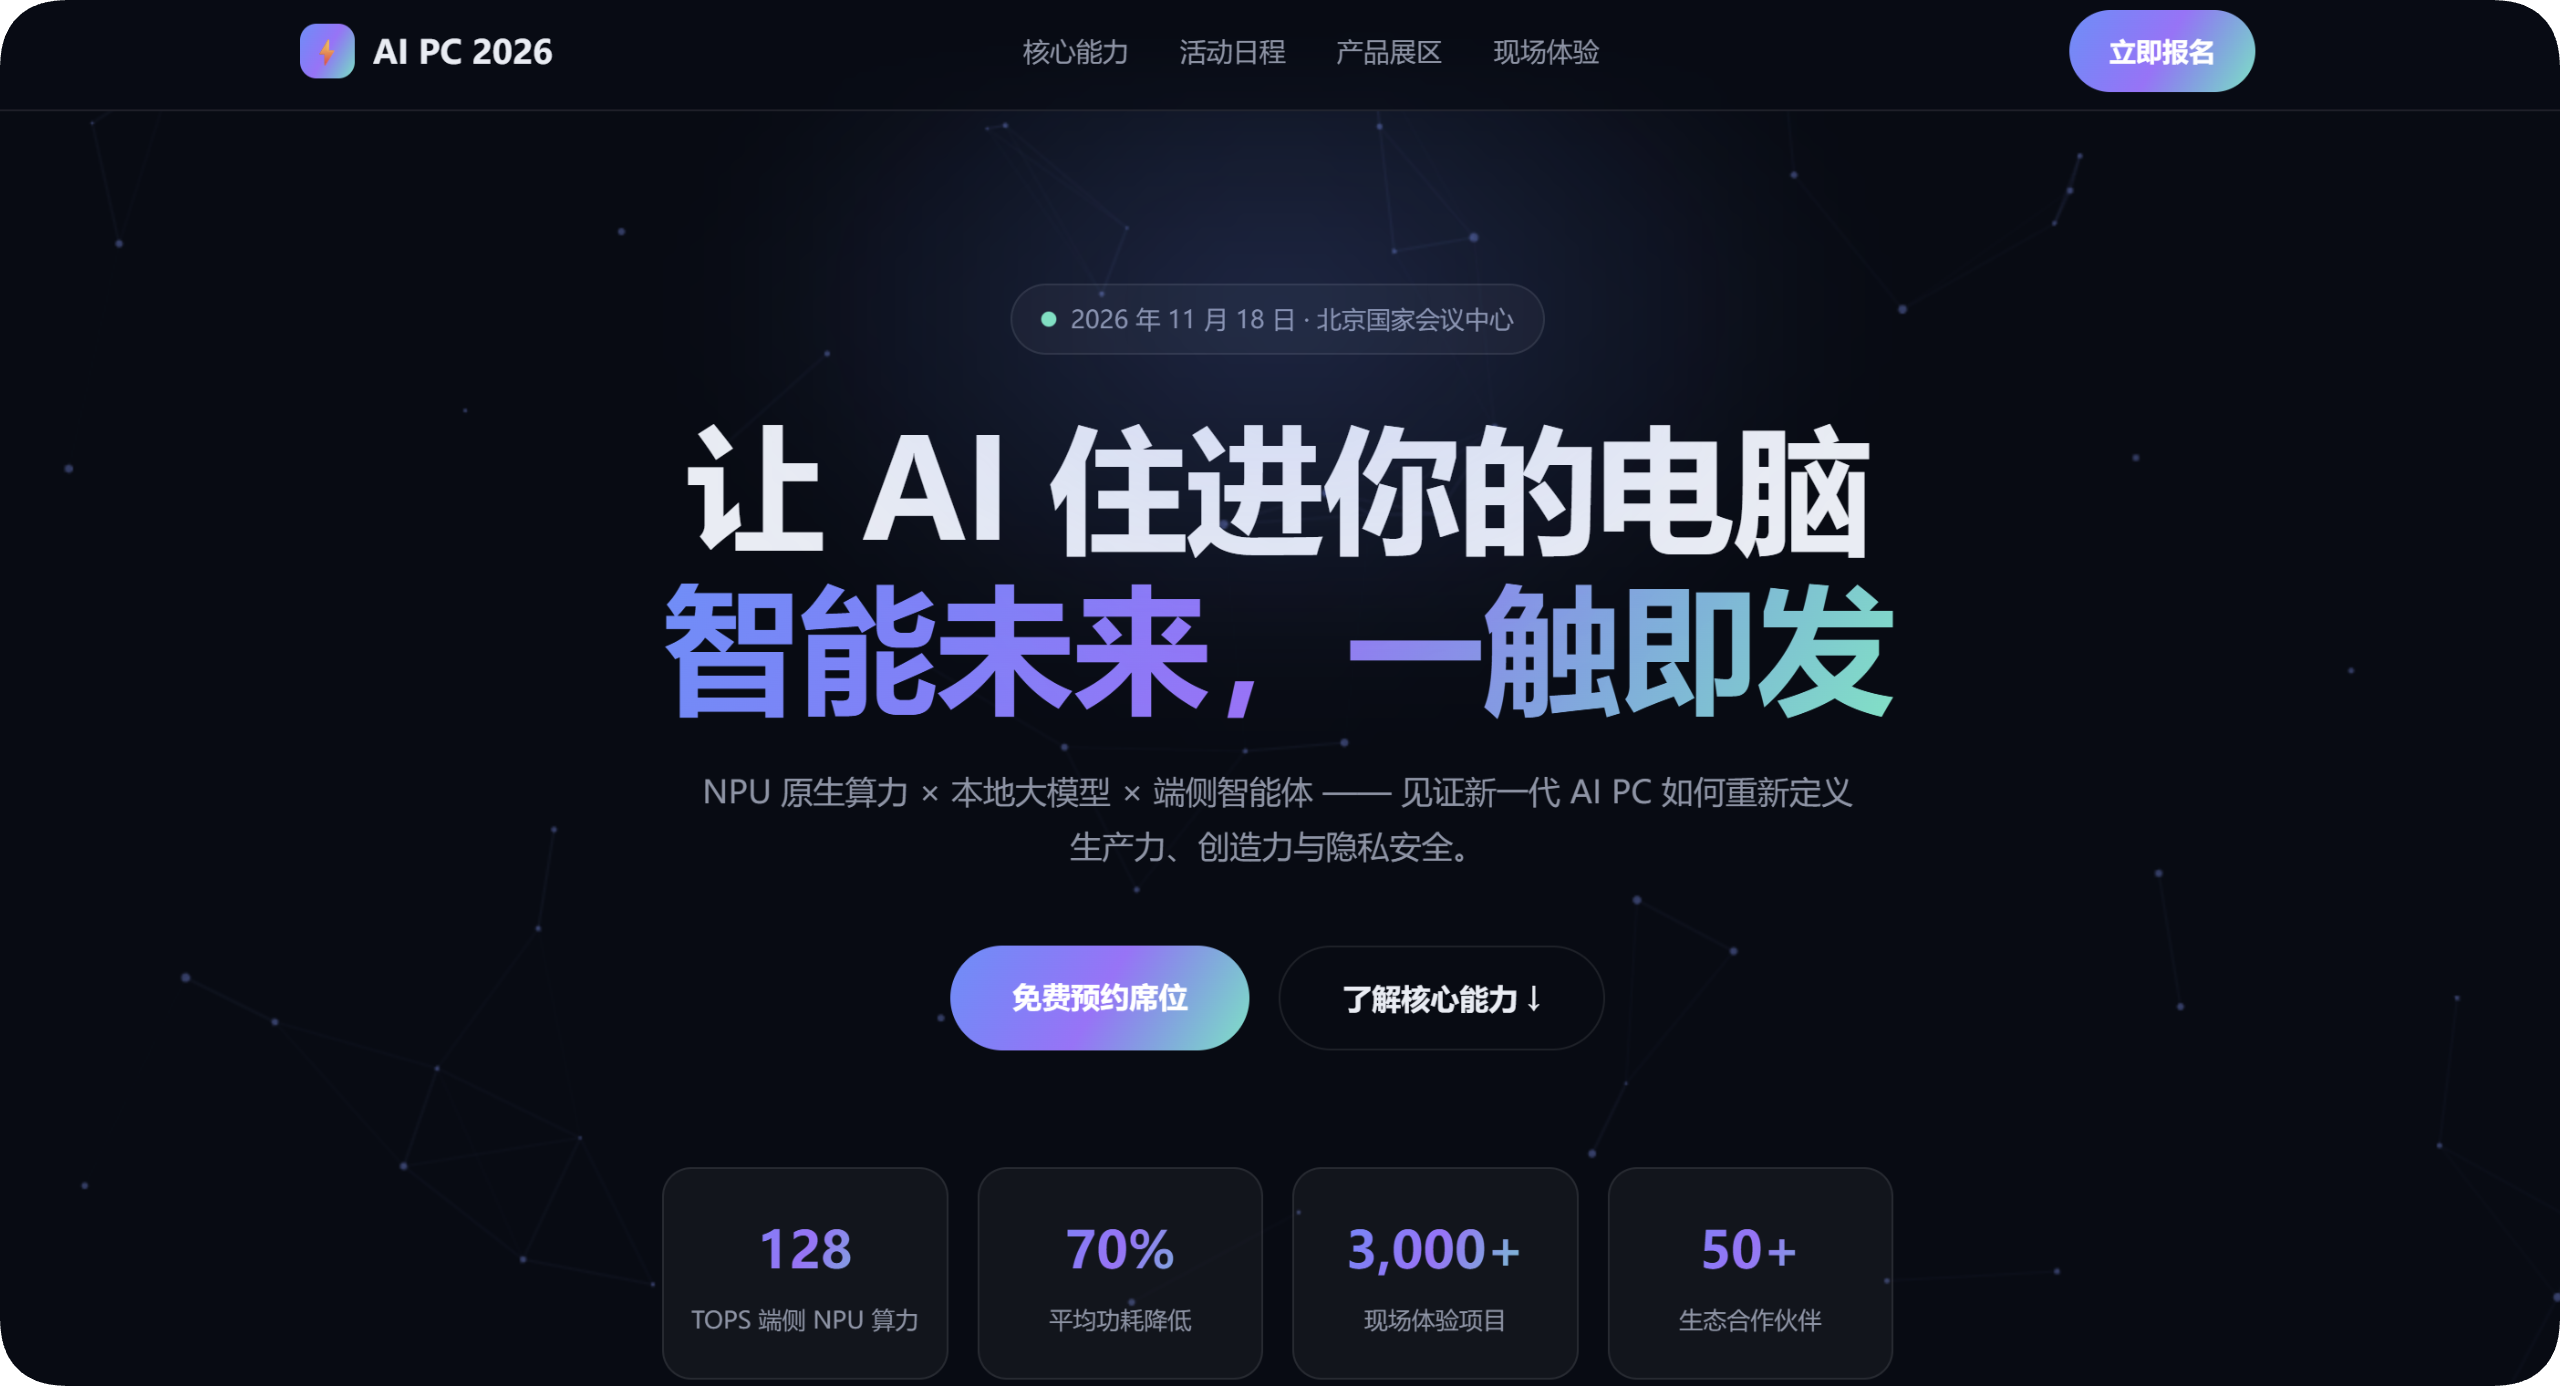
Como você pode ver, a velocidade de geração de tokens permanece estável em torno de 14 tokens/s, com o primeiro token levando 12,05 segundos e o tempo total sendo de 609,67 segundos.
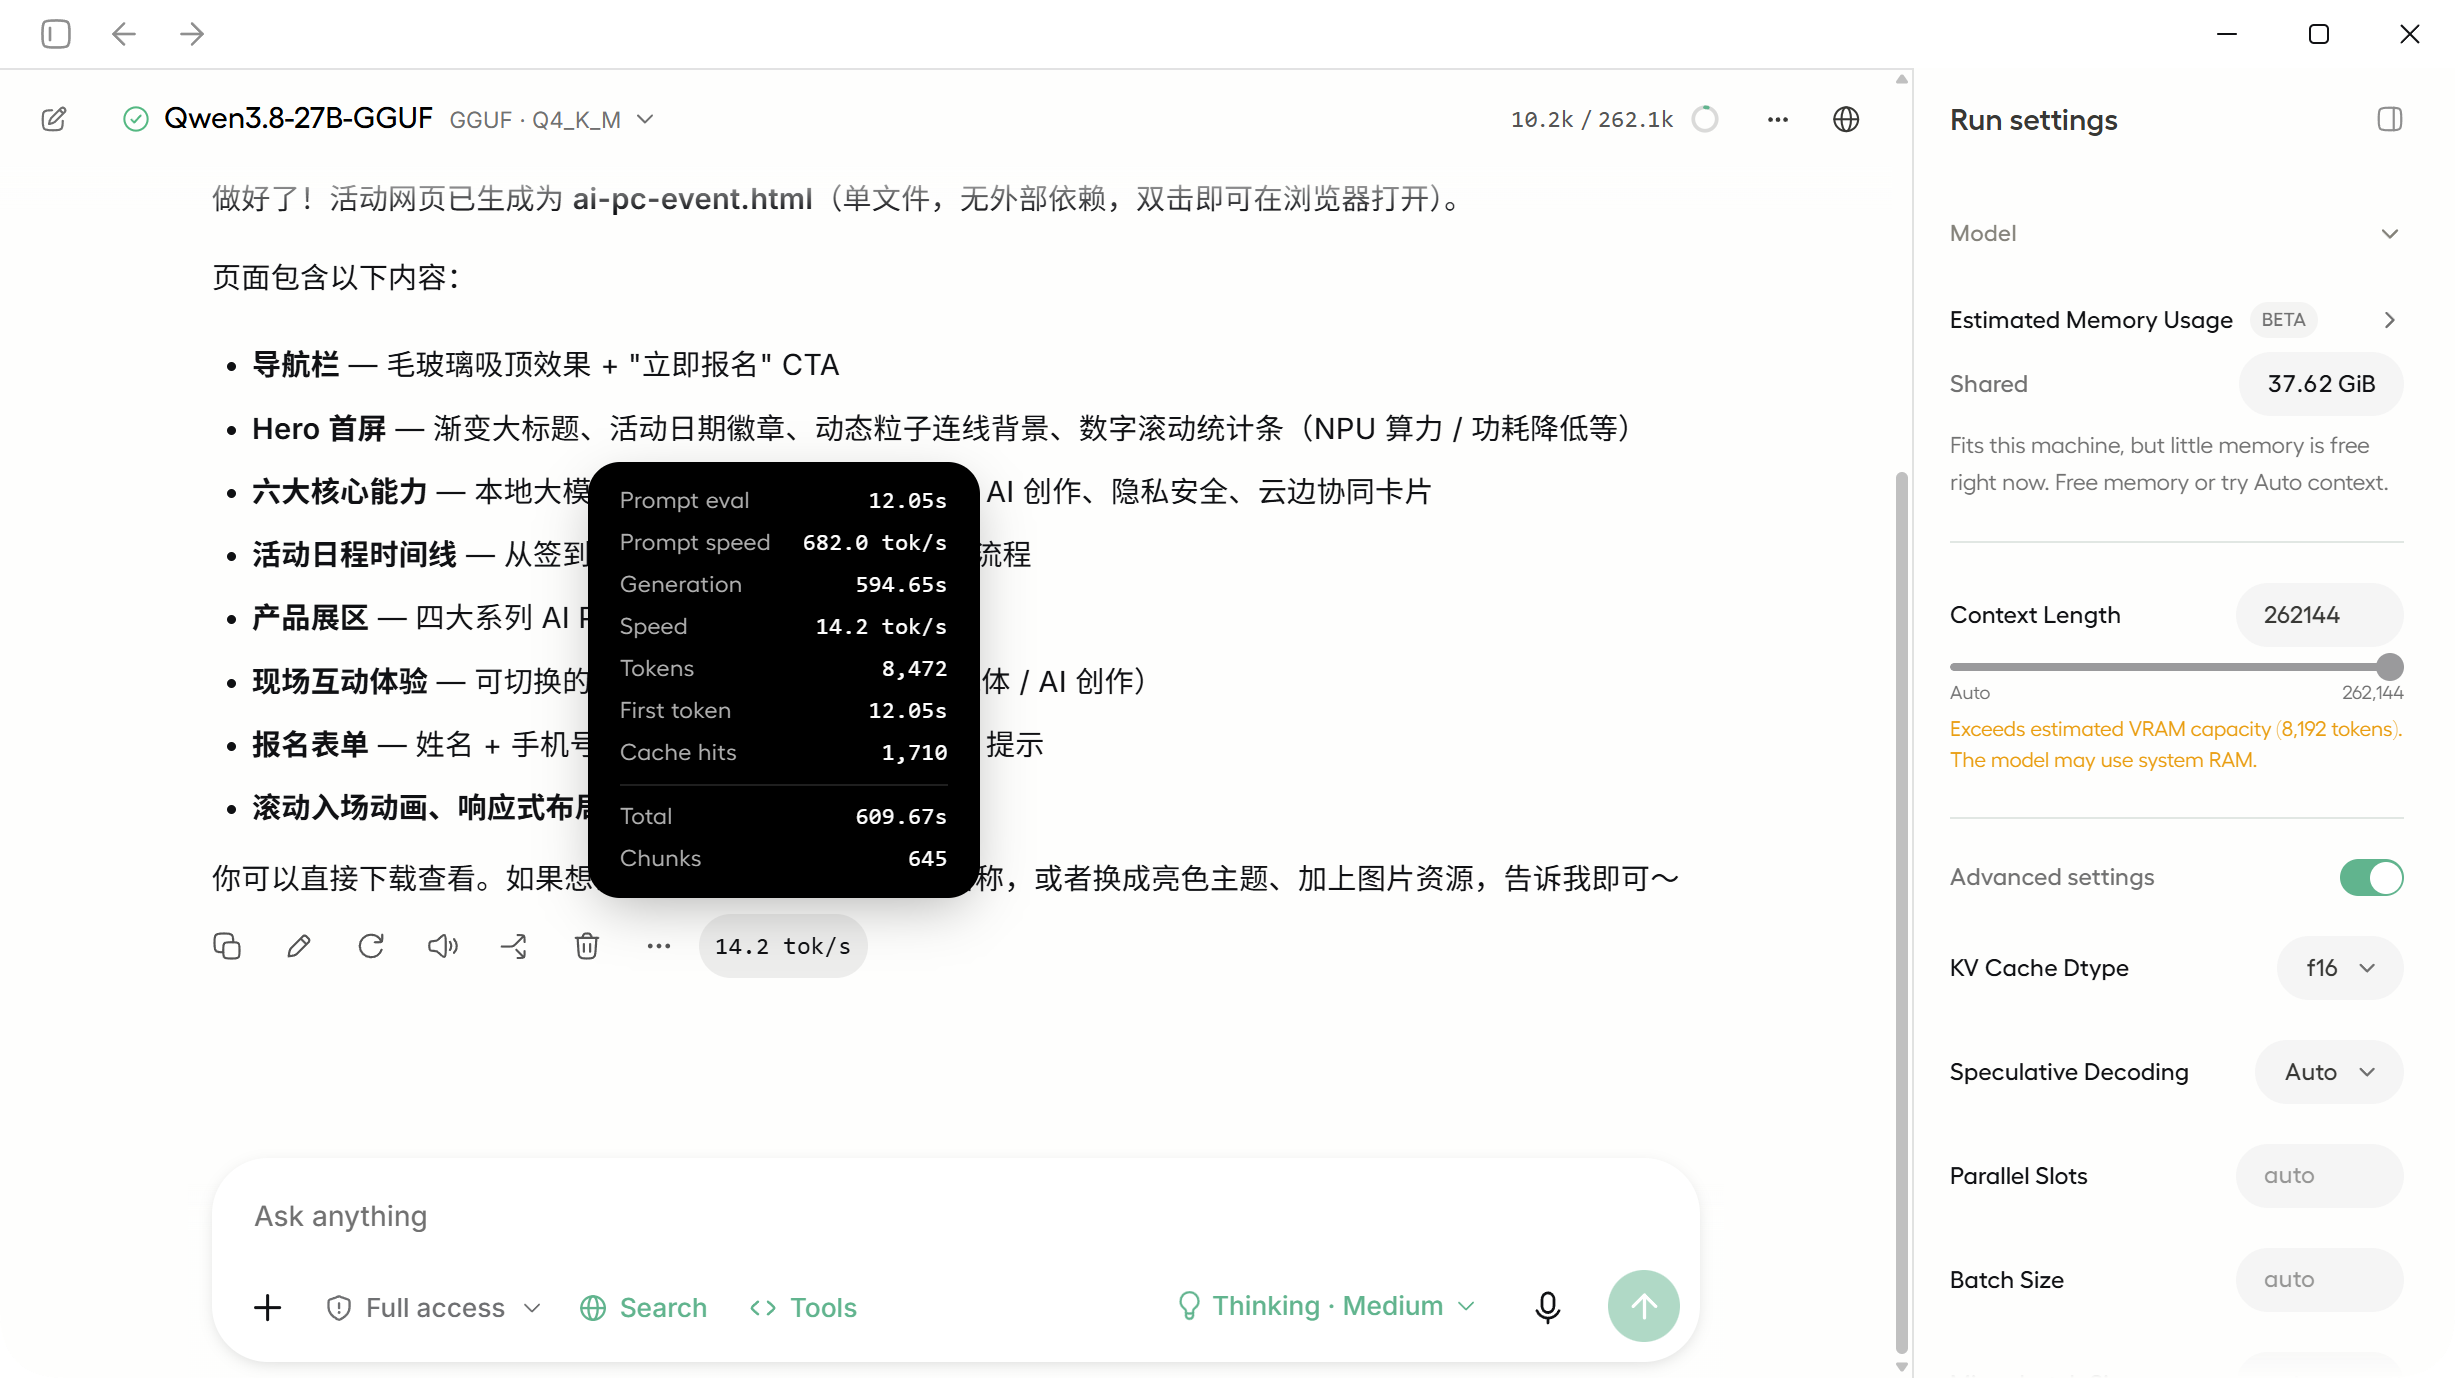
Para uma configuração uniforme de 64 GB de memória, um modelo com cerca de 30 GB provavelmente representa o nível ideal para esse tipo de computador.
O Qwen3 32B (NVFP4) possui uma velocidade de inferência de cerca de 55 a 60 tokens por segundo, tornando as conversas do dia a dia, a redação publicitária e a assistência de código completamente fluidas; ao inserir documentos longos para sumarização, não há perda significativa de desempenho no contexto de centenas de milhares de tokens.
WorkBuddy, minha inteligência se reflete em 0 yuans/mês.
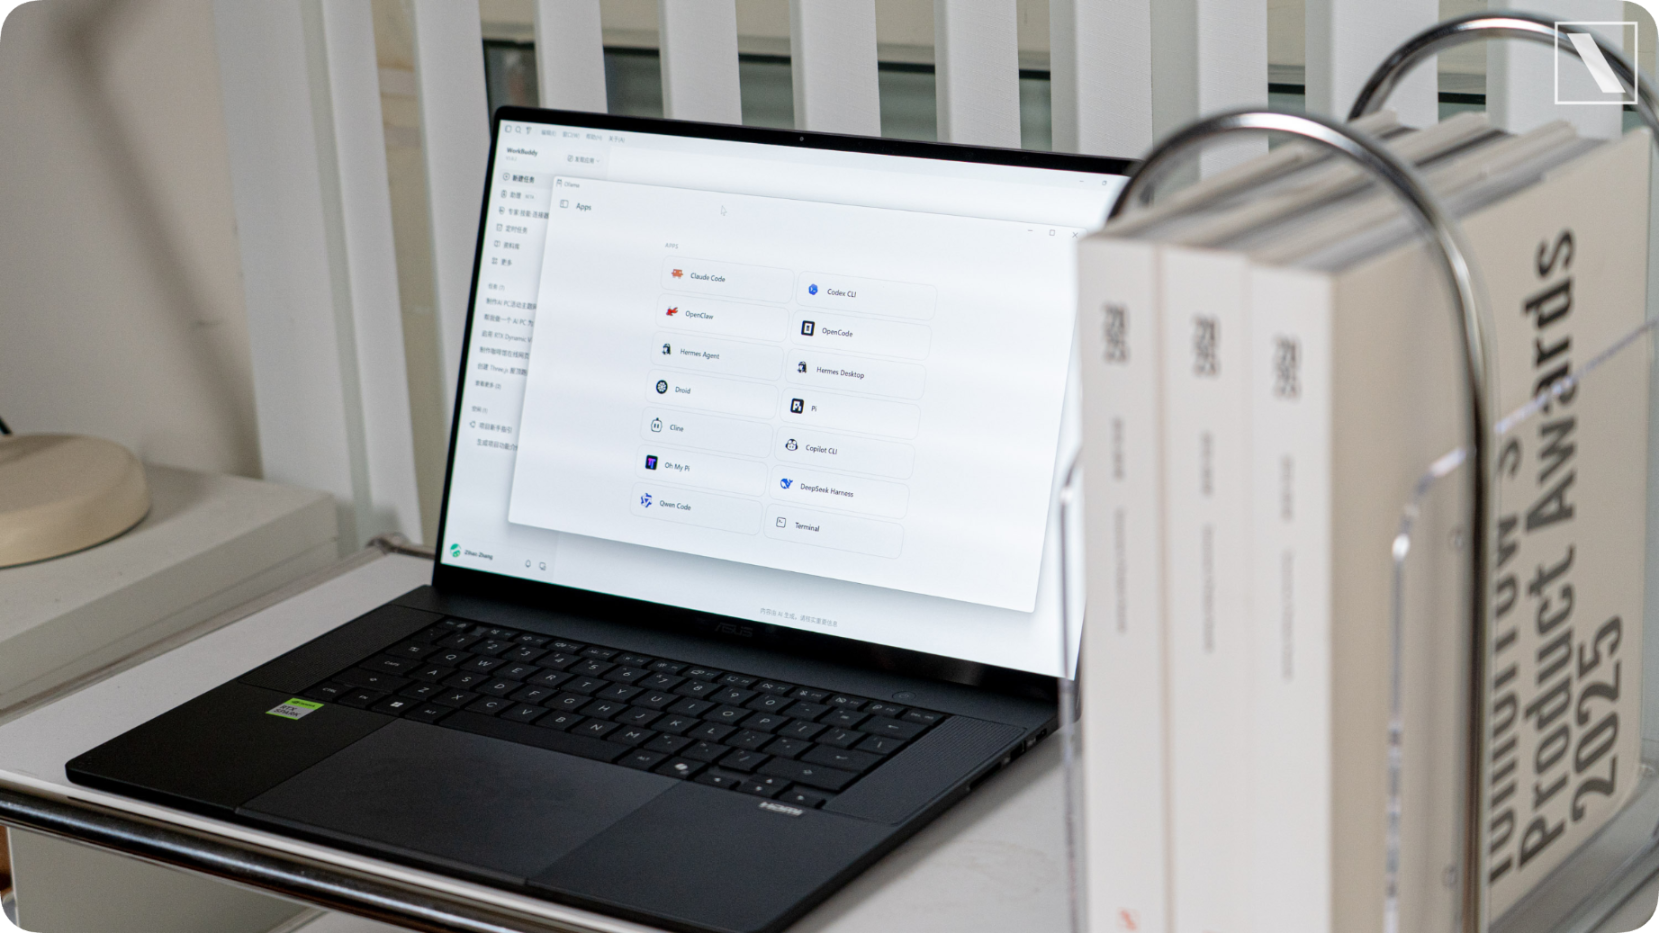
Além da sua capacidade de implantação local independente, o aspecto mais interessante deste PC com Windows é a sua integração com o WorkBuddy.
Ao abrir o WorkBuddy no meu MacBook Air, vejo que nas configurações do modelo só existe a opção "Modelo Personalizado".
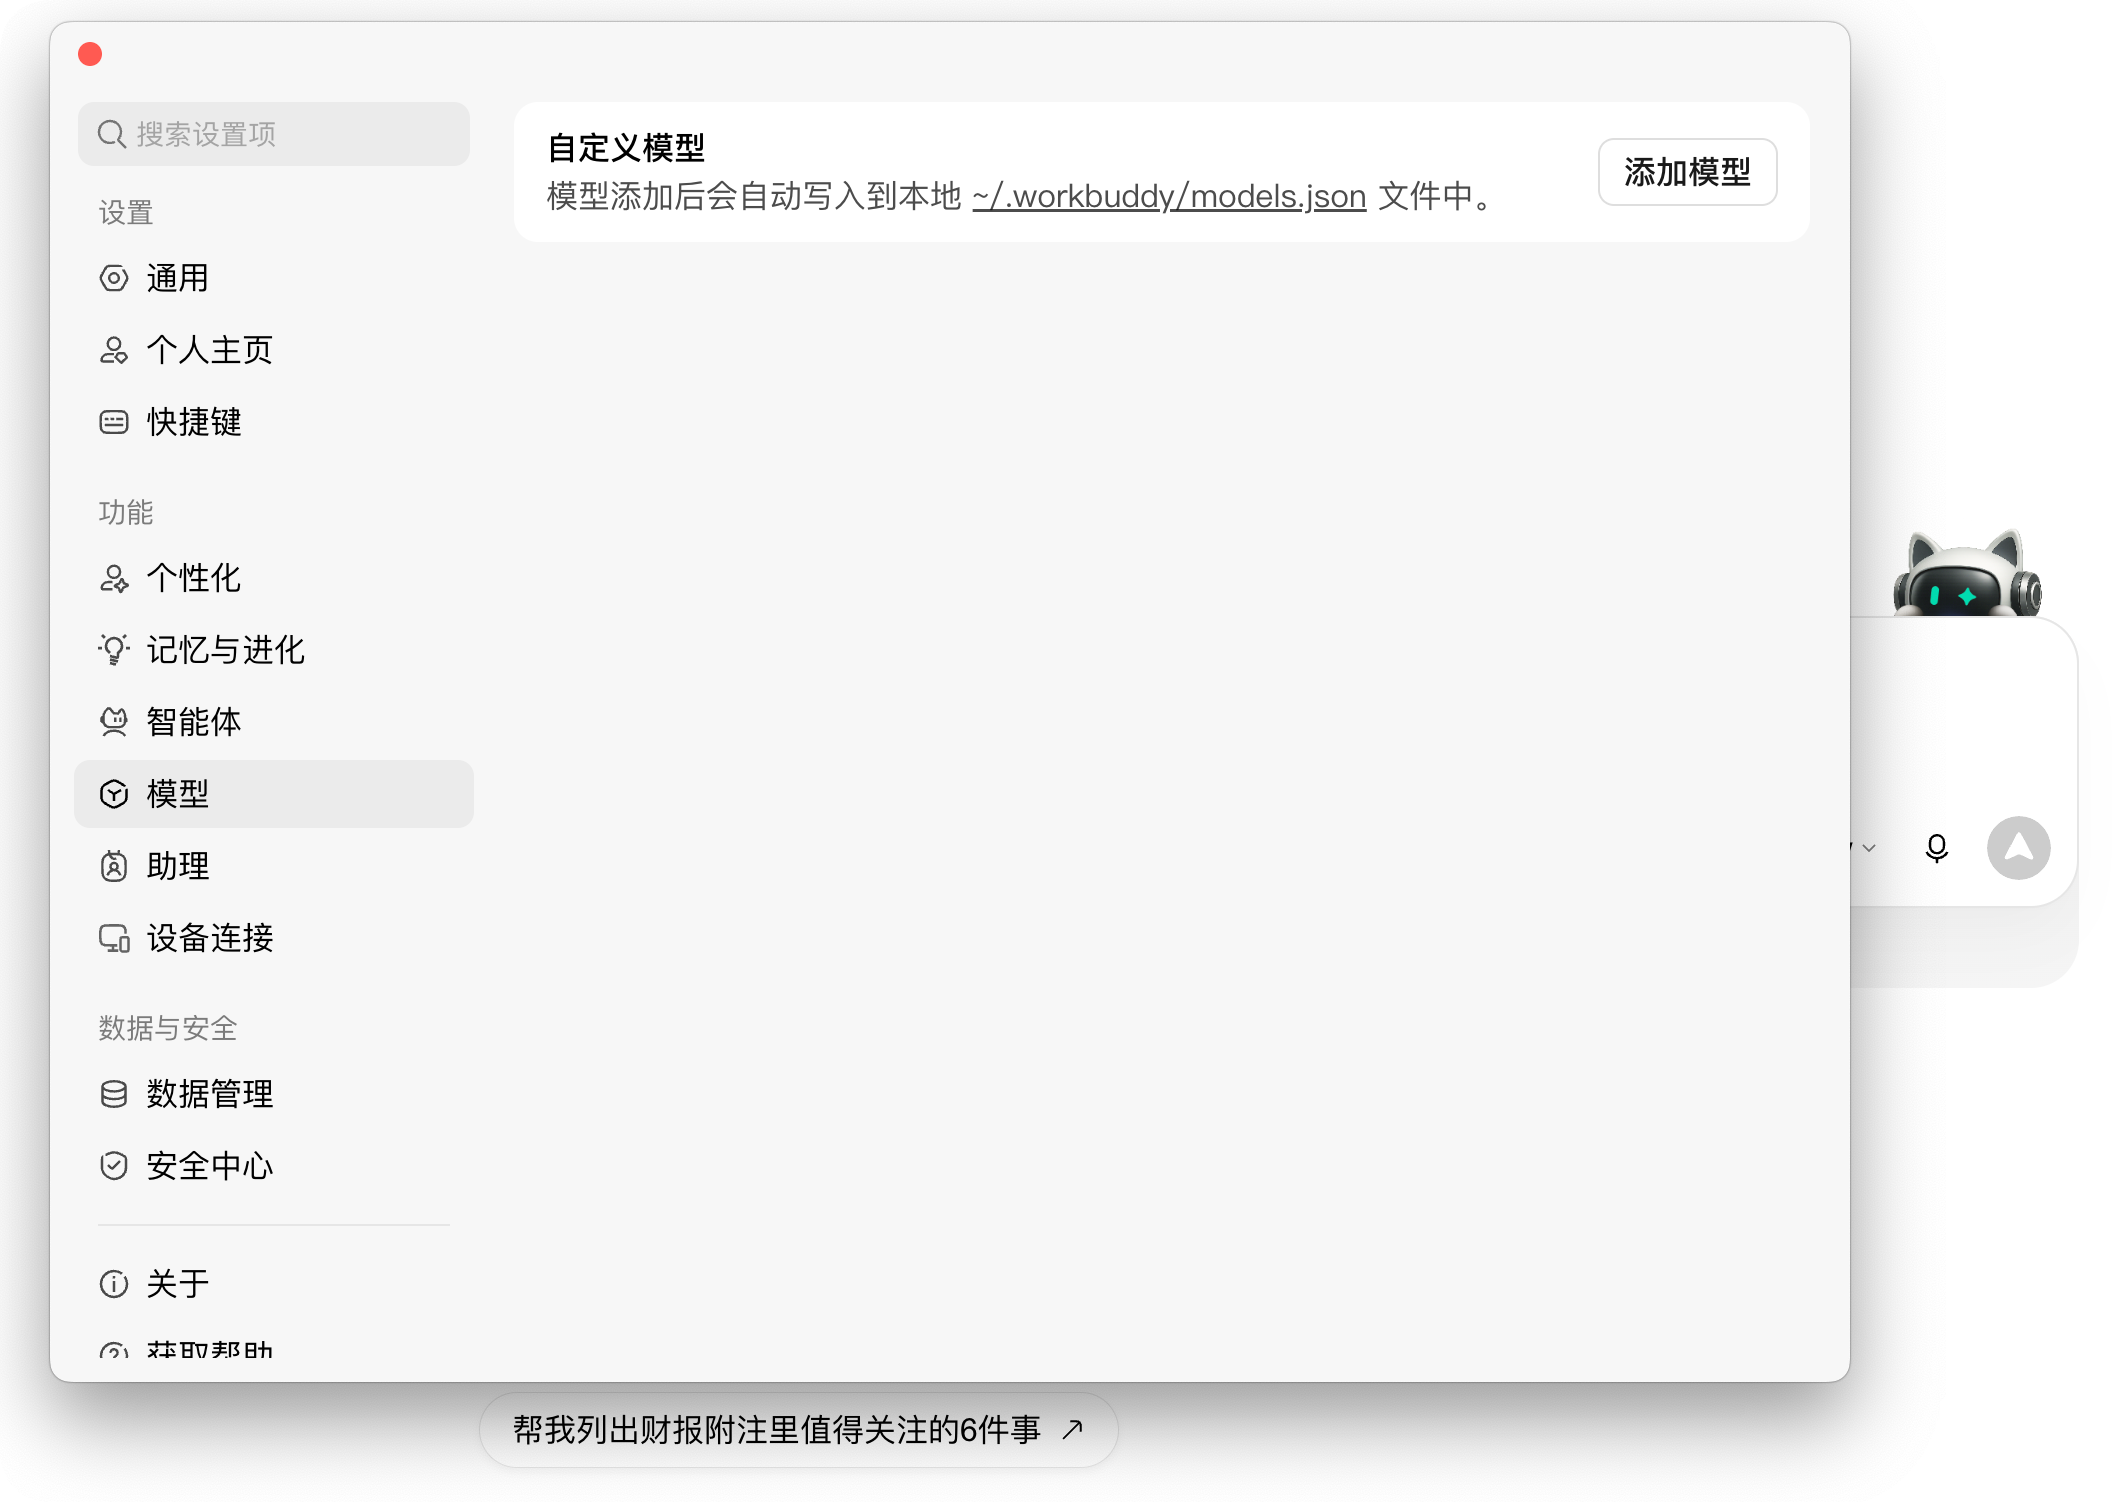
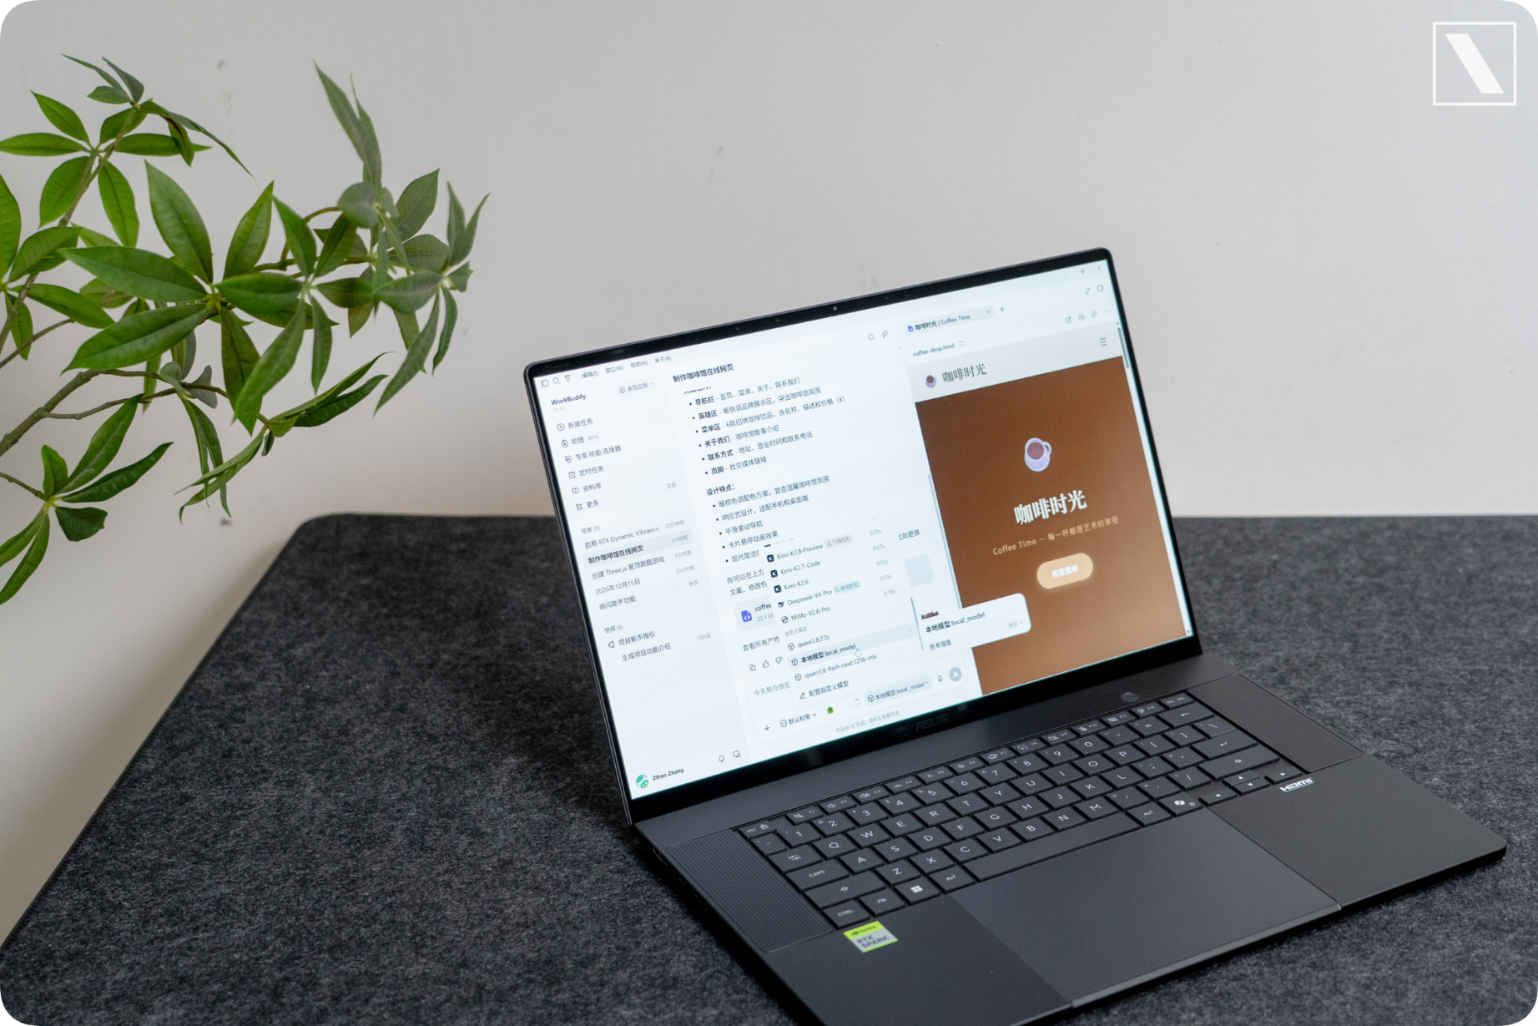
Neste ASUS ProArt 16 RTX Spark, existe um recurso Beta adicional que nos permite baixar e gerenciar diretamente modelos de IA em execução localmente.
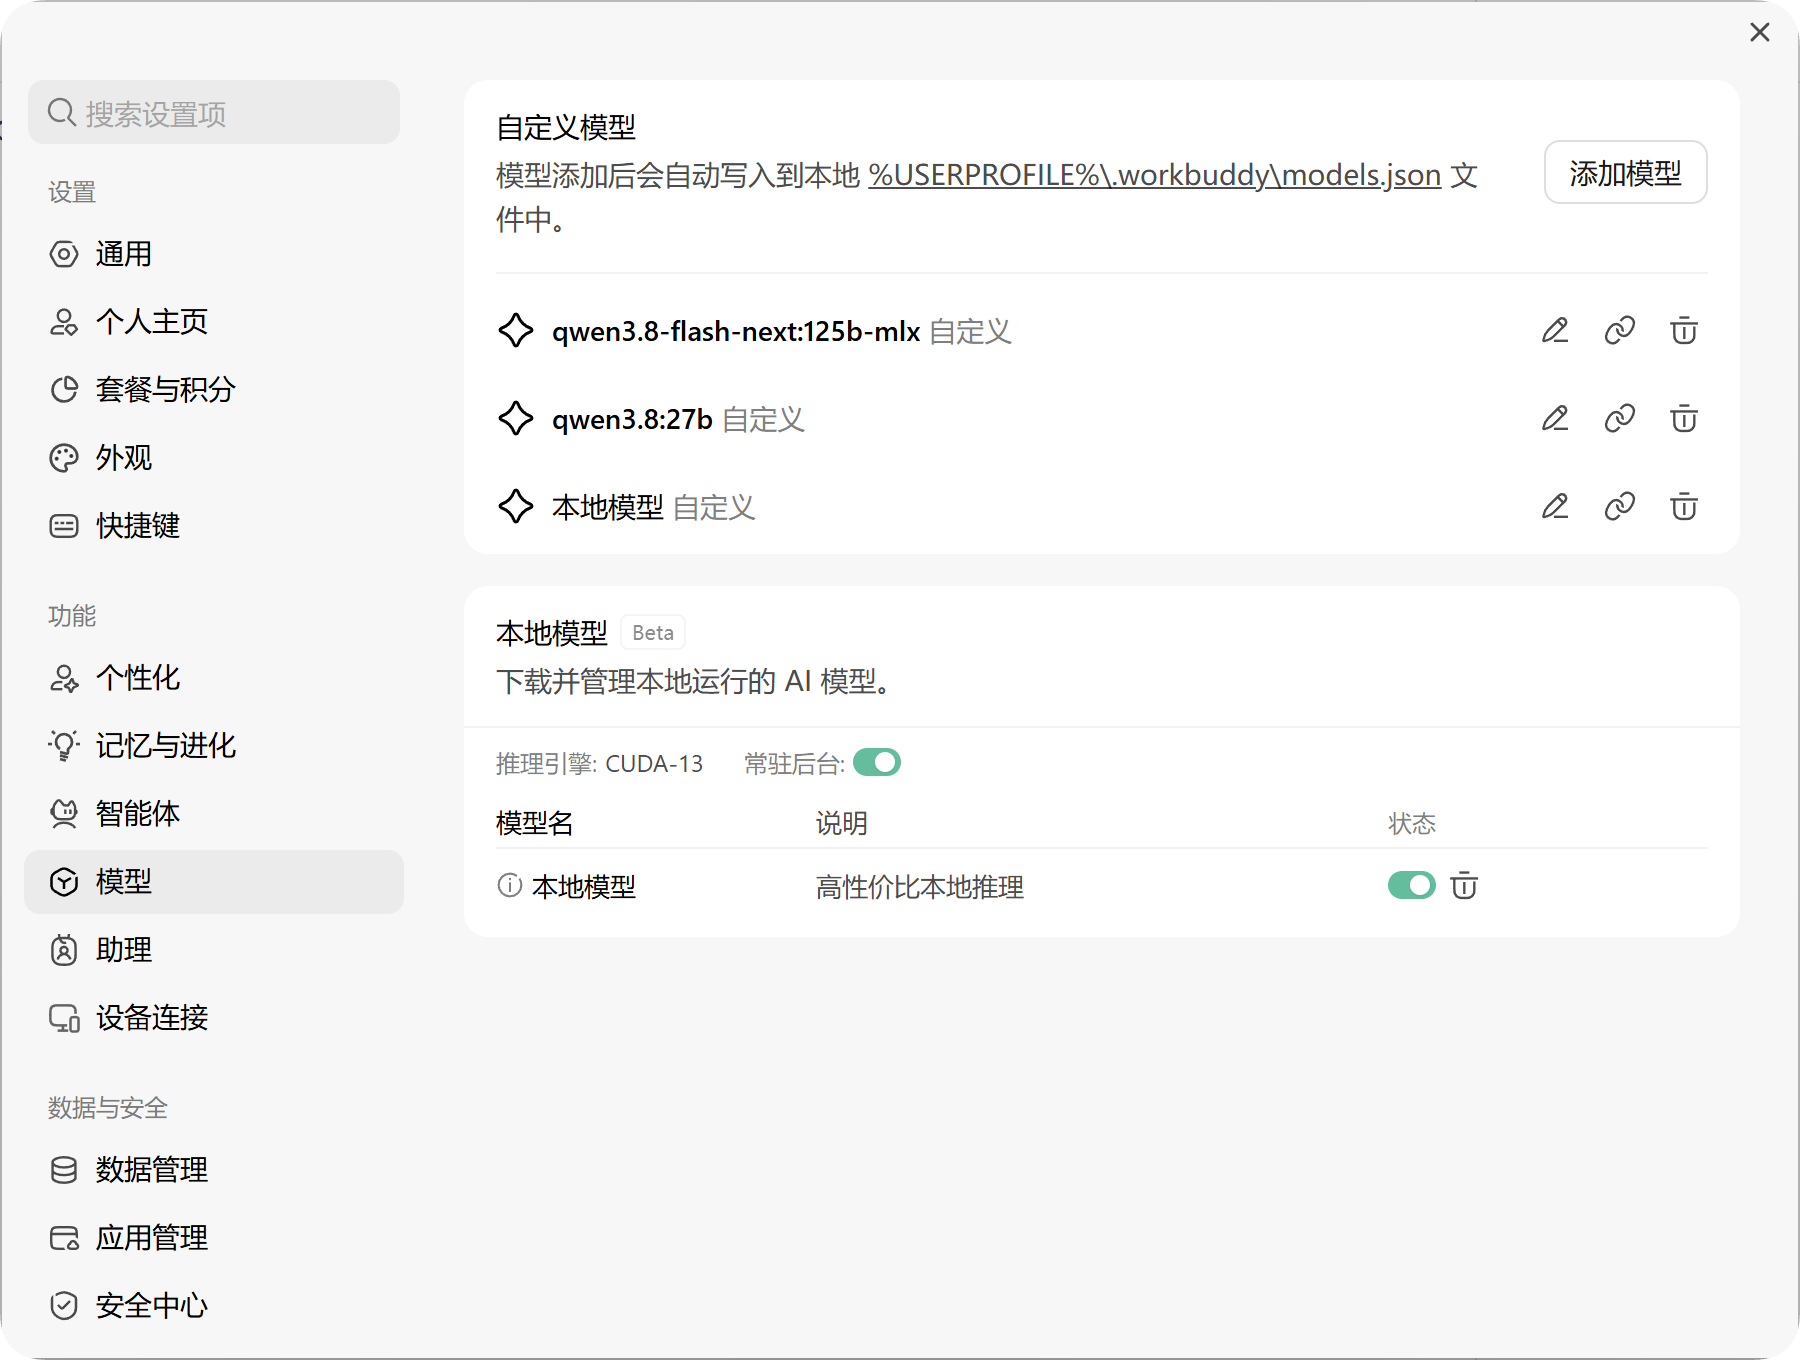
Após clicar em "Download", o computador iniciará automaticamente o download do modelo e resolverá as regras de implantação locais correspondentes. Basta habilitá-lo e mantê-lo em execução em segundo plano. Em seguida, podemos retornar à interface de tarefas do WorkBuddy e selecionar o modelo local para iniciar uma conversa.
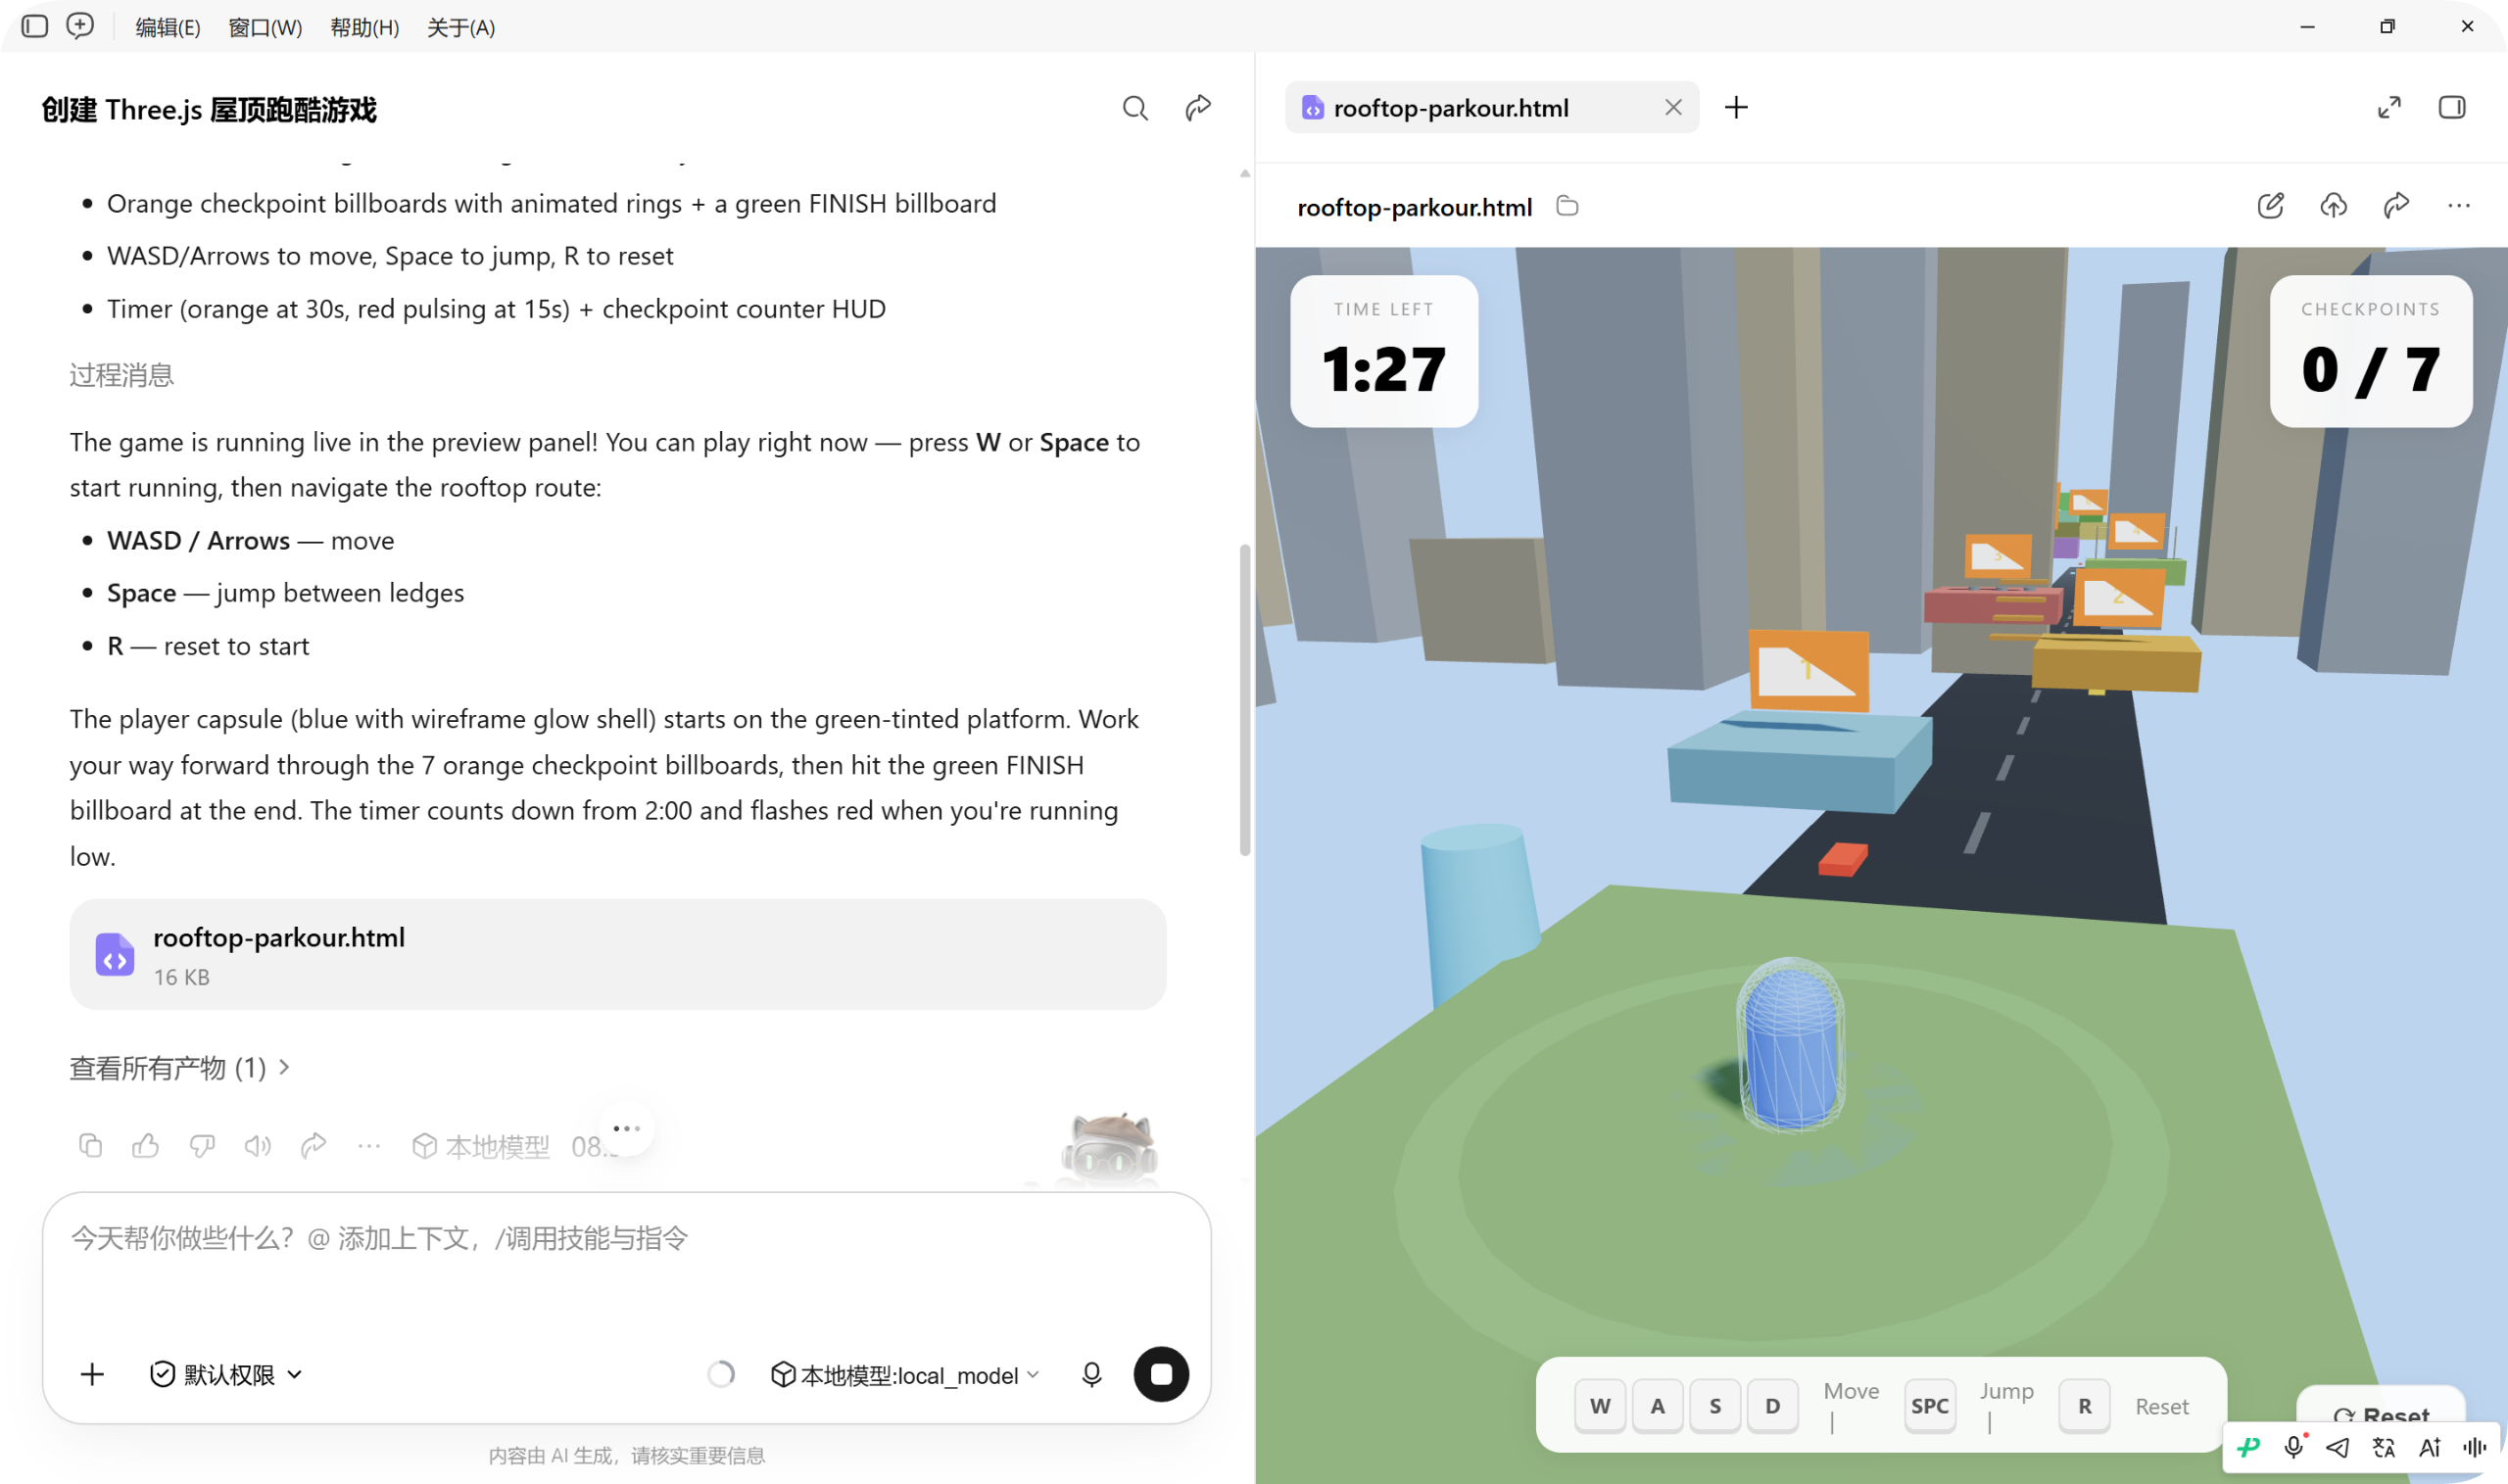
O jogo de telhado em Three.js mencionado anteriormente agora pode ser implementado usando o WorkBuddy. Embora o efeito possa não ser tão impressionante quanto os modelos mais modernos disponíveis, ainda vale a pena experimentar para validação preliminar do projeto e testes de viabilidade.
Toda a tarefa levou 13 minutos e 59 segundos, o que provavelmente é ainda menos do que usar o modelo em nuvem do WorkBuddy.
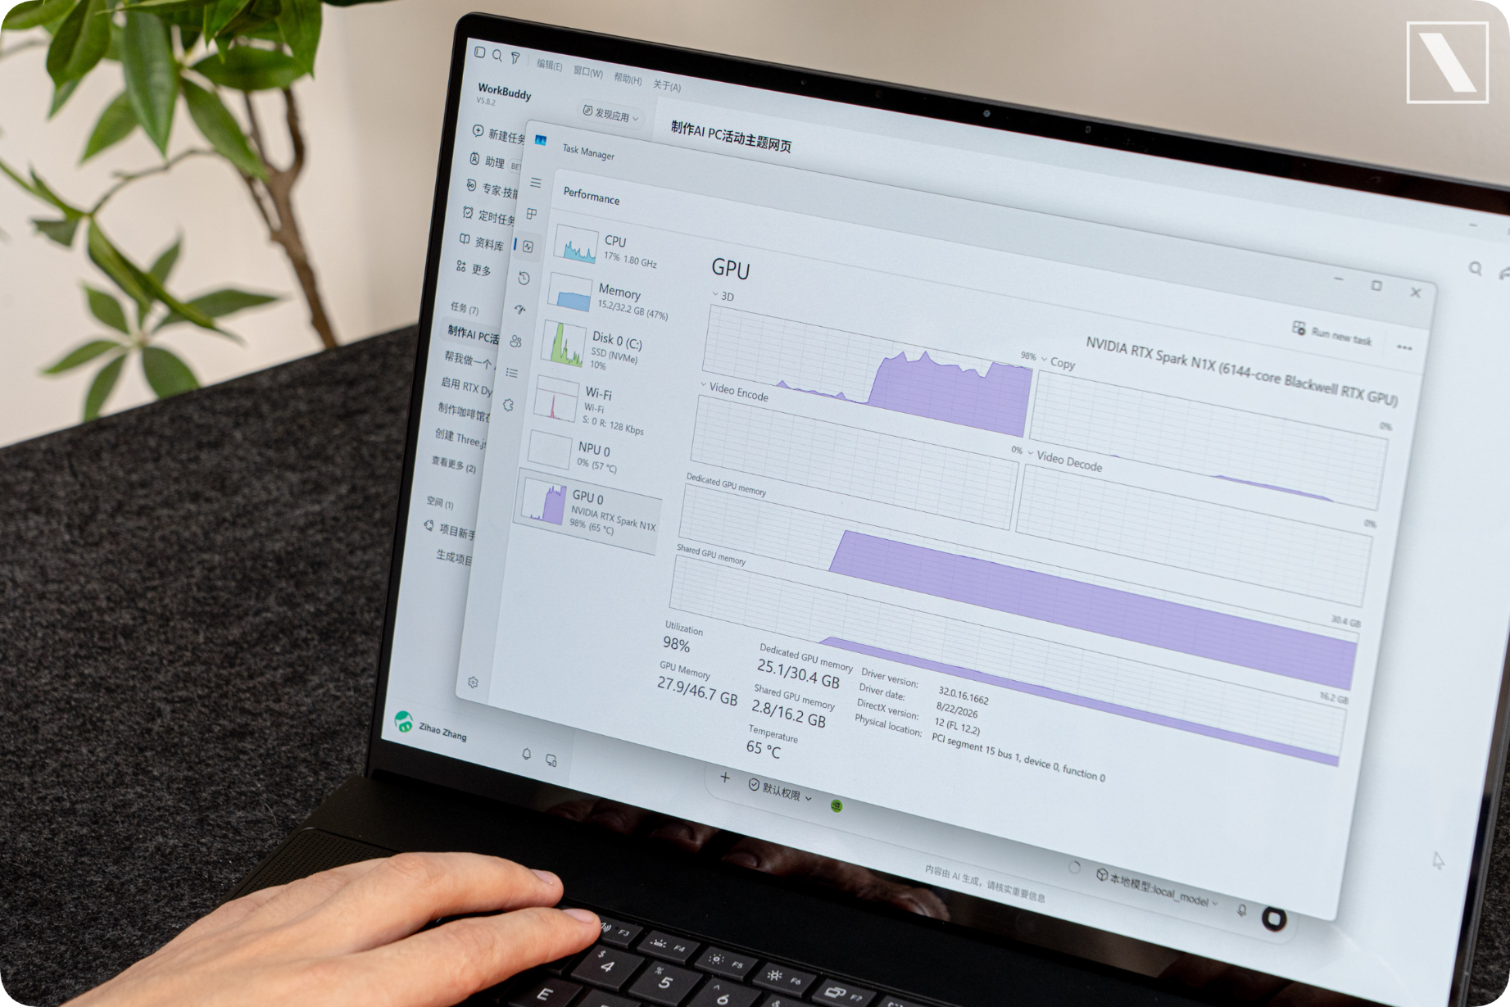
Você também pode ver no Gerenciador de Tarefas, na seção Desempenho, que o uso da GPU começou a subir para 100% e o ruído da ventoinha também está bastante perceptível.
Embora o WorkBuddy não nos diga diretamente de qual fabricante provém este modelo local, um simples bate-papo com ele revela as informações relevantes no cabeçalho do arquivo do modelo.
Este modelo é um modelo local otimizado pela Tencent, um modelo MoE com 50 bilhões de parâmetros, um tamanho de modelo de 16 GB e acelerado usando CUDA 13, o que permite obter uma velocidade de inferência mais suave na GPU.
Com base nas capacidades do modelo local otimizado da Tencent, também podemos encontrar tarefas mais adequadas para esse modelo. Combinado com os recursos do pacote Harness do WorkBuddy, ele terá um bom desempenho em algumas tarefas simples do dia a dia, como análise de dados, visualização de dados, resumo de relatórios e outras tarefas repetitivas.
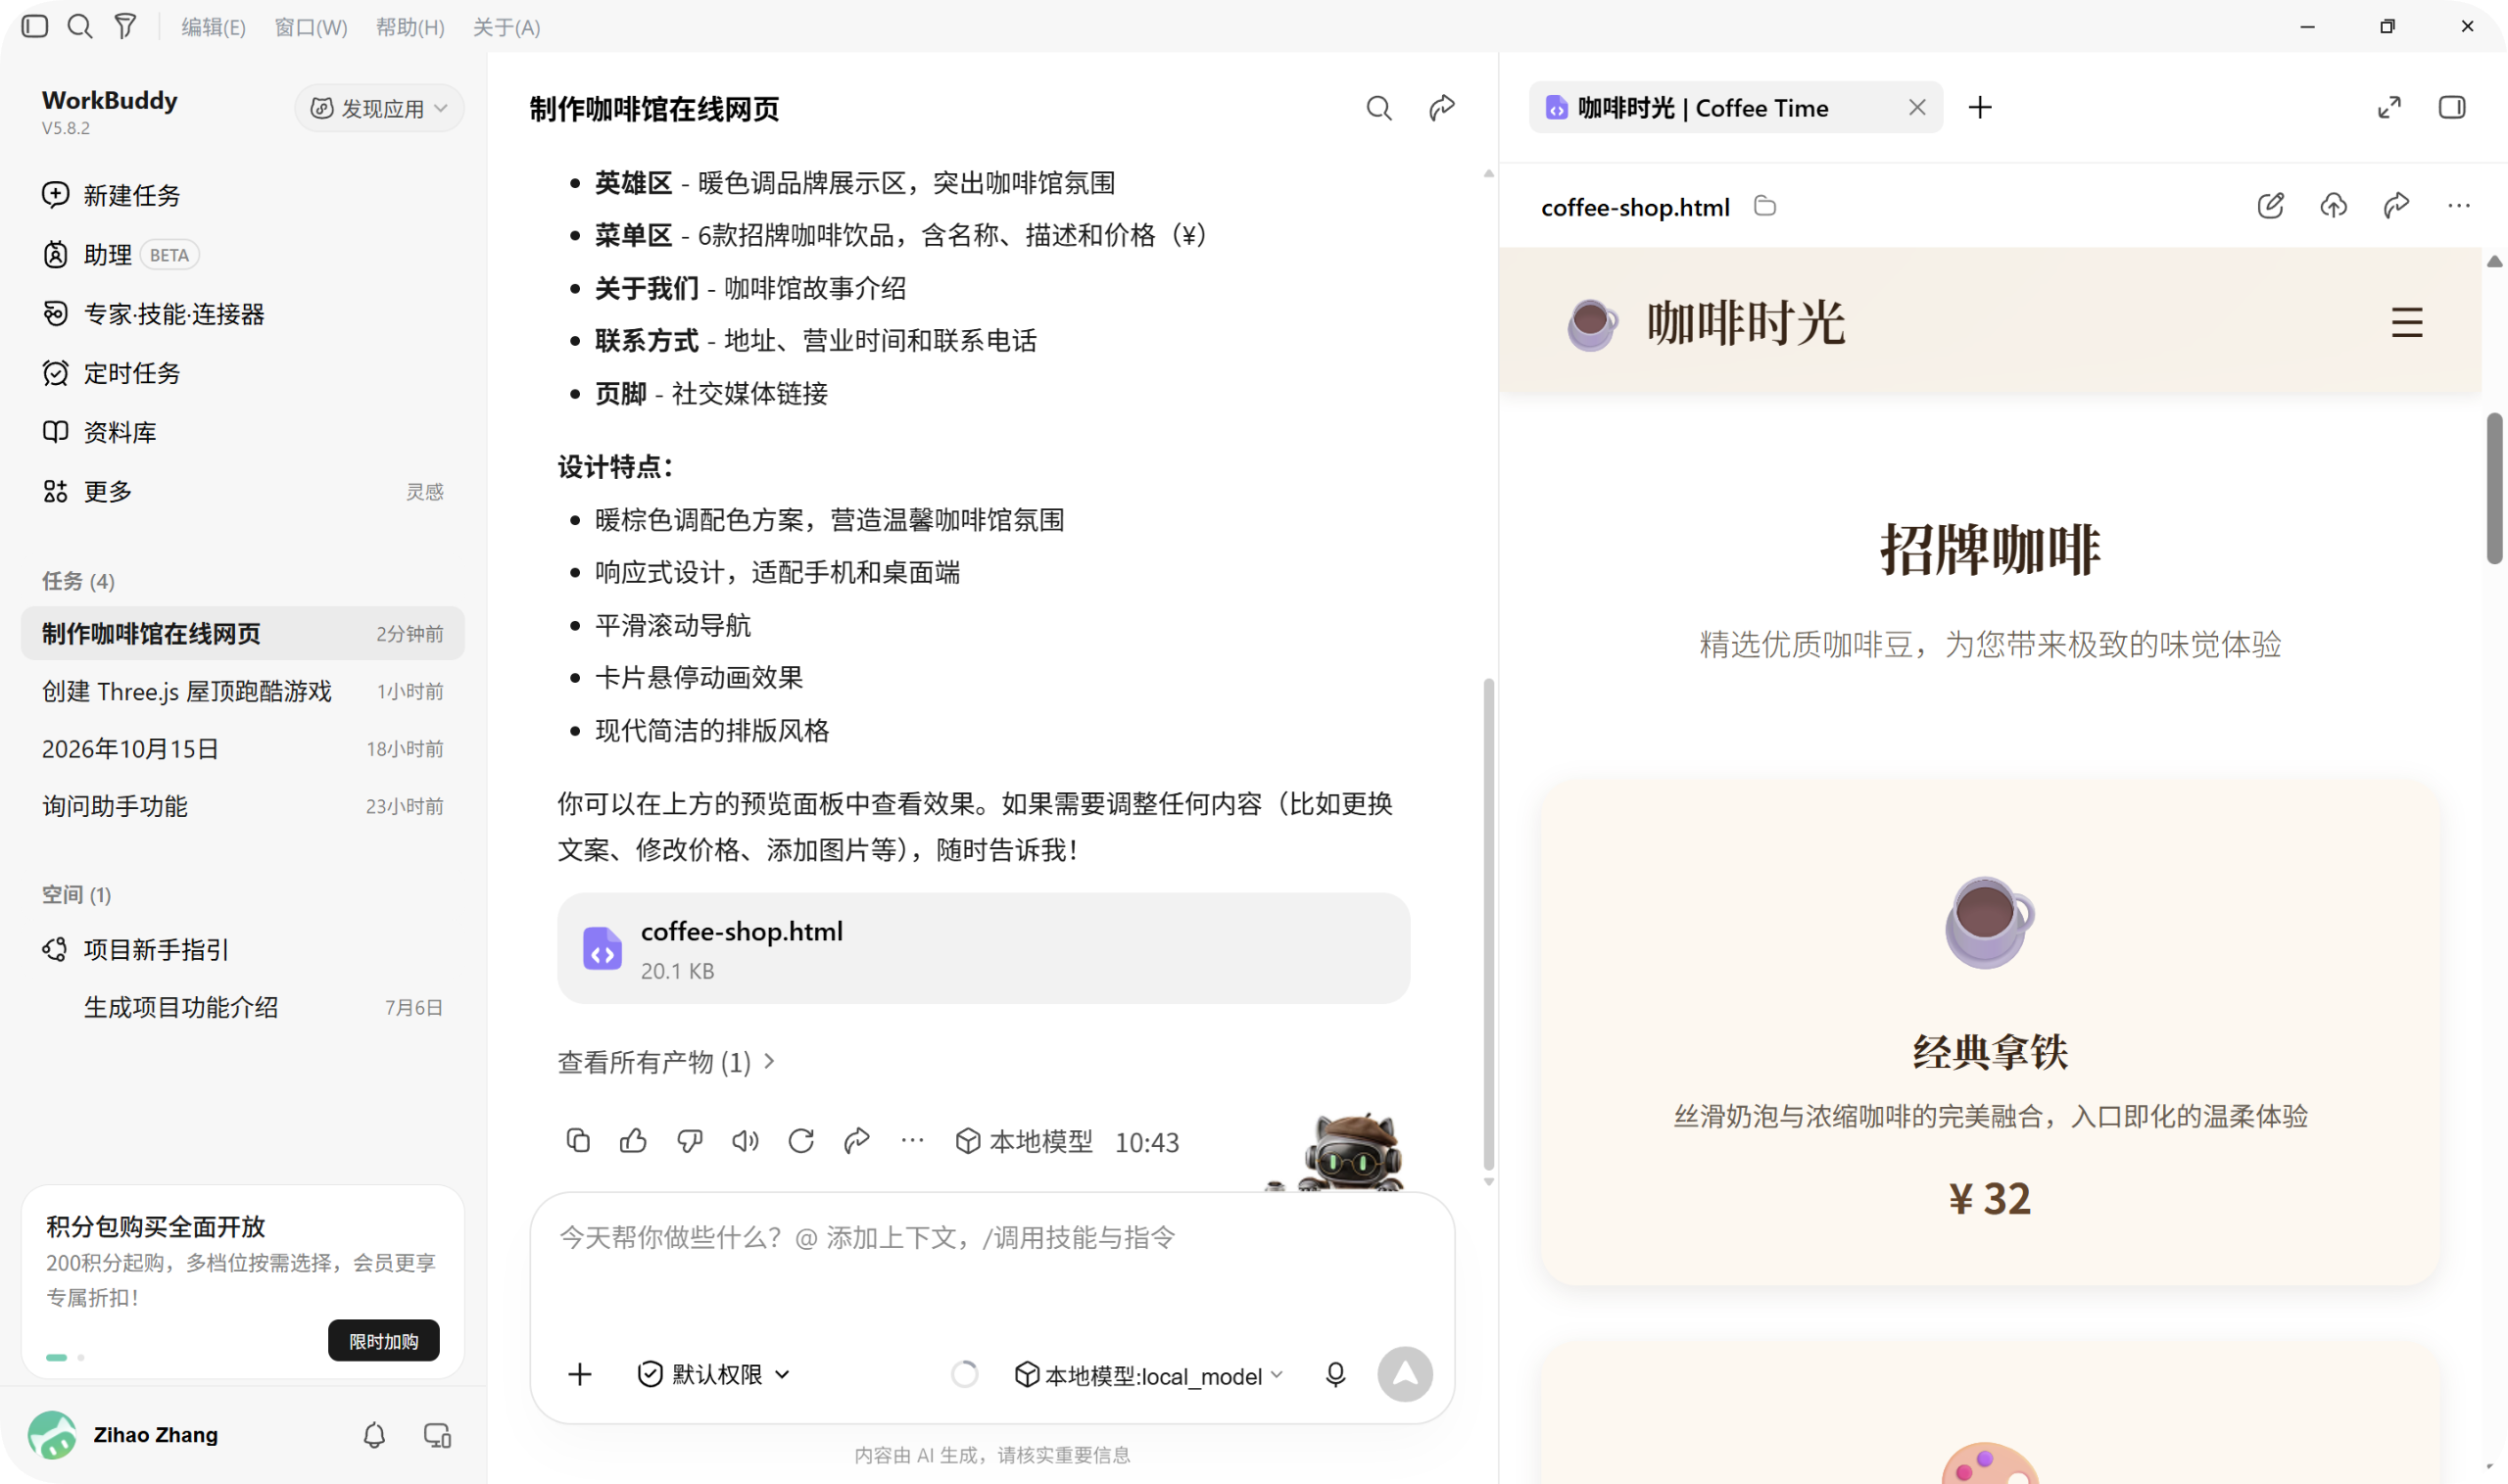
No futuro, com a cooperação entre software e hardware, e com a tendência atual de modelos de código aberto superando os de código fechado, além do desenvolvimento de modelos Flash mais rápidos e compactos, certamente haverá mais do que apenas este modelo local que poderá ser baixado diretamente no WorkBuddy.
Atualmente, também podemos carregar modelos locais baixados do LM Studio no WorkBuddy por meio da API de modelos locais do LM Studio.
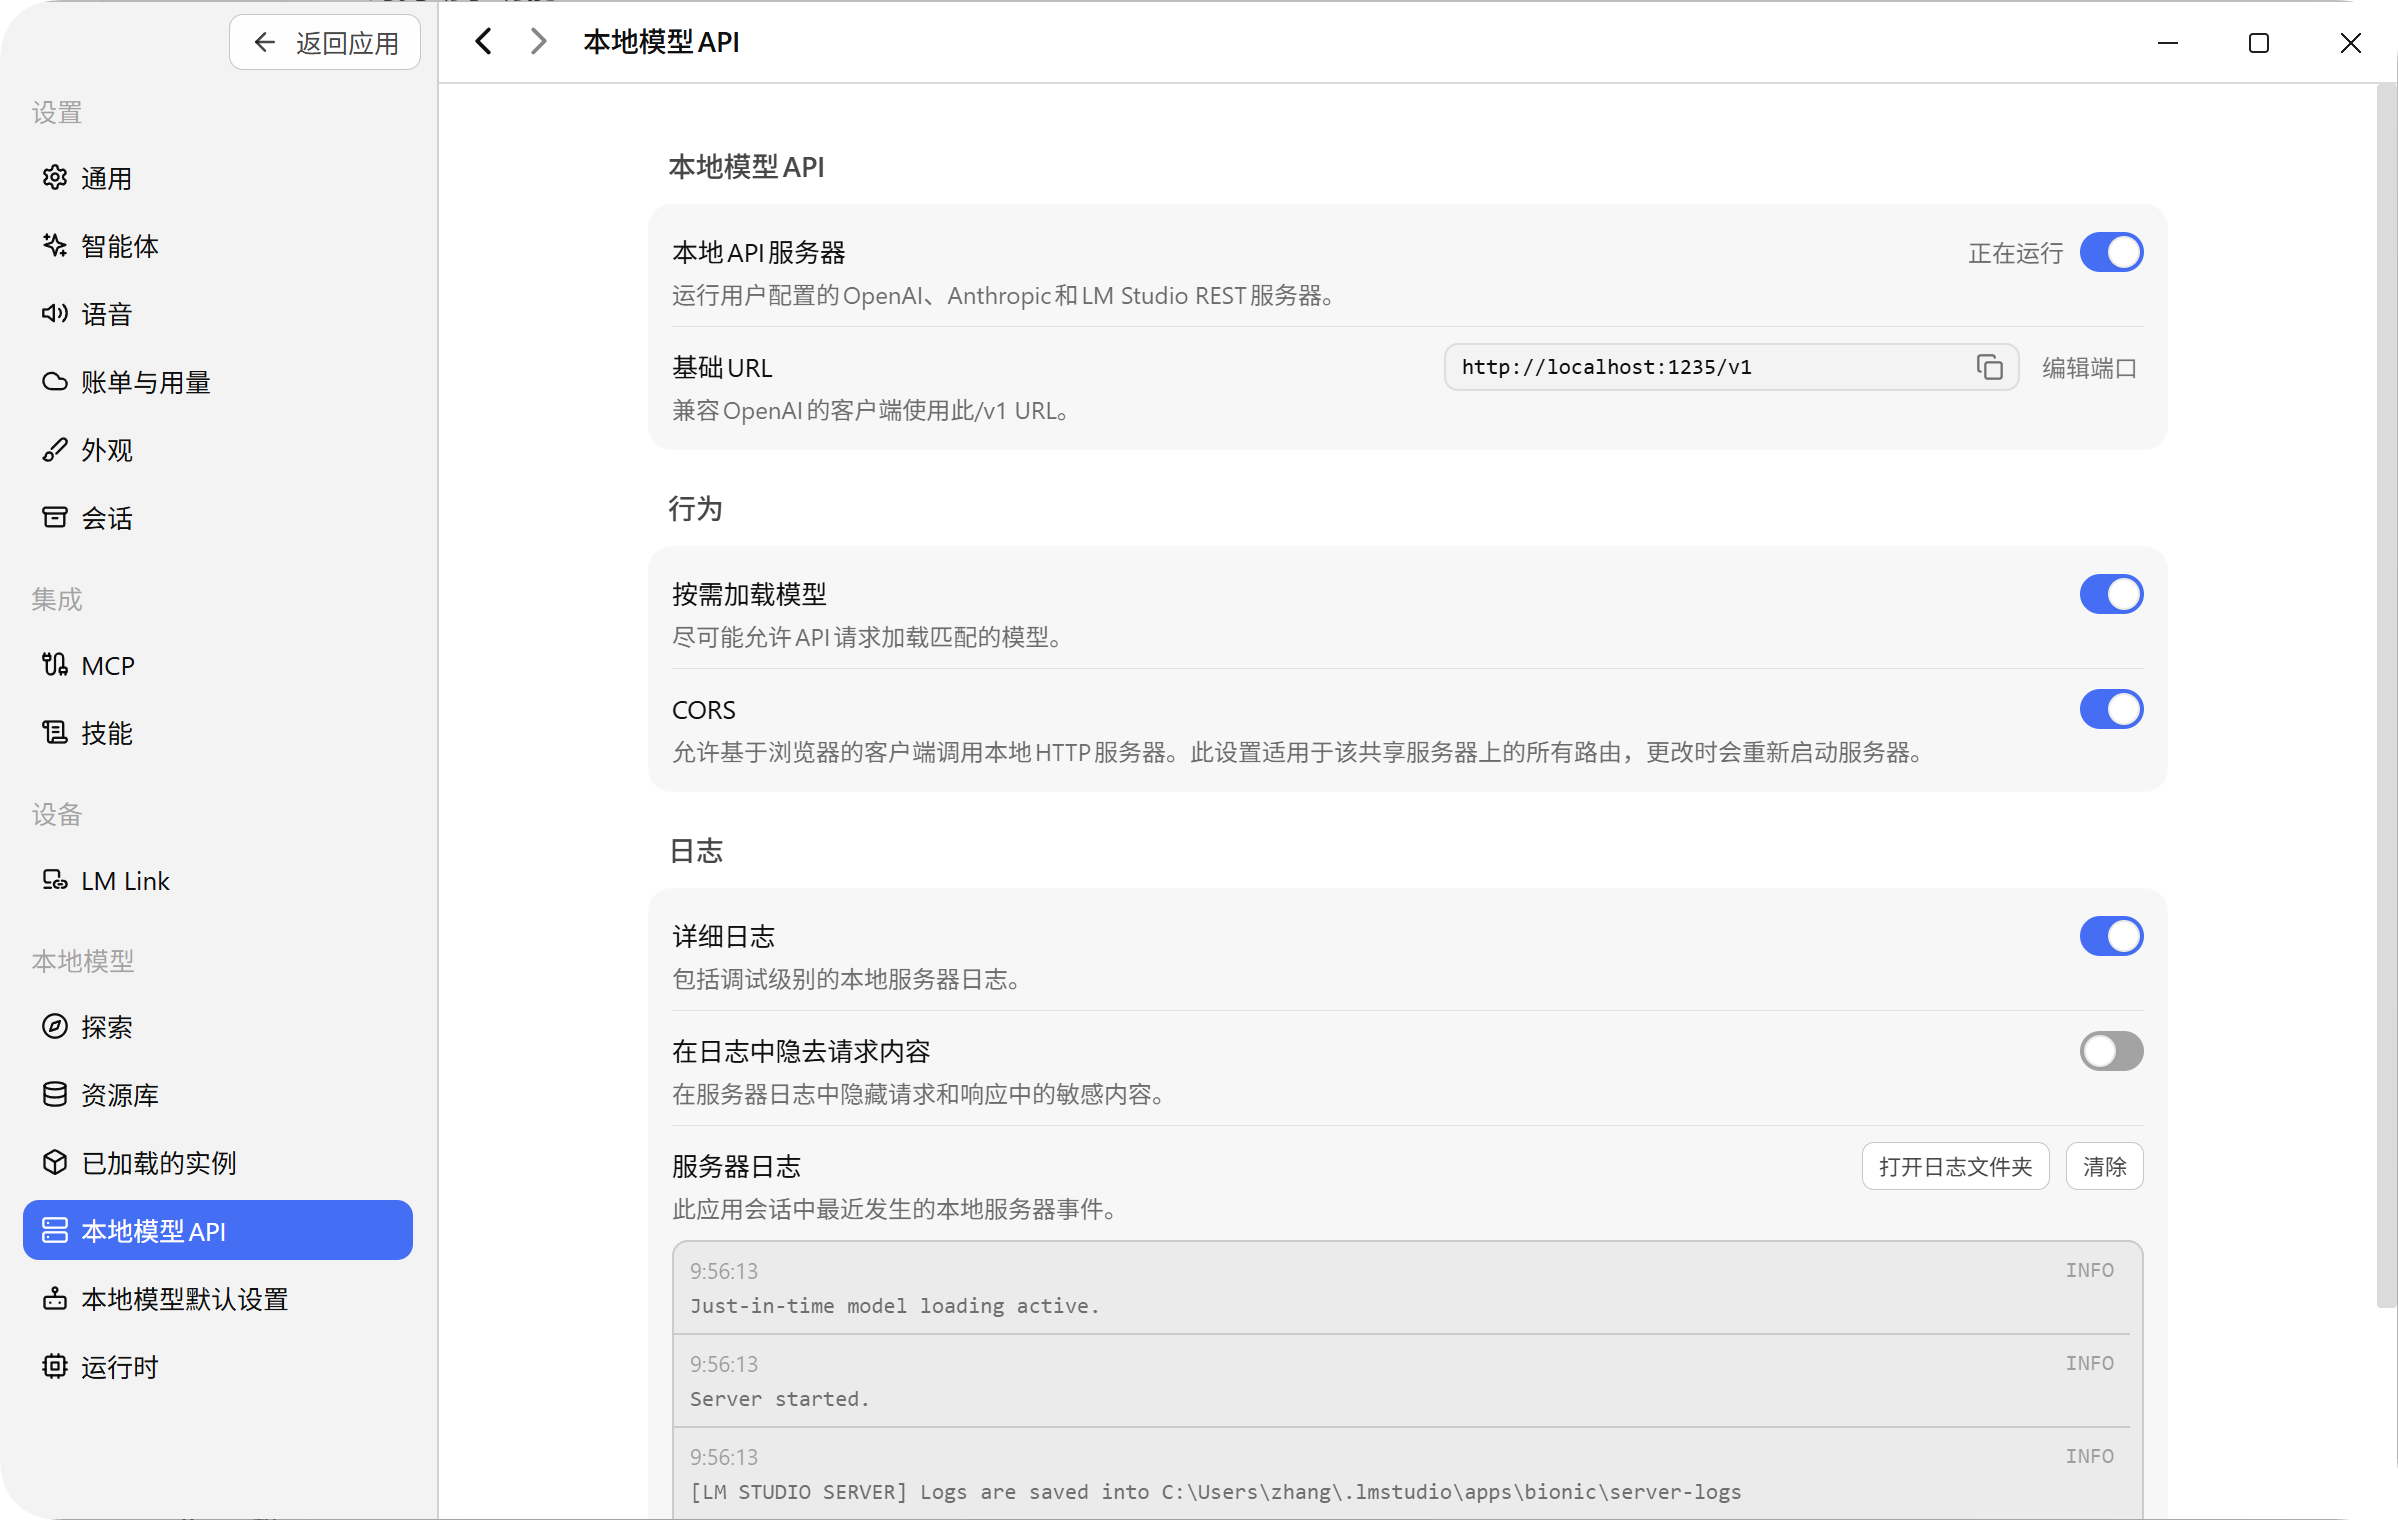
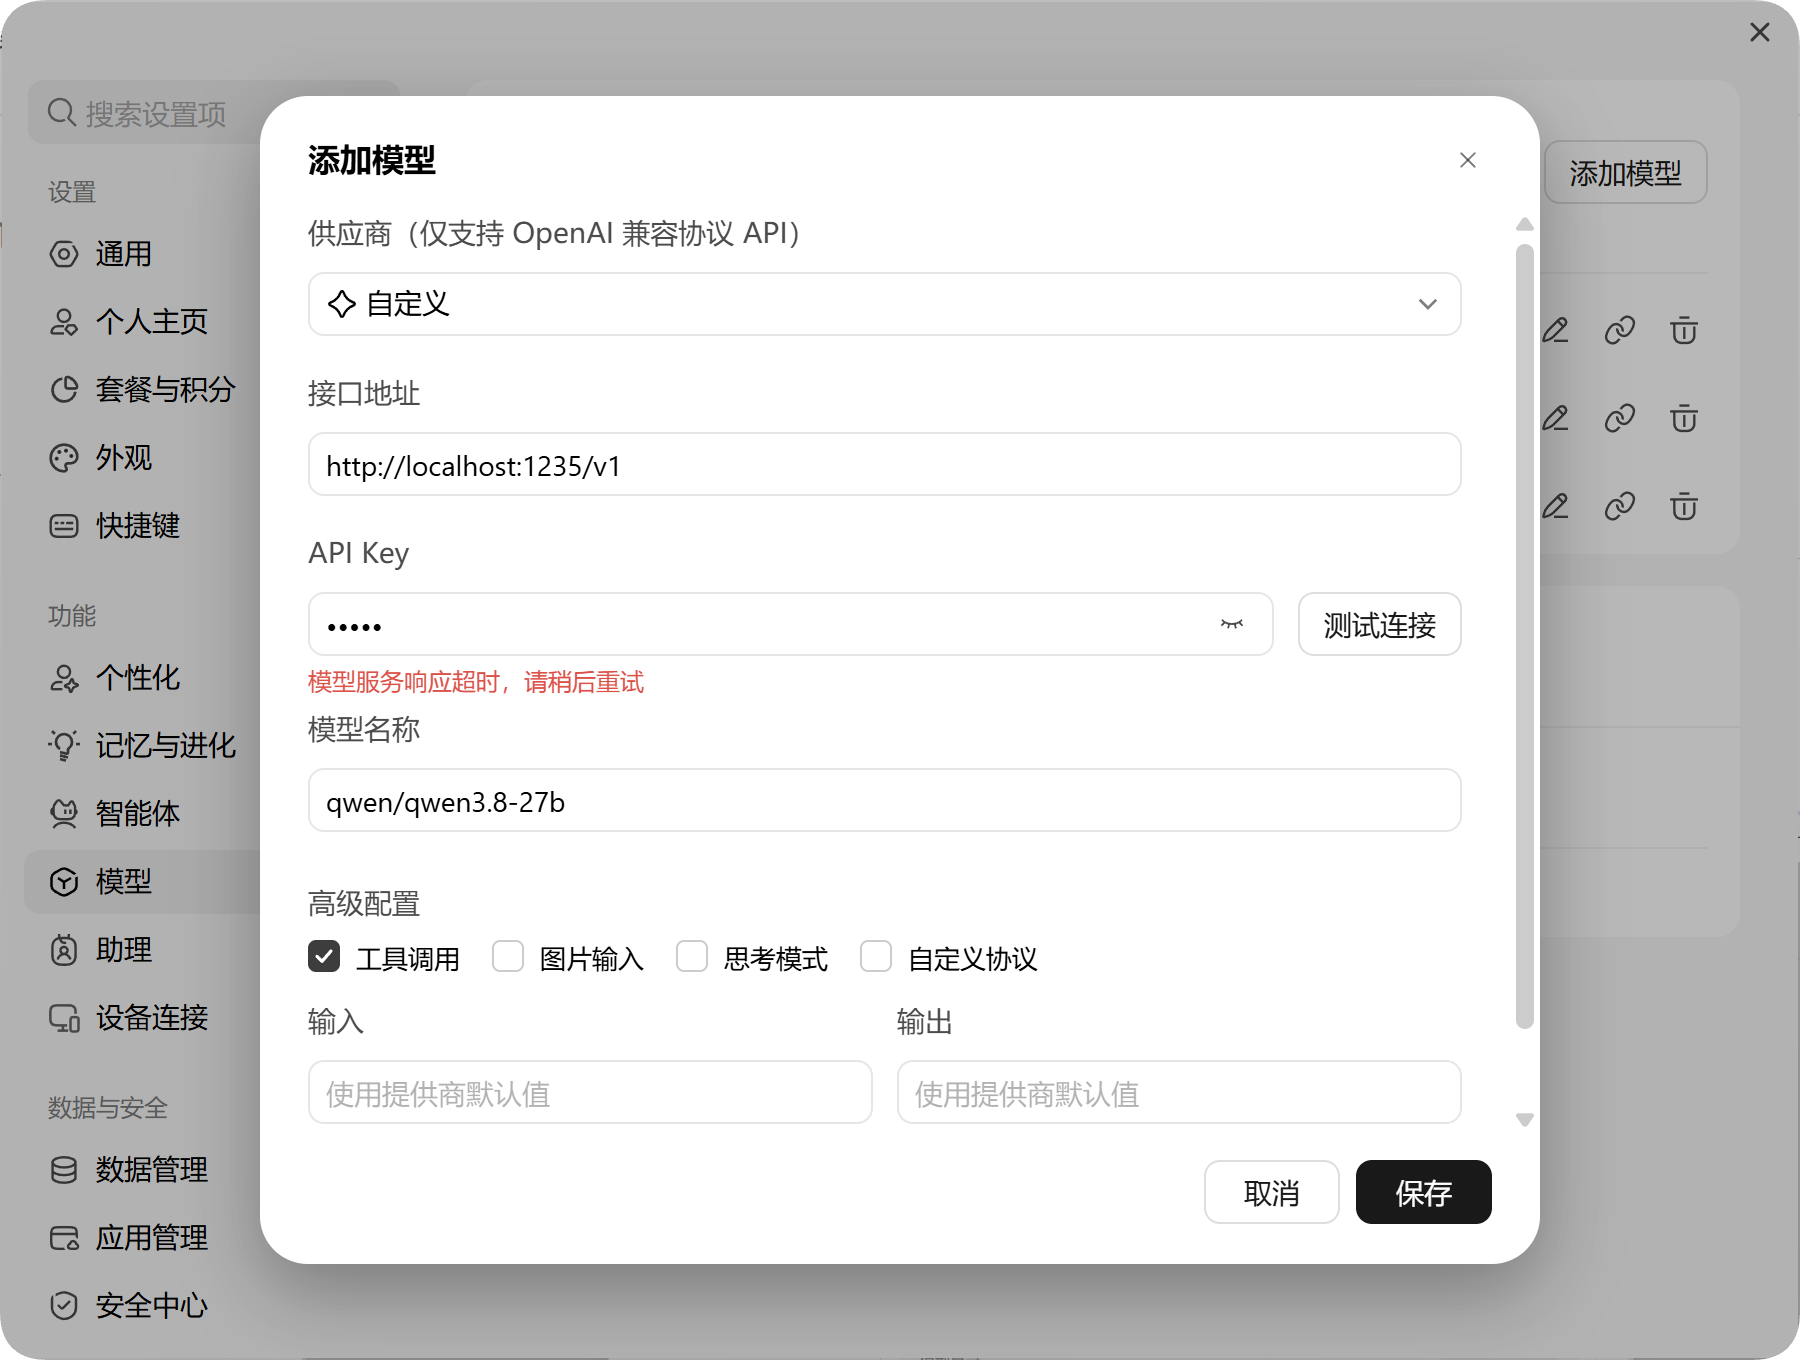
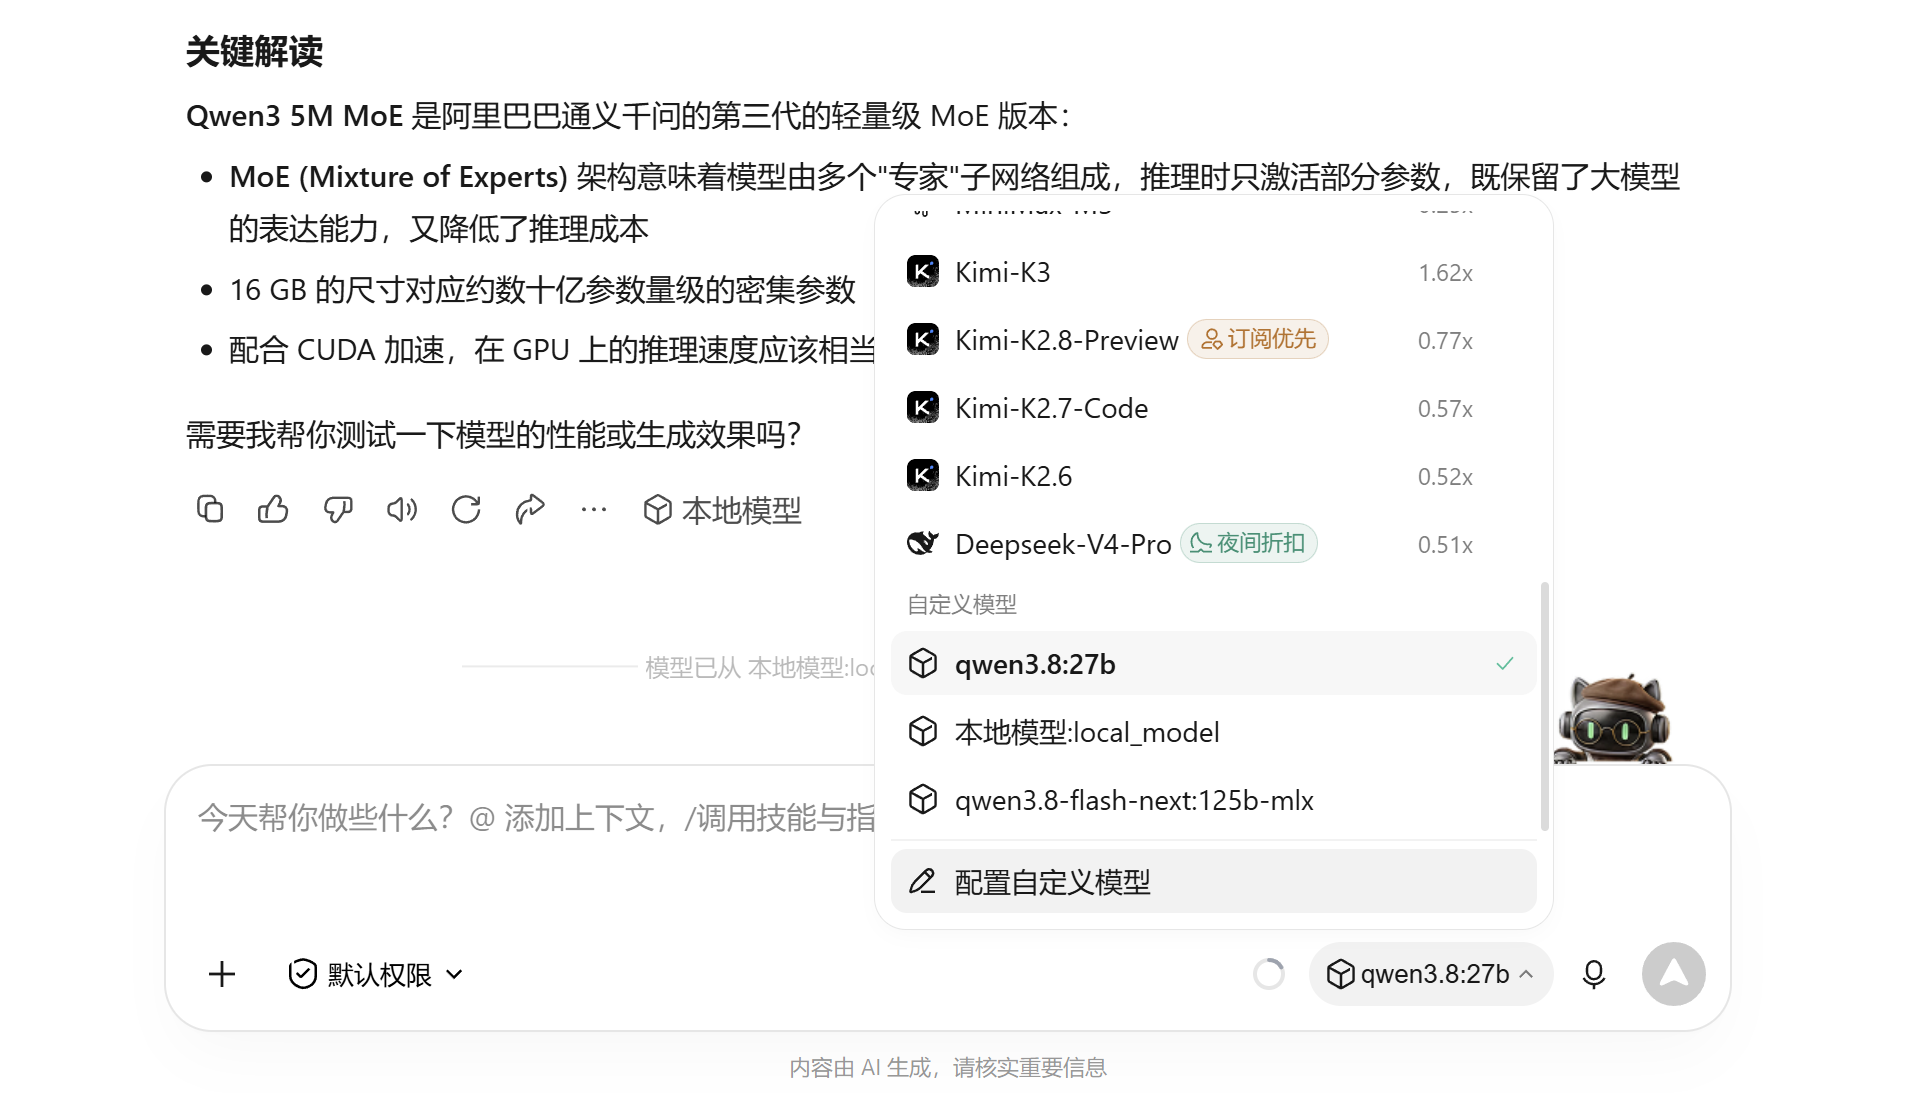
Após o carregamento bem-sucedido, o modelo personalizado correspondente será exibido no WorkBuddy.
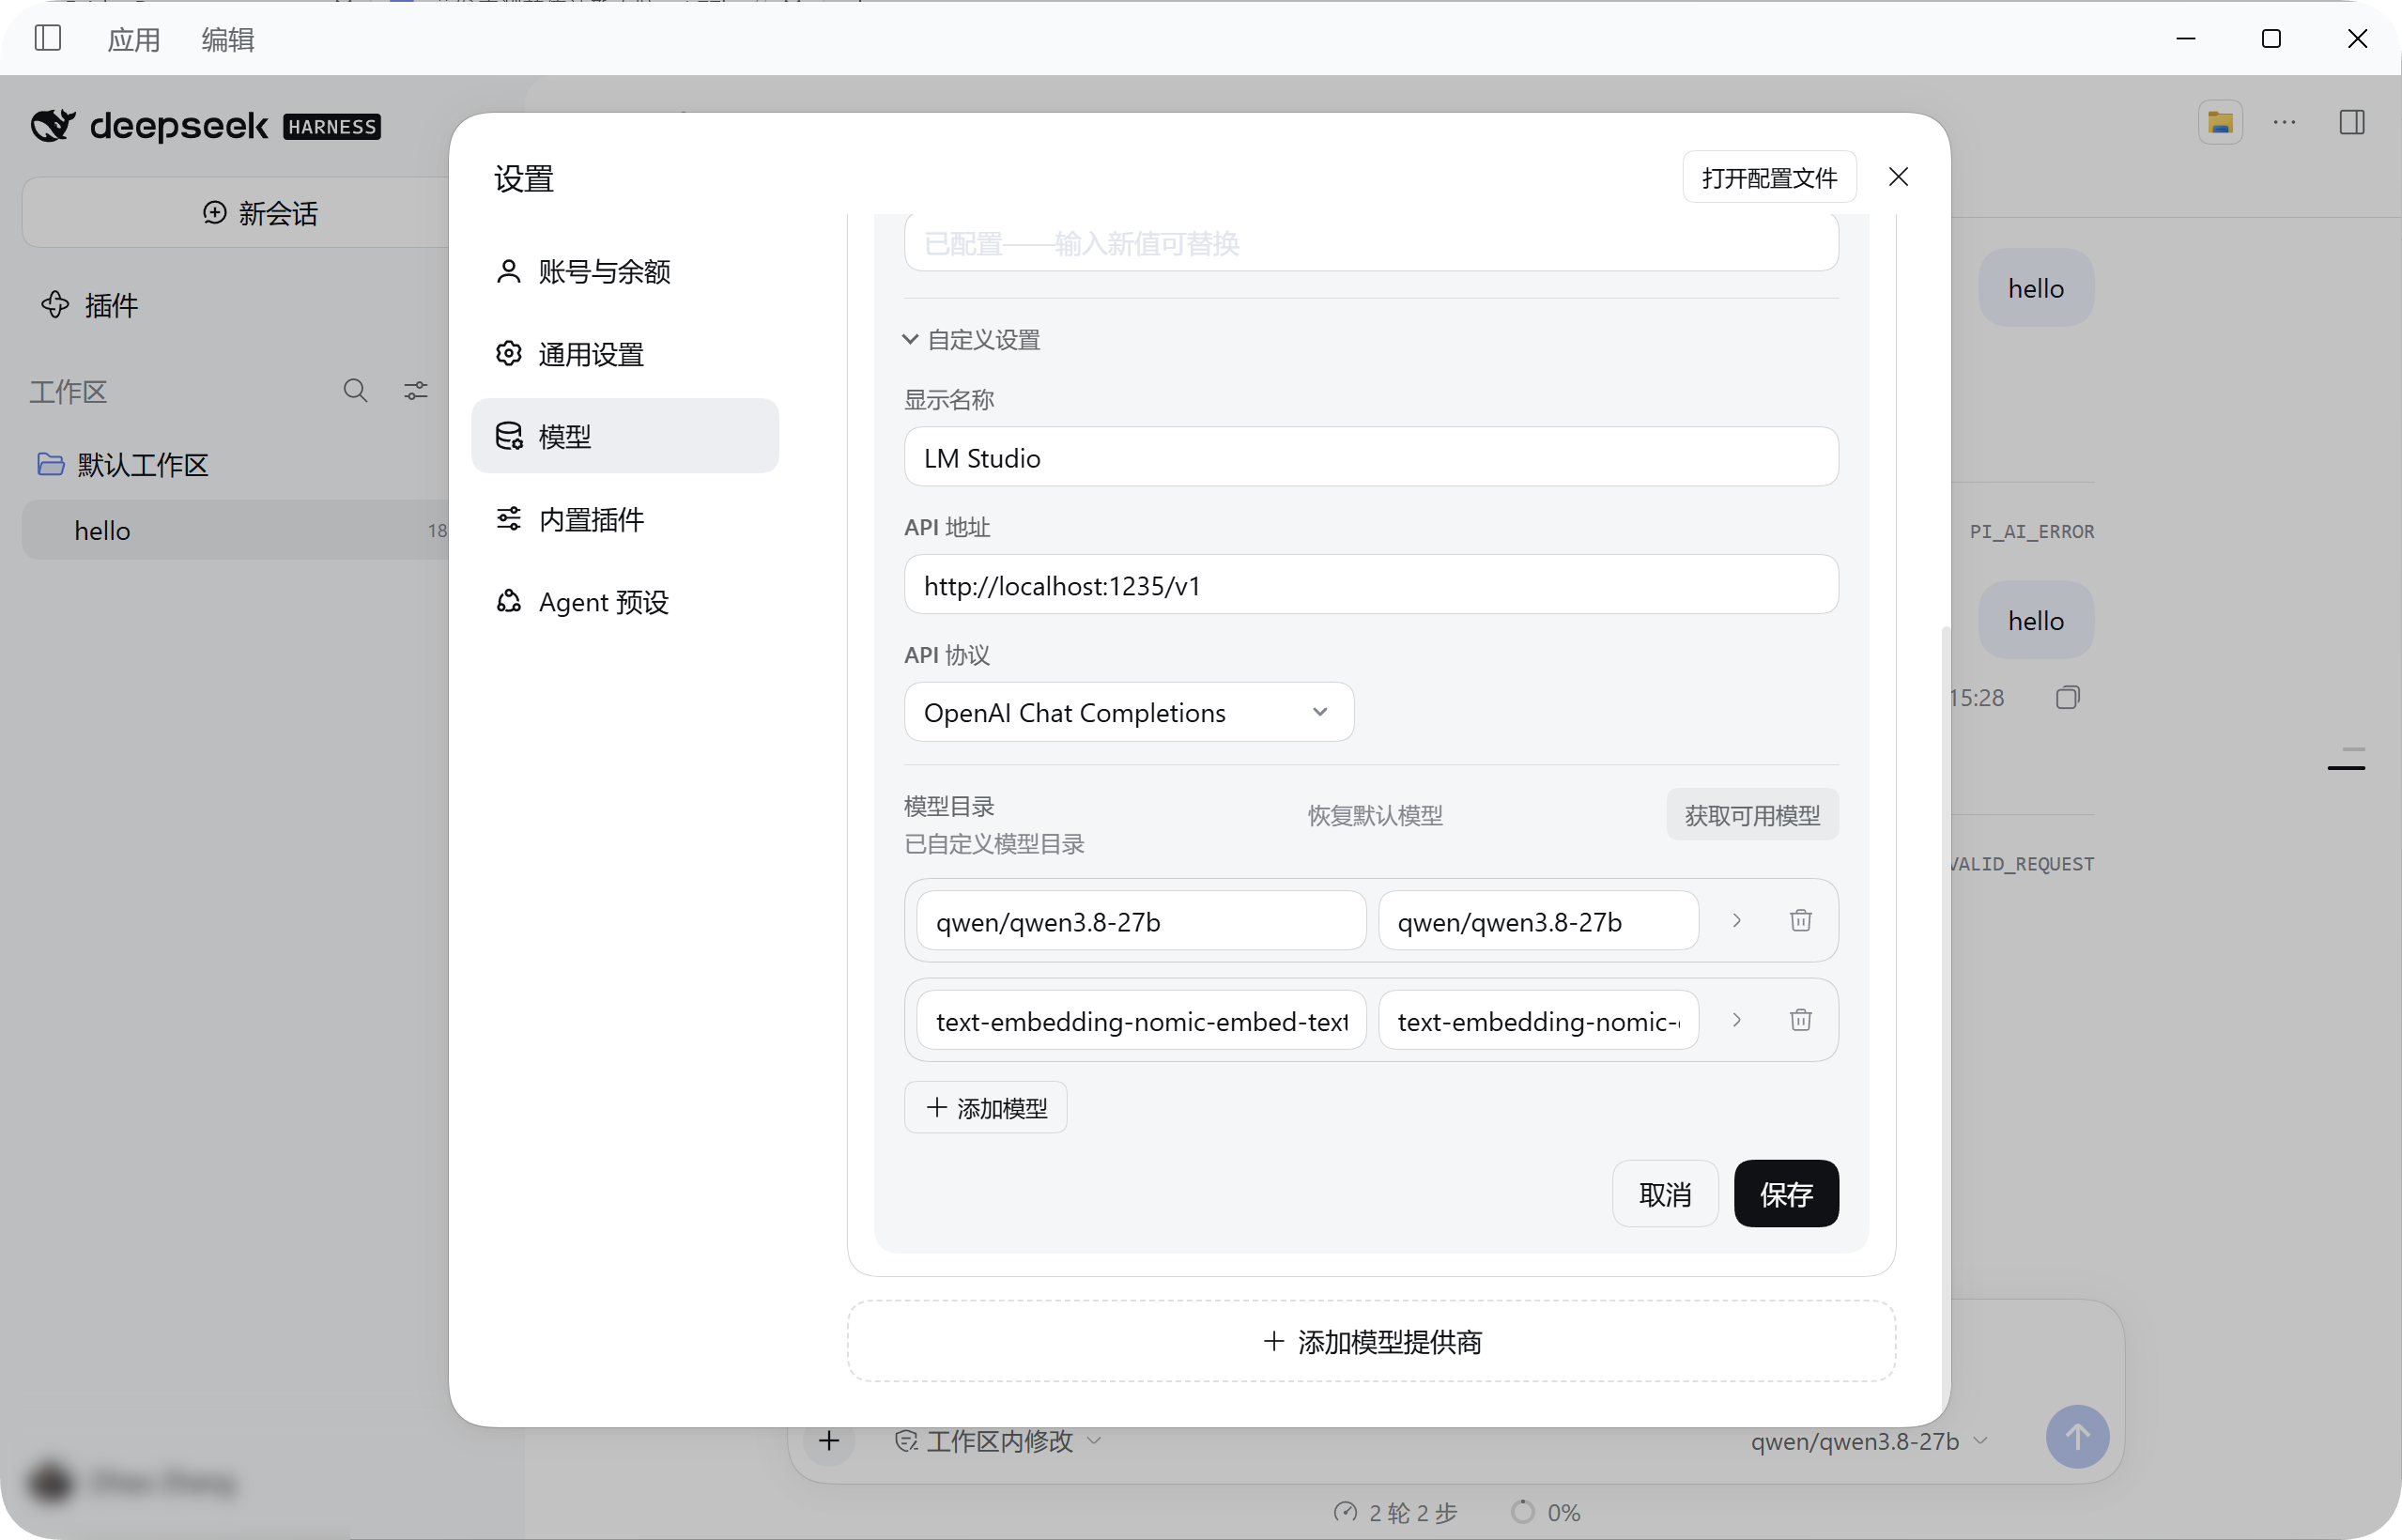
Você também pode carregar modelos locais em outras ferramentas do Harness que você usa com frequência, como o DeepSeek Harness, usando o mesmo método.
A capacidade de processamento é muito forte, e o Windows também está melhorando.
Se nossa experiência com o WorkBuddy nos faz pensar que usar IA local no Windows é bastante simples, então sempre existem vários problemas com o desenvolvimento para Windows.
É por isso também que os usuários dos três principais sistemas operacionais — Windows, Linux e macOS — frequentemente enfrentam esse problema. Por um lado , muitas ferramentas de desenvolvimento de código aberto foram originalmente criadas em torno de fluxos de trabalho Unix/Linux, como scripts Bash, Git, OpenSSL, compiladores e várias ferramentas de linha de comando, que muitas vezes usam métodos de chamada semelhantes em ambientes Linux/macOS.
Por outro lado, o Linux também enfrenta problemas de compatibilidade com drivers, bibliotecas do sistema e diferentes distribuições; o macOS também pode não possuir versões de pacotes Python compatíveis com Apple Silicon e pode exigir a instalação das Ferramentas de Linha de Comando do Xcode.
Felizmente, o que estamos vendo agora é que a Microsoft tem trabalhado para resolver esses problemas. Desde a atualização do Windows lançada há alguns dias até o projeto Microsoft Execution Containers (MXC) em andamento, é possível fornecer um ambiente operacional mais seguro e controlável para agentes de IA que realizam operações com arquivos e chamam ferramentas.
Com relação aos modelos locais, a Microsoft também anunciou suporte para o llama.cpp no Windows ML, permitindo que os desenvolvedores chamem mais modelos de código aberto por meio do ambiente de execução de IA do Windows.
Desde o WSL, que já oferece um ambiente de desenvolvimento Linux, até o Windows Terminal, o WinGet e as ferramentas de desenvolvimento nativas ARM64 em constante aprimoramento, o Windows agora é mais adequado para desenvolvedores do que nunca.
Enquanto isso, a experiência diária do usuário do Windows também está sendo atualizada. A nova versão da Pesquisa do Windows, além de buscar arquivos e aplicativos, também permite que o sistema execute operações correspondentes, eliminando a necessidade de acessar o menu de configurações para pesquisar item por item.
O Copilot também está se preparando para adicionar mais recursos locais. Com a permissão do usuário, ele poderá ler arquivos relevantes no computador, executar operações do sistema ou chamar modelos locais para concluir tarefas.
Então, será que a IA pode ser o motivo da próxima atualização de celulares?
Anteriormente, uma estação de trabalho de IA equipada com uma GPU NVIDIA de alta capacidade geralmente significava um host de tamanho considerável, uma placa gráfica dedicada e um ambiente de desktop que exigia energia contínua.
Agora, a NVIDIA colocou uma plataforma de computação capaz de executar grandes modelos locais e suportar CUDA em um laptop Windows que pesa menos de 1,8 kg.
Podemos levá-lo para o escritório, colocá-lo sobre uma mesa em uma cafeteria ou até mesmo desconectá-lo da tomada e deixar um modelo 27B continuar funcionando.
Mas este computador também expõe claramente outro lado da IA local nesta fase: o hardware já é capaz de executar modelos complexos, mas o software ainda não está totalmente pronto para ser usado facilmente por todos.
Produtos como o WorkBuddy estão reduzindo as barreiras de implantação, e mais agentes estão começando a usar o poder computacional local diretamente. Por outro lado, as compensações entre compatibilidade de software, recursos do modelo, desempenho e duração da bateria ainda afetarão a experiência final.
Portanto, se você precisa executar modelos locais, desenvolver aplicativos de IA ou lidar com dados que são inconvenientes de enviar para a nuvem todos os dias, esta geração de notebooks ASUS ProArt 16 RTX Spark oferece uma nova opção que vale a pena considerar.
No entanto, se você normalmente usa apenas ferramentas de IA baseadas em nuvem, como ChatGPT e Gemini, não há necessidade de trocar seu laptop apenas para executar um modelo grande localmente.
Atualmente, a tendência geral para computadores pessoais é em direção a maior memória, maior poder de processamento e mais inteligência artificial.
À medida que os agentes de IA se envolvem cada vez mais em nosso trabalho diário, o poder computacional dos computadores voltará a ser importante. Antes, talvez precisássemos apenas de um computador conectado à IA baseada em nuvem; no futuro, algumas tarefas poderão ser concluídas diretamente no computador.